 AI-Papers
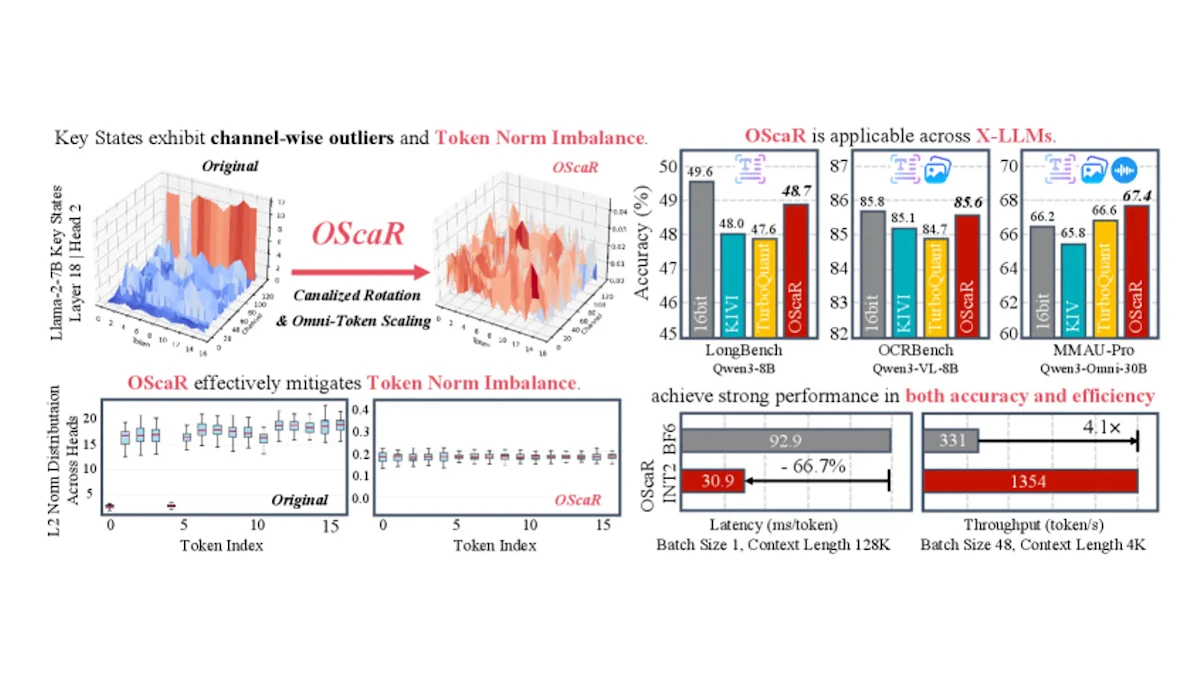
- KVキャッシュのトークン方向ノルム不均衡「Token Norm Imbalance(TNI)」を新たに定義し、2段階パイプラインで解決する軽量フレームワーク
- INT2量子化でBF16比デコード最大3.0倍高速・メモリ5.3倍削減・スループット4.1倍増加をほぼロスレスで達成
- テキスト専用・マルチモーダル・オムニモーダルLLMすべてに対応し、GitHubでコードを公開済み
研究の背景
大規模言語モデル(LLM)で長い文脈を扱う場合、最大のボトルネックとなるのがKV(Key-Value)キャッシュのメモリ消費です。コンテキストウィンドウが拡大するにつれ、過去のトークン(入力テキストを細かく分割した単位)の情報を保持するKVキャッシュも比例して膨張し、GPUメモリの大半を占有してしまいます。
この問題への対応として、KVキャッシュをINT4やINT2といった低ビット整数に量子化(数値を少ないビット数に圧縮する処理)する研究が進んでいます。しかし、2ビット量子化では精度の劣化が顕著になりやすく、その根本原因の解明と実用的な解決策の確立は依然として課題として残っていました。
TNIという根本課題の特定
本研究が着目したのは、チャンネル(次元方向)の偏りではなく、トークン方向のノルム不均衡です。著者らがLlama-3.1-8BやQwen3-8Bなどのモデルの内部表現を分析したところ、一部のトークンが他のトークンと比べて極端に小さいL2ノルム(ベクトルの大きさ)を持つことが明らかになりました。
この現象を著者らは「Token Norm Imbalance(TNI)」と命名しています。ノルムが極端に小さいトークンは「Attention Sink」と呼ばれる特殊なトークンに対応しており、モデルの注意機構(アテンション)が安定動作するために必要な存在です。ところが、このトークンが量子化の数値範囲(ダイナミックレンジ)を不必要に広げてしまい、他のトークンの量子化精度が低下するという悪影響を生んでいました。
既存の手法はチャンネル方向の外れ値対策に注力してきましたが、このトークン方向の不均衡を体系的に扱ったものはほとんどなく、2ビット量子化での精度劣化の一因となっていました。
OScaRの提案手法
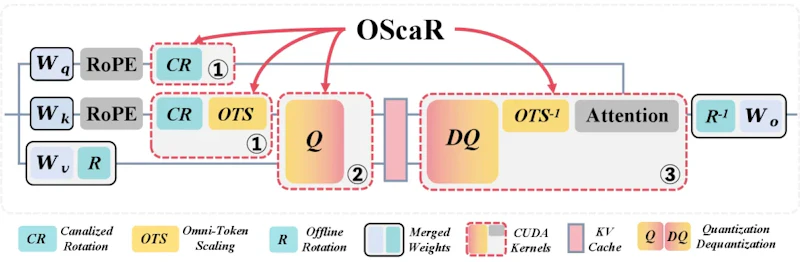
OScaR(Occam's Razor for KV Cache Quantization)は、TNIを最小限の処理ステップで解消する2段階のパイプラインです。
第1段階のCanalized Rotationでは、Hadamard変換(直交変換の一種)を適用して、チャンネル方向に存在する外れ値のエネルギーを全次元に均等に再分配します。ただし、この段階でトークンごとのスケーリングを先に行うと、変換後に人工的な外れ値が発生する「Scaling-Induced Outlier Artifact」が起きることを著者らは理論的に示しています。そのため、Rotationを先に行う順序が不可欠です。
第2段階のOmni-Token Scalingでは、各トークンのL2ノルムを計算し、トークン間のノルムを均一化するスケーリングを施します。Rotationを経た後であればこのスケーリングが新たな外れ値を生まないため、TNIを安全かつ効果的に解消できます。この2段階の変換に加え、最適化されたCUDAカーネルによって効率的なINT2量子化が実現されています。
実験結果
評価はテキスト専用LLM(Llama-3.1-8B、Qwen3-8B)、マルチモーダルLLM(Qwen3-VL-4B/8B-Instruct、LLaVA-v1.6-vicuna-7B)、オムニモーダルLLM(Qwen3-Omni-30B-A3B)という多様なモデル群で実施されました。
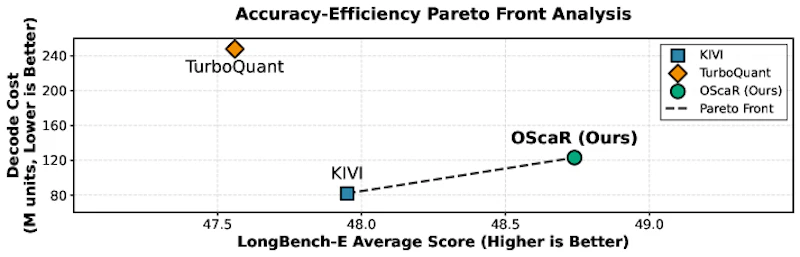
効率性の測定では、BF16精度のFlashDecoding-v2ベースラインを基準として、コンテキスト長8Kから128Kトークンの範囲でデコード速度とスループットを計測しています。128Kトークン時には単一バッチのデコード速度が最大3.0倍向上し、GPUメモリ消費が5.3倍削減、マルチバッチ処理のスループットが4.1倍増加しました。
精度面では、長文処理の総合ベンチマーク「LongBench-E」において、Llama-3.1-8BがINT2量子化ながら平均41.75%を達成しました。これはINT2手法の中で次点となるOTT(40.74%)とKIVI(39.84%)を上回り、2.5ビット使用のTurboQuant+(40.03%)も超える結果です。Qwen3-8Bでは48.74%と高い精度を維持しています。また、長文中の特定情報を検索するNeedle-in-a-Haystackタスクでは、16ビット精度の96.0%を上回る96.5%の検索精度を記録しました。
まとめと今後の展望
OScaRは「なぜINT2量子化が精度を損なうのか」という問いに正面から向き合い、TNIという新概念を整理したうえで最小限の処理で解決策を示しています。Rotation→Scalingの順序を厳守することで人工的な外れ値の発生を防ぐという設計は、先行研究との重要な差分です。
コードはGitHubで公開されており、テキスト・マルチモーダル・オムニモーダルの幅広いモデルファミリーで検証済みです。一方、短いコンテキスト長では量子化変換のオーバーヘッドが相対的に大きくなる可能性があります。長文処理が求められるエンタープライズ用途や、メモリ制約の厳しいエッジデバイスへの展開において、実用的な選択肢として今後の活用が期待されます。
論文情報: "OScaR: The Occam's Razor for Extreme KV Cache Quantization in LLMs and Beyond"(Zunhai Su et al., 2026) arXiv:2605.19660, CC BY-SA 4.0
本記事の図(図1、図4、図9)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


