 AI-Papers
- 2.6BパラメータのSANA-WMが単一H100 GPUで720p・60秒動画を生成し、8〜28Bの競合モデルに匹敵する映像品質を達成
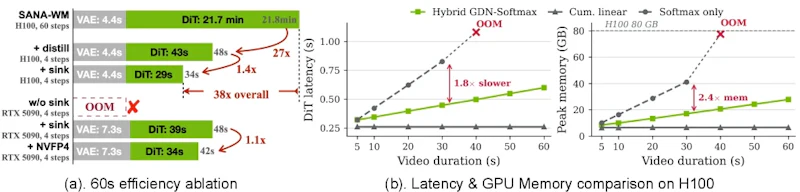
- GDNとSoftmaxのハイブリッドアテンションにより全Softmax構成比36倍のスループット向上を実現し、60秒生成時のメモリ不足も回避
- 二重分岐カメラ制御(UCPEとPlücker埋め込み)でカメラ回転誤差4.50°を記録し、Matrix-Game 3.0(12.96°)を大幅に上回るカメラ追従精度
研究の背景と目的
世界モデル(World Model)は、入力画像と操作指示から物理的に整合性のある映像を生成するAIシステムです。自動運転のシミュレーション、ゲームや拡張現実の背景生成、ロボット訓練データの作成など、幅広い応用分野で注目されています。
ただし、これまでの手法は長時間かつ高解像度の動画を生成するために膨大な計算資源を必要とし、研究者や開発者が実際に試せる環境は限られていました。
NVIDIAのSANA-WMは、この状況に対して正面から取り組んだモデルです。パラメータ数2.6Bという小さな規模でありながら、単一のH100 GPU上で720p・60秒の動画を推論できます。学習には64枚のH100で15日間を要しますが、推論時の効率は高く、NVlabs/SanaリポジトリでGitHub上にモデルの重みとコードが完全公開されています。
ハイブリッドアテンション機構
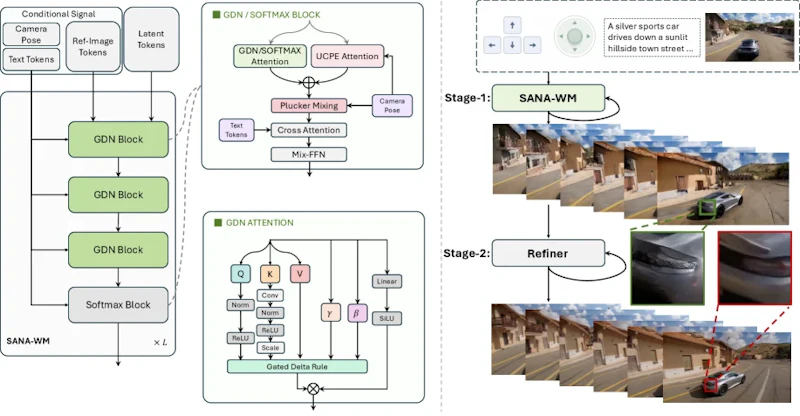
SANA-WMのアーキテクチャを支える中核が、GDN(Gated DeltaNet、ゲート付き差分ネット)とSoftmaxアテンションを組み合わせたハイブリッド構造です。20ブロック構成のモデルのうち、ブロック3・7・11・15・19の5箇所にSoftmaxアテンションブロックを配置し、残りをGDNブロックで構成しています。
GDNはフレームごとに再帰的な状態更新を行うため、長い動画を生成する際もメモリ使用量がほぼ一定に保たれます。Softmaxアテンションのほうは空間的な長期一貫性を維持する役割を担い、この組み合わせによって、すべてをSoftmaxアテンションで構成した場合に60秒生成時に発生するメモリ不足(OOM)を回避できます。
アブレーション実験でも、このハイブリッド構成が効率と品質のバランスにおいて最も優れることが確認されました。
二重分岐カメラ制御
世界モデルの実用性を高める鍵は、指定したカメラ軌跡への精密な追従です。SANA-WMは粗い制御と細かい制御を組み合わせた二重分岐アプローチでこの課題に対応しています。
粗い分岐では、UCPE(Unified Camera Positional Encoding、統合カメラ位置エンコーディング)を使用します。潜在フレームレートで動作し、カメラの内部パラメータとカメラから世界座標系への変換を用いて各トークンの光線情報を計算します。
細かい分岐が採用するのはPlücker埋め込みです。VAEの時間的ストライドより細かい元フレームレートで動作し、1つの潜在ストライド内の8フレーム分の光線情報を48チャンネルのテンソルにまとめることで、サブフレームレベルのカメラ動作を捉えます。
この設計の効果は数値に明確に現れています。カメラ回転誤差において、SANA-WMは単純な軌跡で4.50°、複雑な軌跡で8.34°を記録しました。Matrix-Game 3.0が12.96°であることを踏まえると、大幅な精度向上といえます。
データ構築パイプライン
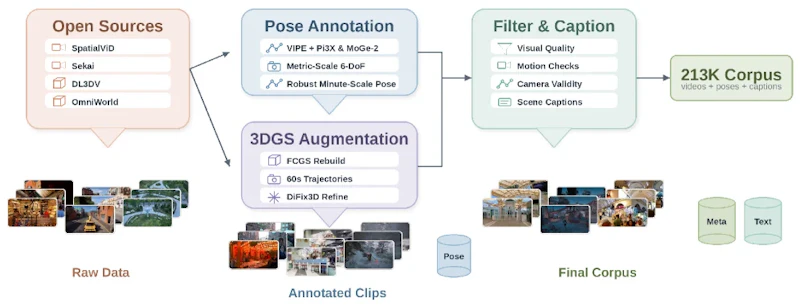
高品質な世界モデルの学習には、カメラポーズが正確にアノテーションされた動画データが欠かせません。SANA-WMの学習では、オープンソースの動画と3Dデータから構築した21万3,000クリップのコーパスを使用しています。
データ構築では、メトリックスケールの6自由度カメラポーズを既存動画から推定し、3D Gaussian Splatting(3DGS)でレンダリングした合成軌跡でデータを拡張しました。フィルタリングとキャプション付けを経て整備されたこのデータセットが、精密なカメラ制御の学習基盤となっています。
効率性と推論コスト
SANA-WMの推論効率は、従来手法と比べて際立っています。論文が報告する効率面の特徴は次の3点です。
- 単一のH100 GPU上で60秒・720pの動画を34秒で生成
- NVFP4量子化を適用するとRTX 5090でも動作
- 全ブロックをSoftmaxアテンションで構成した場合と比べて36倍のスループット
いずれも、長時間生成を一般的な単一GPU環境に収めるための要素になっています。
動画生成モデルの効率化手法に関心がある方は、AnyFlowとは?任意ステップ対応の動画拡散蒸留でテスト時スケーリングを実現する新手法も参考になります。
Refinerによる品質向上
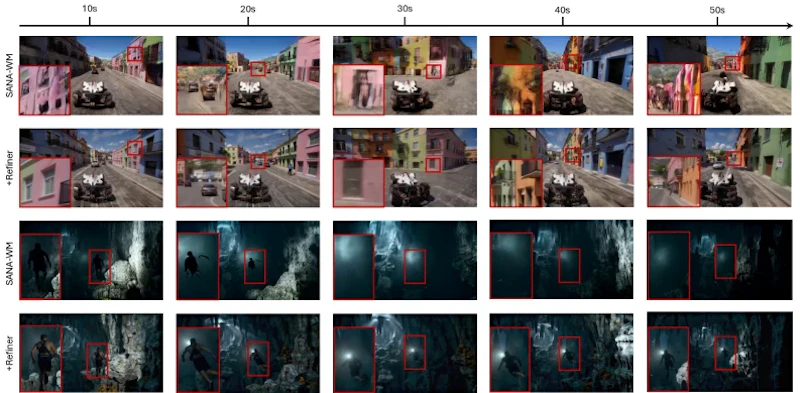
長時間動画の生成では、フレームが進むにつれて映像が劣化する傾向があります。SANA-WMはこれを補うため、17BパラメータのLTX-2モデルにLoRAアダプタを適用したRefinerを第2ステージとして組み込みました。
Refinerは打ち切りσFlow Matchingという手法で動作します。第1ステージで生成された潜在表現にノイズを加え、そこからより高品質な目標へと変換する速度を学習する仕組みです。参照フレームをキーとバリューのアンカーとして利用することで、外観の一貫性も維持されます。
その結果、VBench全体スコアではRefinerあり(80.62)がRefinerなし(74.74)を大きく上回りました。
性能比較と評価結果
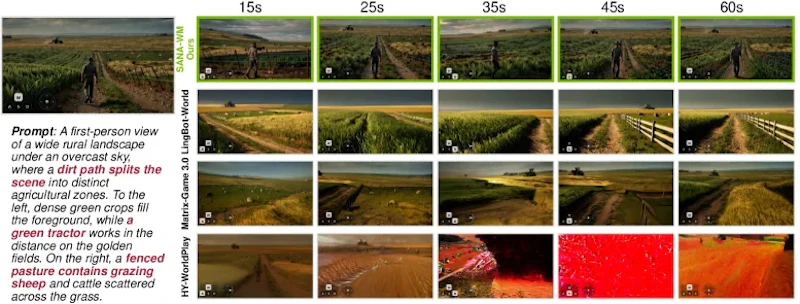
論文では、ゲーム・屋内・屋外(市街地・自然)の4カテゴリにわたる80枚の初期フレームを使った独自ベンチマークを構築し、単純軌跡と複雑軌跡の2種類の60秒シナリオで評価しています。単純軌跡におけるVBench映像品質スコアの比較は次の通りです。
モデル | パラメータ数 | VBench映像品質スコア |
|---|---|---|
SANA-WM(Refiner付き) | 2.6B | 80.62 |
LingBot-World | 28B | 81.82 |
Matrix-Game 3.0 | 5B | 78.53 |
HY-WorldPlay | 8B | 68.82 |
SANA-WMは、数倍から10倍のパラメータを持つモデルと競合する水準に達しています。
カメラ追従精度と映像品質の両立という観点でも、パラメータ規模に対して優れた費用対効果を示しました。一方、屋外の非構造化環境や急激な視点変化への汎化性能、またベンチマーク設計の汎用性については、今後の検証が求められます。
まとめ
SANA-WMは、「モデルを大きくせずに世界モデルの実用性を高める」という方向性を示した研究です。ハイブリッドアテンション機構による長時間生成の効率化と、二重分岐カメラ制御による高精度な軌跡追従を組み合わせ、2.6Bという手頃なパラメータ規模で実用的な性能を達成しました。
モデルの重みとコードは完全オープンソースで公開されているため、ロボット訓練・自動運転・XR開発といった応用分野でそのまま試せます。
論文情報: "SANA-WM: Efficient Minute-Scale World Modeling with Hybrid Linear Diffusion Transformer"(Haoyi Zhu et al., 2026) arXiv:2605.15178
本記事の図(図1、図2、図3、図5、図7、図8)は解説のため上記論文より引用しています。


