 AI-Papers
- 9.5万枚の100MP超高解像度画像に7次元アノテーションを付与したデータセット「PixVerve-95K」をオープンに公開
- 3つの学習スキームで既存T2I基盤モデルを超高解像度に拡張し、L2PフレームワークはDemoFusion比156倍の高速化を実現
- 視覚品質と意味整合性の8指標を備える評価ベンチ「PixVerve-Bench」が人間評価と高い整合性を確認
研究の背景と課題
テキストから画像を生成する技術(Text-to-Image、T2I)は、FLUXやStable Diffusionといったモデルの登場で急速に普及しました。しかし現行のT2Iモデルは多くの場合1K〜2K程度の解像度にとどまります。医療画像診断や高精細な商業デザイン、大判プリントといった分野が必要とする「超高解像度」の要件を、まだ満たせていません。
解像度を上げる試みはいくつか存在しましたが、主な障壁が2つあります。まず、100メガピクセル(約1億画素)以上の高品質な学習データがほぼ存在しないこと。次に、T2Iモデルが内部で使うAttention機構(画像の重要な部分に注目する仕組み)は計算量が解像度の2乗に比例して増えるため、超高解像度への拡張は計算コストの面で難しいことです。
PixVerveはこの両課題を正面から解決しようとした研究です。図1に示すとおり、データ・モデル・評価の3つを同時に整備した点が特徴になっています。
PixVerve-95Kデータセット
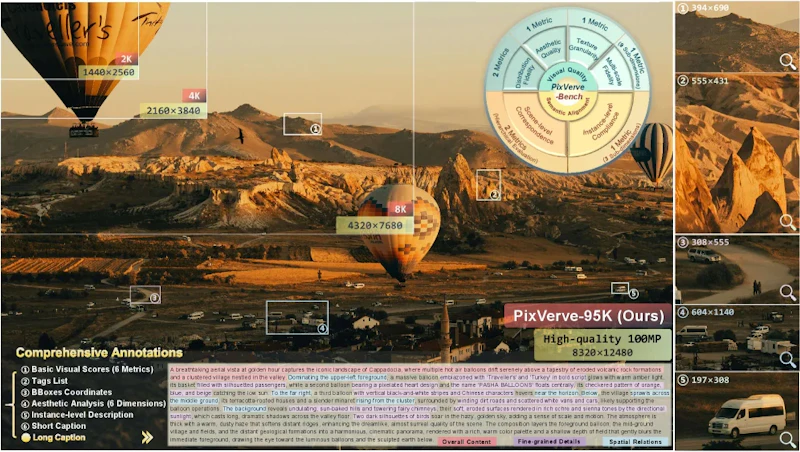
PixVerve-95Kは、95,735枚の超高解像度画像で構成されたデータセットです。すべての画像が100MP(10K解像度前後)以上であり、既存の4Kクラスのデータセットを解像度・アノテーション量ともに大きく上回ります。
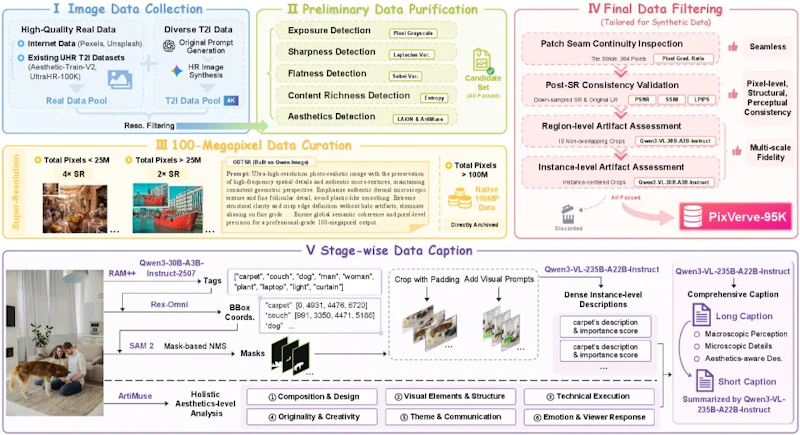
図2のとおり、データ構築は5段階のパイプラインで進みます。PexelsやUnsplashなどのストックフォトサービスから約30万枚の原画像を収集し、露出・シャープネス・エントロピーなど5種類の並行検出で品質の低い画像を除きます。
続いて2倍または4倍のスーパーレゾリューション(低い解像度の画像を高い解像度に引き上げる処理)で100MPにし、継ぎ目の連続性チェックや領域・インスタンス単位のアーティファクト検査で最終的な品質を確保しました。
各画像には7次元の詳細なアノテーションが付与されています。基本的な視覚スコア(露出・シャープネスなど)、オブジェクトタグと境界ボックス、6軸の美的分析(構図・視覚要素・技術的精度・独自性・テーマ・感情)、インスタンスレベルの説明、平均234.1語の長文キャプション、そして簡潔な短文キャプションです。この豊富なアノテーションが、後述する評価ベンチとの連携を支えます。
3つの学習スキーム
既存のT2I基盤モデルを100MP生成に拡張するため、PixVerveは3種類の学習スキームを提案し、比較しています。それぞれの手法と計算コスト、課題は次の表のとおりです。
スキーム | 手法 | 計算コストと速度 | 課題 |
|---|---|---|---|
I(全Attention Fine-tuning) | 既存モデルを全パラメータまたはLoRA(一部のパラメータだけを追加で学習する方式)で直接ファインチューニング | 4K解像度の学習だけで2万GPU時間以上、推論に8GPU | 100MPへの対応は実用上困難 |
II(Window-Attention改造) | モデル内部のJoint Attentionをウィンドウ単位の局所Attentionに置き換え | 推論速度が約30%向上 | 解像度が上がるにつれて生成品質が低下 |
III(L2P、パッチベース Pixel Diffusion) | 大きなパッチで全体構造を把握し、軽量なヘッドで局所的な細部を精緻化 | 単一GPUで推論可能、処理時間は58〜88秒 | 局所的な細部の再現性に改善の余地 |
スキームIは事前学習済みモデルのセマンティック情報(画像の意味に関する情報)を最大限に保てる利点があり、スキームIIは計算量を大幅に削減できます。ただし、どちらも100MP生成にはそのまま使えません。
残るスキームIIIのL2Pは、100MP生成に最も現実的なアプローチとして評価されています。従来手法のDemoFusionと比較して156倍の高速化という値は、学習不要の既存手法であるDemoFusionで同じ超高解像度生成を行った場合との処理時間の比で、L2P側が58〜88秒にあたります。
PixVerve-Benchの評価体系
超高解像度T2I生成には、FIDやCLIPScoreといった従来の評価指標だけでは不十分です。PixVerve-Benchは、視覚品質と意味整合性を合わせた8つの指標で総合評価できるベンチマーク体系で、内訳は次の表のように4指標ずつに分かれます。
区分 | 指標 | 測るもの |
|---|---|---|
視覚品質 | FID / FID_patch | 生成画像と実画像の分布の一致度 |
視覚品質 | LAION Aesthetic Predictor | 知覚的な美しさ |
視覚品質 | GLCMスコア | テクスチャの豊かさ |
視覚品質 | MSFI | 構造的整合性・視点の正確さ・照明・色調など9つのサブ次元 |
意味整合性 | CLIPスコア(シーンレベル) | 短文キャプションとの一致 |
意味整合性 | FG-CLIP2スコア | 長文キャプションとの細粒度な意味一致 |
意味整合性 | 視覚要素の存在確認 | 指定された視覚要素が描かれているか |
意味整合性 | ICS | インスタンスの見た目や空間関係を階層的に評価 |
このうちMSFI(Multi-scale Fidelity Index)は、MLLM(大規模マルチモーダル言語モデル)が9つのサブ次元を採点する指標です。ICS(Instance-centric Compliance Score)は、画像に写る個々のインスタンスを単位に意味の合致を積み上げます。
人間の好みによる評価との照合実験では、このMSFIとICSのランキングが人間の評価とよく一致しました。
実験結果
4K解像度での定量比較では、スキームI(LoRA)がFID_patch(40.433)と意味整合性(ICS 8.420)で優れた結果を示しました。図3のとおり、4Kの生成画像を並べると、細部の再現性やテクスチャ品質に手法ごとの差が見て取れます。
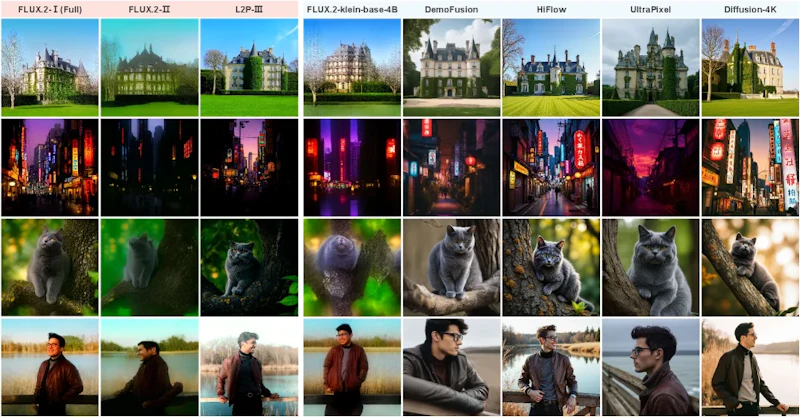
8K〜10K解像度になると、スキームIのモデルは性能が極端に低下し、比較に使える数値は示されていません。これに対しL2P(スキームIII)は8KでFID 134.635、10KでFID 159.212を維持しており、解像度を上げても性能を保てる度合いで明確な優位に立ちます。
アブレーション実験(構成要素を外して効き目を確かめる実験)では、長文キャプションの活用が全モデルで生成品質を一貫して改善することも確認されました。学習不要のベースライン(DemoFusionやLinFusion)はFID_patchでは競争力があるものの、意味整合性の指標では大きく劣ります。視覚基盤モデルを活用した高精度画像生成トークナイザー「VFMTok」など、画像生成の効率化を目指す研究との組み合わせも考えられます。
まとめと今後の展望
PixVerveは、100MPというこれまでのT2I研究が踏み込んでいなかった解像度領域に取り組んだ研究です。PixVerve-95Kデータセット、3種類の学習スキーム、8指標の評価ベンチをセットで提供し、超高解像度T2I研究のための基盤を整えました。
現状では、L2Pアプローチでも局所的な細部の再現性に改善の余地が残されており、解像度と品質のトレードオフをさらに縮める研究が求められます。一方で医療画像診断、高精細な衛星写真解析、大判プリント向けデザイン生成など、100MP以上の解像度が実用上必要な領域での活用は現実味を帯びてきました。データセットとベンチマークがオープンに公開されているため、後続研究の加速も見込めます。
論文情報: "PixVerve: Advancing Native UHR Image Generation to 100MP with a Large-Scale High-Quality Dataset"(Haojun Chen et al., 2026) arXiv:2605.20147
本記事の図(図1〜図3)は解説のため上記論文より引用しています。

