 AI-Papers
- コンテキストウィンドウはLLMが一度に参照できる「作業記憶」で、トークン単位で容量が決まる
- ウィンドウが満杯になるとFIFO方式で古い情報が消え、「Lost in the Middle」問題も起きやすい
- 1Mトークン超えモデルが登場した今も、KVキャッシュ・RAGとの組み合わせで賢く使うことが重要
コンテキストウィンドウとは何か
ChatGPTやClaude、Geminiといった大規模言語モデル(Large Language Model、LLM)を使っていると、「長い文章を貼り付けたら途中が切れた」「長い会話の冒頭を忘れてしまった」という経験をしたことがあるかもしれません。この現象の根本にあるのがコンテキストウィンドウという概念です。
コンテキストウィンドウとは、LLMが1回の推論で参照できる文章の範囲のことです。人間で言えば「作業記憶(ワーキングメモリ)」に近く、モデルはこの範囲内にある情報をもとに回答を生成します。範囲を超えた情報は参照できません。
容量の単位はトークン(token)です。トークンとは、LLMがテキストを処理する最小単位で、英語では1単語がおよそ1〜2トークン、日本語では1文字が1〜2トークンに相当します。「こんにちは」は約5〜6トークン、英語の"Hello"は約1〜2トークンです。
コンテキストウィンドウの容量推移
LLMのコンテキストウィンドウは、モデルの世代とともに急速に拡大してきました。2020年代初頭のGPT-3は約4,000トークンが上限でしたが、2024〜2025年にかけてGemini 1.5 Proが100万トークン(1M tokens)、Gemini 1.5 Ultraが200万トークンに到達しています。Claudeシリーズも200Kトークンを誇り、GPT-4oは128Kトークンに対応しています。
1Mトークンとはどの程度の量でしょうか。英語のペーパーバック小説が1冊あたりおよそ10万単語、日本語の文庫本が約10万字とすると、1Mトークンは文庫本10〜15冊分に相当します。数時間の音声書き起こし、数百ページのPDFドキュメント、数千件のログファイルを一度に処理できる計算です。
モデル | コンテキストウィンドウ | 目安(日本語) |
|---|---|---|
GPT-3(初期) | 4,096トークン | 文庫本 1/30 程度 |
GPT-4o | 128,000トークン | 文庫本 約1冊 |
Claude 3.7 Sonnet | 200,000トークン | 文庫本 約2冊 |
Gemini 1.5 Pro | 1,000,000トークン | 文庫本 約10冊 |
Gemini 1.5 Ultra | 2,000,000トークン | 文庫本 約20冊 |
コンテキストウィンドウの中身はどう構成されるか
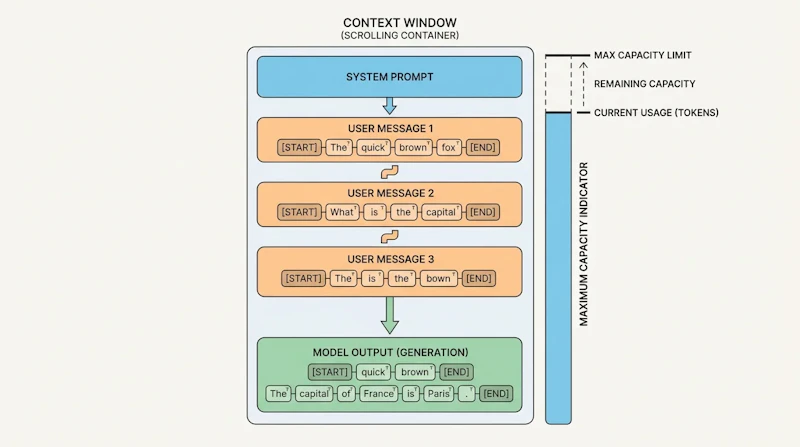
LLMへの入力は、単純に「ユーザーのメッセージ」だけではありません。コンテキストウィンドウには以下のすべてが合算されます。
- システムプロンプト:AIアシスタントの役割や振る舞いを定義する指示文
- 会話履歴:これまでのユーザーの発言とモデルの返答
- RAGで検索・注入されたドキュメント:外部知識ベースから取得した関連文書
- モデルの出力トークン:生成した回答も容量にカウントされる
つまり、同じモデルを使っていても、システムプロンプトが長いほど、会話が続くほど、注入するドキュメントが多いほど、実際に使える「残り容量」は少なくなります。AWSのブログで指摘されているように、これらの合算が上限を超えたときにコンテキストウィンドウオーバーフロー(CWO)が発生します。
オーバーフローするとどうなるか
コンテキストウィンドウがいっぱいになったとき、多くのLLMの実装では先入れ先出し(FIFO)方式でトークンを管理します。新しいトークンが末尾に追加されると、古いトークンが先頭から削除されます。つまり「会話の冒頭に書いた重要な指示」が知らぬ間に消えてしまうことがあります。
AWSの事例が示すように、これはセキュリティリスクにもなりえます。システムプロンプトでモデルに特定の制約を与えていても、会話が長くなってそのプロンプトがウィンドウから押し出されると、悪意ある入力によるプロンプトインジェクション攻撃が成功しやすくなります。
エラーとして表面化する場合は、APIが「コンテキストの長さを超えました」というエラーを返します。ユーザー向けのチャットインターフェースでは、エラーを表示する代わりに暗黙的に古い会話を切り捨てることが多く、利用者が気づきにくい点でむしろ注意が必要です。
「Lost in the Middle」問題とは
1Mトークンのウィンドウがあれば何でも詰め込めばよい、と考えるのは早計です。スタンフォード大学などの研究が明らかにした「Lost in the Middle」という現象があります。
これは、長いコンテキストの中間部分に置かれた情報を、LLMが回答に活用しにくくなる現象です。LLMは文章の先頭(プロンプトの冒頭)と末尾(直近の入力)の情報を優先的に参照する傾向があり、長いドキュメントを丸ごと渡しても、肝心の情報が中ほどに埋もれていると見落とされやすくなります。
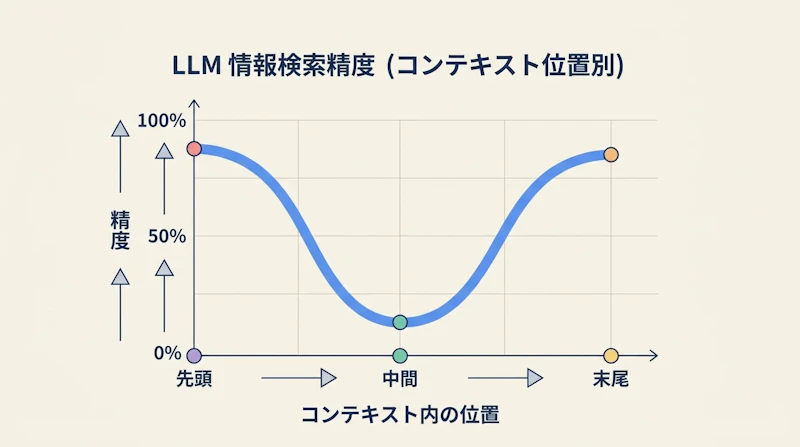
実務上の対策としては、最も重要な情報はプロンプトの先頭か末尾に配置すること、長大なドキュメントは目的に応じて要約や分割を行うこと、後述するRAGで必要な箇所だけを検索して注入することが有効です。
コンテキストウィンドウを支えるKVキャッシュ
大きなコンテキストウィンドウを実現するうえで欠かせない技術がKVキャッシュ(Key-Value Cache)です。
LLMはTransformerというアーキテクチャに基づいており、推論のたびに各トークンの「キー(Key)」と「バリュー(Value)」という内部表現を計算します。コンテキストが長いほど計算量は膨大になりますが、KVキャッシュを使うと既に計算済みのトークンの結果を保存しておき、次の推論では差分だけを計算できます。これにより、長いコンテキストを繰り返し参照するチャットや、ドキュメントQAのようなユースケースでコストと遅延を大幅に削減できます。
ClaudeのPrompt Caching機能やGeminiの長文キャッシュ機能はこの原理を応用しており、同じシステムプロンプトや背景文書を何度も送り直すコストを節約できます。
RAGとコンテキストウィンドウの関係
コンテキストウィンドウの制約を現実的に乗り越える手法として広く普及しているのがRAG(Retrieval-Augmented Generation、検索拡張生成)です。
RAGは、大量のドキュメントをすべてコンテキストに詰め込む代わりに、ユーザーの質問に関連する箇所だけをベクトル検索で取り出し、コンテキストウィンドウに注入します。1Mトークンのウィンドウがあっても、書籍100冊分のデータを全部渡すことはできませんが、RAGなら質問に関係する数ページだけを高精度に検索して渡せます。
RAGを利用する際は、検索で取得した文書テキストもコンテキストウィンドウを消費することを忘れないでください。検索結果の件数や1件あたりの文字数をコントロールして、ウィンドウ容量を無駄なく使う設計が重要です。なお、LLMエージェントの強化学習手法でも、コンテキスト管理は多ターン性能を左右する核心的な課題として研究が進んでいます。
オーバーフローを防ぐ実践的な対策
AWSのベストプラクティスを参考に、コンテキストウィンドウオーバーフローを防ぐための実践的な方法をまとめます。
トークン数の事前チェック
LLMのAPIを呼び出す前に、入力トークン数を測定しましょう。OpenAIのtiktokenライブラリや、AnthropicのSDKに組み込まれたカウント機能を使えば、実際のトークン数を事前に確認できます。上限の80〜90%を超えた場合は、古い会話を要約して圧縮するなどの処理を挟むと安全です。
会話の要約・圧縮
長い会話履歴をそのまま保持するのではなく、一定のターン数を超えたら過去のやり取りをLLM自身に要約させてコンパクトにまとめる手法が有効です。重要なファクト(名前、数値、決定事項)は要約に必ず含めるよう指示すると、情報の損失を最小限に抑えられます。
RAGで必要な情報だけを注入する
前述のとおり、大量のドキュメントを丸ごと渡すのではなく、質問に関連する箇所だけをベクトル検索で取り出す設計が根本的な解決策になります。検索精度が上がるほど、コンテキストを無駄に消費せずに済みます。
モニタリングとアラート
本番環境では、各リクエストのトークン使用量をログに記録し、異常な増加が発生した場合にアラートを出す仕組みを整えましょう。AWSのCloudWatchをはじめ、多くのクラウドプロバイダーが対応するモニタリング機能を活用できます。
1Mトークン時代の向き合い方
コンテキストウィンドウの拡大は、LLMの活用領域を大きく広げています。数百ページの法律文書を一括レビューする、コードベース全体を渡してバグを検出する、長時間の会議録を丸ごと分析するといった用途が現実的になりました。
一方で、大きなウィンドウを持つモデルは推論コストも高くなります。100万トークンを毎回フル活用するのはコスト面で非効率なことが多く、RAGやKVキャッシュを組み合わせて「必要な情報を必要なだけ渡す」設計の重要性は変わりません。
コンテキストウィンドウは「大きければ大きいほど良い」という単純な話ではなく、容量・精度・コスト・セキュリティの4軸でバランスよく管理することが、LLMを実務に組み込む際の核心的な設計課題です。基礎を正しく理解することが、AIシステムを安定して運用するための第一歩となります。
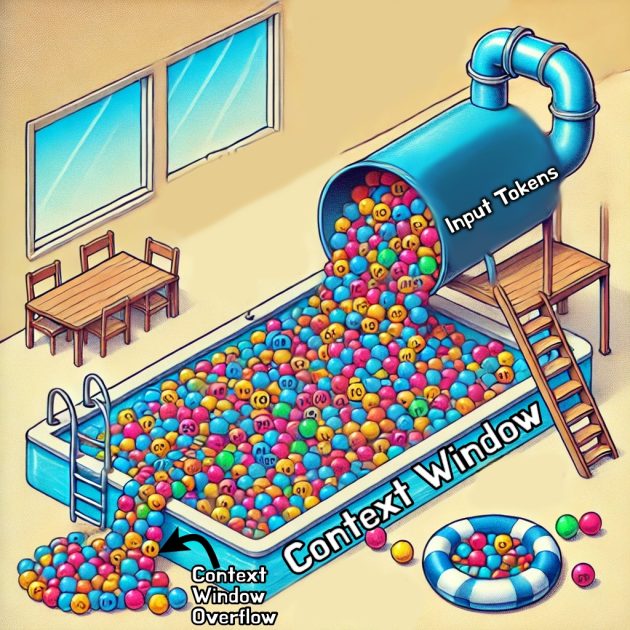
 aws.amazon.com


