 AI-Papers
- SSD-CPU-GPU階層を活用するアウトオブコア最適化で、単一24GB GPUで10億個超の3Dガウシアン訓練を実現した
- 軌跡適応型差分ストリーミングによりPCIe転送量を先行手法比4分の1以下に削減し、GPU利用率43%を維持
- MatrixCityデータセットで26.1dBのPSNRを達成。先行アウトオブコア手法を1.1dB上回る品質を単一GPUで確認
研究の背景
3D Gaussian Splatting(3DGS)は、複数視点から撮影した画像を基に、空間内に無数の半透明な楕円体(ガウシアンプリミティブ)を配置することで、新しい視点からのリアルな画像を高速に合成できる技術です。新視点合成や3D再構成の分野で急速に普及し、自動運転やメタバースへの応用も期待されています。
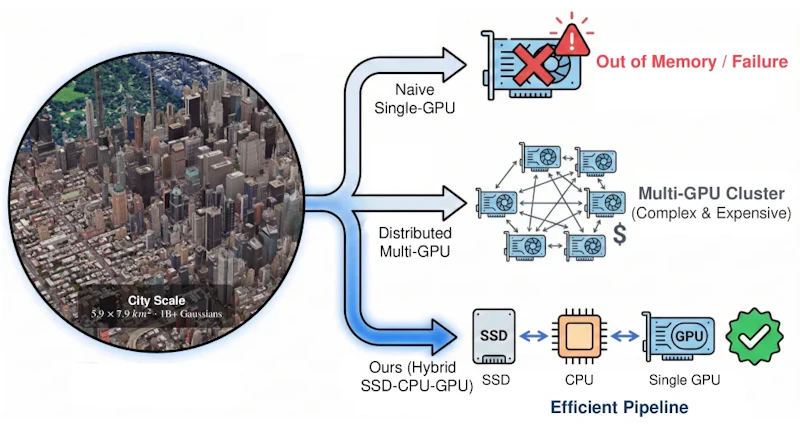
しかし3DGSには根本的なメモリの壁が存在します。訓練中は全ガウシアンのパラメータや勾配をGPUのVRAM上に保持する必要があるため、24GBのVRAMを持つGPUでも約1,150万個が上限でした。都市規模のシーン再構成には数億から数十億個のガウシアンが必要とされており、この制約が研究と実用の両面で障壁となってきました。
既存のアウトオブコア(一部データをメモリ外に置く)手法も提案されてきましたが、最大でも約1億個程度にとどまり、I/O転送のオーバーヘッドによる速度低下も課題です。本研究はこの問題に正面から取り組み、10億個超という桁違いのスケールを単一GPUで実現するフレームワーク「TideGS」を提案しました。ICML 2026のSpotlightに採択された研究です。
3つの中核技術
TideGSは、メモリの壁を突破するために3つの技術を組み合わせています。
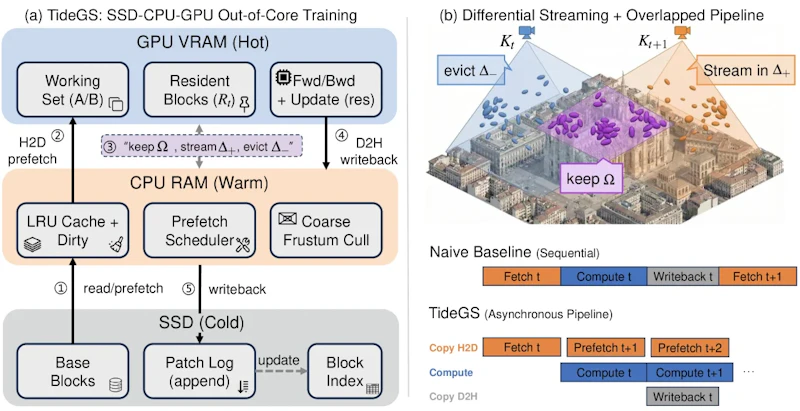
ブロック仮想化ジオメトリは、空間的に近いガウシアンをまとめてSSD上に格納する仕組みです。Mortonコード(空間充填曲線の一種)でガウシアンをソートし、4,096個ずつのブロック(約944KiB)に分割してSSDに保存します。
各ブロックには包囲球(バウンディングスフィア)が付与されており、CPUがカメラの視野錐台(フラスタム)と照合することで、実際に見えるブロックだけを効率よく選択できます。Morton順序をなくすとキャッシュヒット率が95.2%から42.1%に低下するというアブレーション実験が、この空間局所性設計の重要性を示しました。
階層的非同期パイプラインは、SSD・CPU・GPU間のI/O転送とGPUの演算を時間的に重ね合わせてレイテンシを隠蔽する技術です。CPU側で粗いブロック単位の可視性チェック(6平面フラスタムカリング)を行い、GPU側で細粒度なガウシアン単位のフィルタリングとレンダリング・逆伝播を担当する2段階構成になっています。SSDからの読み込み、CPU-GPU間の転送、GPU演算はすべて非同期で並列実行され、非同期重複をなくすと1イテレーション処理時間が90.7msから210.5msへと約2.3倍に悪化しました。
軌跡適応型差分ストリーミングは、本フレームワーク名の由来になった中核技術です。訓練中のカメラ軌跡(視点の移動)に着目し、連続するイテレーション間で使用するブロックの集合がどれだけ重複するかを活用します。
前のイテレーションで既にGPUにロード済みのブロックはそのまま保持し、新たに必要になったブロックだけをSSDから転送します。この差分のみ転送という方式により、約1億個スケールではPCIe転送量を先行手法CLMの4分の1以下(1イテレーションあたり0.10GB対0.41GB)に抑えました。
実験結果
実験はNVIDIA RTX A5000(24GB VRAM)、256GB CPU RAM、Samsung PM9A3 NVMe SSD(読取速度3.3GB/s)という単一GPU環境で行われました。大規模シーンの評価には都市スケールデータセット「MatrixCity」が使われています。
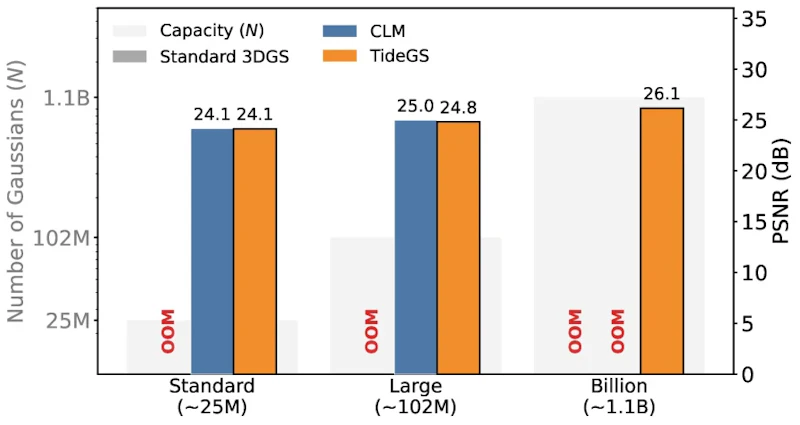
品質の面では、TideGSは約11億個(1.1B)のガウシアンで訓練した場合にPSNR 26.1dBを達成しました。PSNRは再構成した画像が元の画像にどれだけ近いかを表す指標で、数値が大きいほど高品質を意味します。
先行アウトオブコア手法「CLM」は約1億個でメモリ不足(OOM)が発生してPSNR 25.0dBにとどまっており、TideGSはさらに10倍以上の規模で1.1dBの品質向上を実現しました。標準の3DGSやCLMは、より大きなスケールではそもそも動作しません。
速度効率については、両手法が動作する同等スケール(約1億個)で比較されています。主な数値は次のとおりです。
項目(約1億個) | TideGS | CLM |
|---|---|---|
1イテレーション処理時間 | 90.7ms | 100.8ms |
GPU利用率 | 43.3% | 37.0% |
PCIe転送量(1イテレーションあたり) | 0.10GB | 0.41GB |
いずれの項目でもTideGSが上回っており、転送量の少なさが処理時間とGPU利用率の差につながっています。また、Mip-NeRF 360などの中規模データセットでは、アウトオブコア化によるPSNRの低下は平均0.11dBにとどまり、画像の構造的な近さを測るSSIM(高いほど良い)と、見た目の違いを測るLPIPS(低いほど良い)もほぼ同等でした。
3Dシーンを編集する観点に興味があれば、テキスト指示でフィードフォワードに3Dシーンを編集するVGGT-Editも参照してください。
まとめと今後の展望
TideGSは、ブロック仮想化・非同期パイプライン・差分ストリーミングという3技術を統合することで、単一24GB GPUで10億個超の3Dガウシアンを訓練可能にしました。VRAMの制約をソフトウェア設計で克服したアプローチは、高価なマルチGPU環境なしに大規模3D再構成を実現する実用的な道筋を示しています。
一方で論文はいくつかの制約も率直に認めています。カメラ軌跡の連続性が低い撮影条件では差分ストリーミングの効率が落ちること、低速なSATAドライブでは効果が限定的なこと、そしてGrendel-GSのような多数GPUを用いた分散訓練と比べると実時間では劣ることです。
都市規模の3D再構成、自動運転向けシーン生成、大規模な3D環境の構築など、VRAMの壁を超えた3DGS訓練が求められる用途で応用が広がるでしょう。
論文情報: "TideGS: Scalable Training of Over One Billion 3D Gaussian Splatting Primitives via Out-of-Core Optimization"(Chonghao Zhong et al., 2026) arXiv:2605.20150
本記事の図(図1、図2、図4)は解説のため上記論文より引用しています。

