 AI-Papers
- 既存のフルAttention Transformerをゼロから再学習せずMamba/線形Attentionとのハイブリッドへ変換する「FlashMorph」をByteDance Seedが発表
- どの層をフルAttentionとして残すかを予算制約付き共同最適化として定式化し、HALO比7.3分の1のGPU時間(2.1時間)で層選択が完了
- 256Kトークンでのプリフィル速度を2.81倍、512Kトークンでのデコード速度を2.07倍高速化しつつ一般ベンチマークの性能を維持
研究の背景と課題
Transformer(変換器型ニューラルネットワーク)のAttention機構(入力全体を相互参照する仕組み)は、入力の長さが増えると計算コストが二乗的に増加します。100万トークン規模の長文脈処理が求められる今日、このボトルネックは実運用の大きな障壁となっています。
近年、Mambaや線形Attentionといった効率的なアーキテクチャが注目されています。これらは計算量を線形オーダーに抑えられる一方、特定の情報を正確に取り出すリコール精度ではフルAttentionに劣ることがあります。そこで、必要な層にだけフルAttentionを残し、残りを効率的な機構で置き換えるハイブリッドモデルが有力な解決策として台頭しました。
問題は「どの層をフルAttentionとして残すか」という選択です。従来のHALOやKL-LSといった手法は各層を独立して評価していました。この方式では層間の相互作用を考慮できないため最適な組み合わせを見つけにくく、特にKL-LSは200億トークン相当の計算を要するため大規模モデルへの適用が現実的ではありませんでした。
FlashMorphの全体像
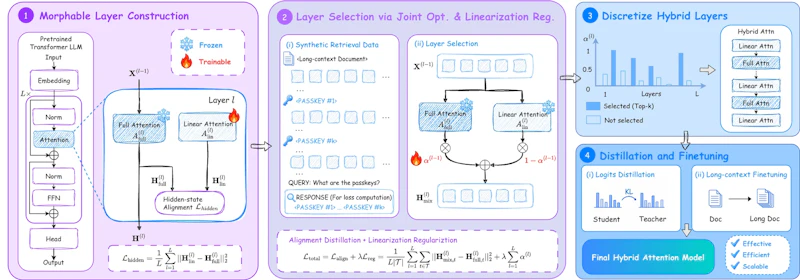
ByteDance Seedが提案するFlashMorphは、層選択を「予算制約付き部分集合最適化問題」として定式化します。元のモデルの重みをすべて凍結したまま、各Attention層に学習可能なゲート値α^(l)(0〜1の実数)を導入し、フルAttentionと線形Attentionの間を連続的に補間できる「形態可能な層」を構築します。
全ゲートを同時に学習するため、ある層の変更が別の層の動作に与える影響も最適化の中で自然に考慮されます。学習後はゲート値の高い上位K層をフルAttentionとして確定し、残りを線形Attentionで置き換えてハイブリッドアーキテクチャを確定させます。
3段階の変換パイプライン
FlashMorphの変換プロセスは次の3段階から成ります。
- 形態可能モデルの構築: 元のフルAttention層を凍結し、各層に線形Attentionブランチを追加。層ごとの隠れ状態一致損失を最小化して、線形分岐が元の出力を模倣できるよう学習する
- ゲートの共同最適化: 合成検索データを用い、アライメント損失と線形化正則化の両方を目的関数として全ゲートを同時に学習。学習後のゲートを離散化してトップK層を選択する
- 蒸留と長文脈ファインチューニング: 元のフルAttentionモデルを教師として、KLダイバージェンス(確率分布の差異)最小化による蒸留を実施。さらに長文脈タスク向けにファインチューニングして完成させる
特徴的な設計は、ゲート学習の入力データに「合成検索データ」を使う点です。フルAttentionが特に重要になるリコールタスクを意図的に含めることで、長文脈での性能維持に直結する層が自然に高いゲート値を獲得できます。このようなLLMの効率化探索の発想は、Program-as-Weightsのような既存モデルを再活用して機能を拡張するアプローチとも共通する哲学を持っています。
実験で示された速度向上
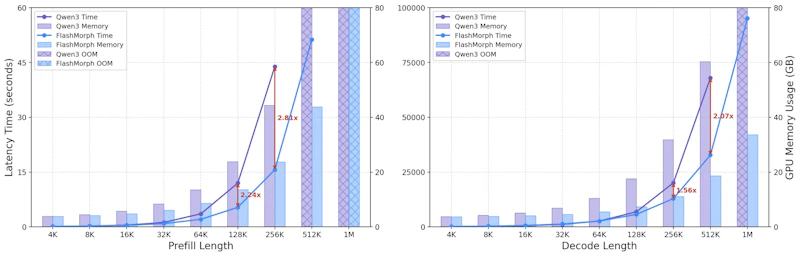
FlashMorphはQwen3をベースに1.7B規模を中心とした変換実験を行い、フルAttentionモデルと比べて以下の速度向上を達成しました。
- プリフィル(入力の事前処理): 128Kトークンで2.24倍、256Kトークンで2.81倍の高速化
- デコード(トークン生成): 256Kトークンで1.56倍、512Kトークンで2.07倍の高速化
- GPUメモリ: 長文脈においてフルAttentionモデルより大幅に削減
長文脈でのリコール性能を評価するRULERベンチマークでも、フルAttention構成と比べて大幅な性能劣化なく動作することが確認されています。一般的な言語理解タスクのスコアも同様に維持されました。
層選択の効率と比較手法
FlashMorphのもう一つの強みは、層選択そのものの計算コストが非常に低い点です。全ゲートを同時に最適化するため少量のデータで大域的な解を得られ、独立した層ごとの評価では必要だった大量のトークンを節約できます。
手法 | 層選択トークン数 | GPU時間(目安) |
|---|---|---|
FlashMorph | 2,000万 | 2.1時間 |
HALO | 2億3,400万 | 15.4時間 |
KL-LS | 200億 | 1,071.8時間 |
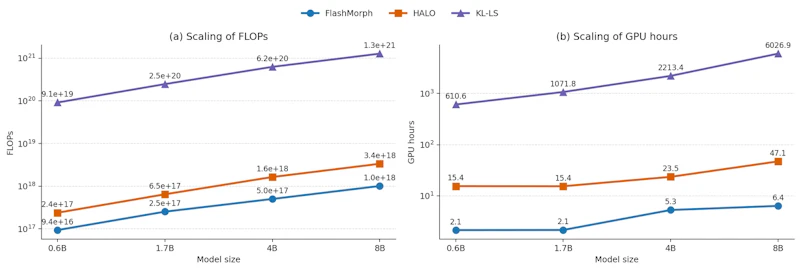
FlashMorphはHALOの約7.3分の1、KL-LSの約510分の1のGPU時間で層選択が完了します。モデルサイズが大きくなるにつれて、この効率差はさらに顕著になることも実験で示されています。
ハイブリッド比率とアブレーション
フルAttentionとして残す層の割合(ハイブリッド比率)については、適切な範囲を保つことがリコール性能の維持に重要です。すべての層をフルAttentionにした場合より、一定割合を線形Attentionに置き換えた構成の方がRULERスコアも効率も両立できることが確認されています。
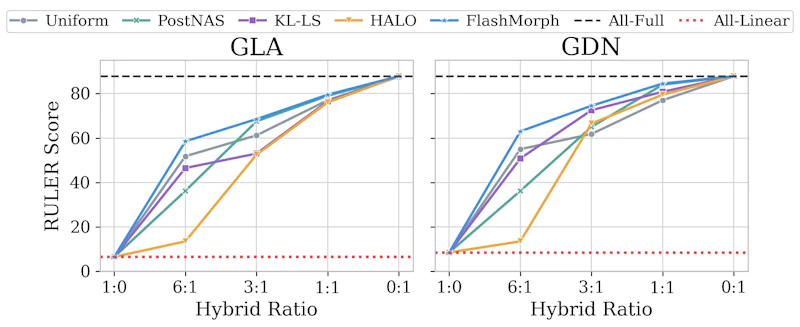
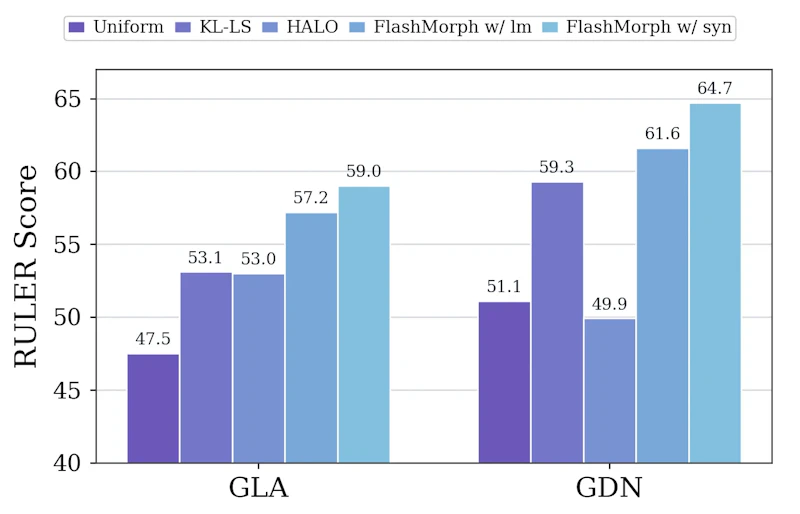
アブレーション実験では、合成検索データを使った監視が特に長文脈リコール性能に貢献していることも明らかになっています。ランダムなテキストデータのみで層選択を最適化した場合と比べ、RULERでのスコアが向上します。
まとめと今後の展望
FlashMorphは「どの層を残すか」という問いを全層の同時最適化として解くことで、HALOなどの従来手法では難しかった高品質なハイブリッドアーキテクチャの発見を低コストで実現しています。ゼロからの再学習なしに256Kトークンで2.81倍のプリフィル高速化を達成している点は、既存モデルを活用した実用的な長文脈効率化のパスとして価値があります。
今後の課題としては、現在の検証がQwen3ベースに限られており、他のフルAttentionアーキテクチャへの汎化性能の確認が必要です。また、線形Attentionブランチとして採用する機構(MambaやRetNet、GLA等)の選択が性能に与える影響も、今後の研究での深掘りが期待されます。
論文情報: "Morphing into Hybrid Attention Models"(Disen Lan et al., 2026) arXiv:2606.30562
本記事の図(図1〜図5)は解説のため上記論文より引用しています。


