 AI-Papers
- ルーティングを「文脈エンコーダ・モデルエンコーダ・スコア関数・決定則・学習信号」の5要素で統一的に定式化した基盤を提案
- 汎用・記憶拡張・視覚・時系列・個人化の5トラックを含むベンチマークxRouteBenchを整備し、16種以上のルーターを収録
- 学習型ルーターは最強の固定モデルと比べて相対14.6%の性能改善を達成し、コスト制約下では軽量ルーターが有利になると報告
単一LLMの限界
大規模言語モデル(Large Language Model、以下LLM)はモデルごとに得意分野やコストが異なります。高性能なモデルは幅広い問題に強い一方で利用料金が高く、軽量なモデルは安価でも難しい問題ではつまずきがちです。どのクエリ(利用者からの問い合わせ)に対しても常に最適な単一のモデルは存在しません。
そこで注目されているのが「ルーティング」という考え方です。これは、問い合わせの内容に応じて複数のLLMから最適な1つを選んで振り分ける仕組みを指します。うまく振り分けられれば、コストを抑えつつ回答の質を保つことができます。
ただし、これまでのルーター研究は評価方法もデータも研究ごとにばらばらで、手法どうしを公平に比べにくい状況でした。本論文LLMRouterは、ルーターの構築・評価・運用を一気通貫で扱う統一基盤を提案し、この課題の解決を目指しています。
ルーティングの統一定式化
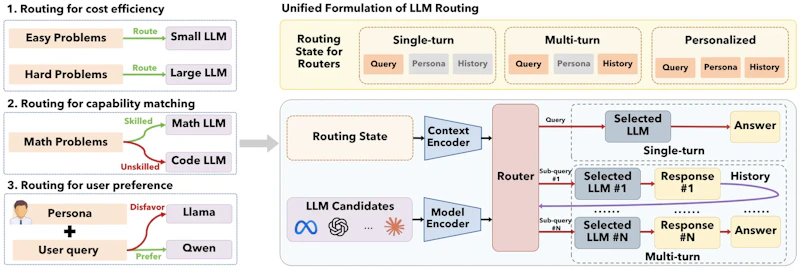
本研究の中心的な貢献は、多様なルーティング手法を1つの意思決定プロセスとして整理した点にあります。著者らはルーティングを次の5つの要素に分解しました。
- 文脈エンコーダ(クエリや利用者、対話履歴の状態を表現する)
- モデルエンコーダ(候補となる各LLMの特徴を表現する)
- スコア関数(クエリとモデルの相性を数値化する)
- 決定則(スコアをもとに実際にどのモデルへ送るか決める)
- 学習信号(過去の結果からルーターを訓練するための教師データ)
この枠組みでは、単発の質問への対応(single-turn)、複数回のやり取り(multi-turn)、利用者ごとの好みに合わせた個人化のいずれも、状態のどの部分を見るかが違うだけの同じ仕組みとして扱えます。図1はこの統一的な定式化の全体像を示しています。
LLMRouterの全体構成
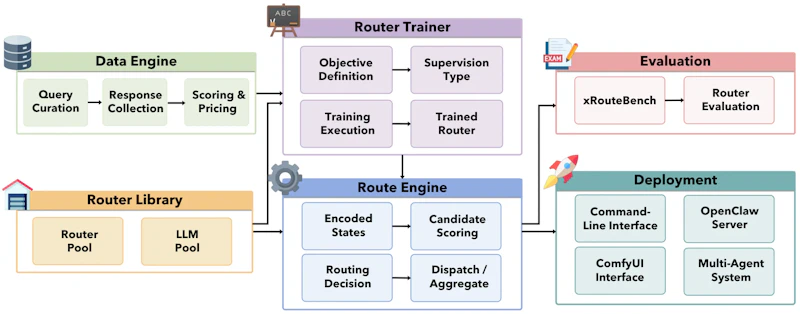
提案されたLLMRouterは、6つのモジュールから構成されるソフトウェア基盤です。ルーティング用データの構築、ルーターの実装と訓練、推論、評価、そして実運用までを一貫して支援します。
データ構築の中核を担うのがデータエンジンです。これは元となるベンチマークと候補モデル群を受け取り、「どのクエリをどのモデルに送るとどうなるか」を表した行列を自動で生成します。この行列があることで、各ルーターは同じ土俵で性能を評価できます。
さらに、ノードをつなぐ形でパイプラインを組み立てられるComfyUI風の画面や、利用者から2択で好みを集めるSlack連携の仕組みも用意されています。研究者だけでなく実務者もルーティングの流れを目で追いながら試せる設計になっています。
xRouteBenchの評価軸
公平な比較を可能にするため、著者らはxRouteBenchというベンチマークを整備しました。これは以下の5つのトラック(評価領域)をカバーしています。
- 汎用的なLLMタスク
- 記憶拡張(過去の情報を参照する)タスク
- 視覚を伴う推論タスク
- 時系列データを扱うタスク
- 利用者ごとの個人化タスク
視覚トラックでは、幾何図形を扱うGeometry3Kや科学的な図を含むMathVistaなどが用いられます。画像はGemma-3-27B-ITが説明文に変換し、その説明を問題文に付け加えたテキストをルーターが受け取る形式です。一人称と三人称の映像を含むCharades-Egoのような多視点データも取り込み、視点を一部隠すことで難易度の異なるクエリを作り出しています。
この基盤には16種類以上の代表的なルーターが収録されており、条件をそろえた比較ができます。多様なタスクを横断して評価できる点が、従来の断片的な研究との大きな違いです。
学習型ルーターの成果
実験では、過去の結果から訓練した学習型ルーターが、常に同じモデルを使い続ける最強の固定モデルと比べて相対14.6%の性能改善を達成しました。クエリの内容に応じてモデルを賢く選ぶことの効果が、定量的に確かめられた形です。
一方で、性能とコストのバランスを決める重み(コスト重みβ)を変えると、有利なルーターの顔ぶれも変わります。コストへの制約が厳しくなるほど、軽量なルーターが相対的に競争力を増していきます。図5はコスト重みを上げていったときの各トラックでのルーター順位の変化を示しています。
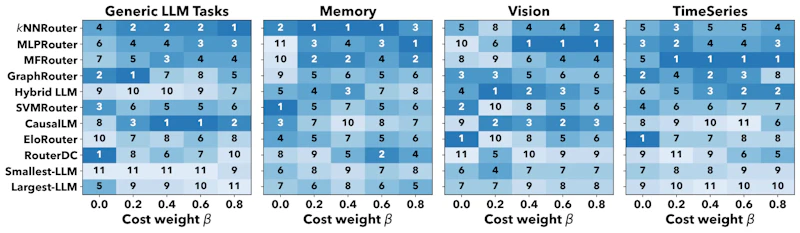
また、利用者の状態を条件に加えたルーティングは、個人化の性能を一貫して高めました。ただし、どのルーターが最適かは目的やコスト制約に依存するため、万能な1つの手法があるわけではありません。用途に合わせて選び分ける前提の設計思想がうかがえます。
まとめと今後の展望
LLMRouterは、これまで研究ごとにばらばらだったLLMルーティングを統一的な枠組みとベンチマークにまとめ上げた基盤です。5要素の定式化とxRouteBench、そして再現しやすいオープンソース実装により、手法の比較や新しいルーターの開発が進めやすくなります。
複数のモデルを使い分けてコストを最適化する需要は、実務でも今後さらに高まると考えられます。一方で、最適なルーターがコストや目的によって変わる点は、運用側にとって設計判断の難しさも残します。ルーティングの学習信号をどう効率よく集めるかや、新しいモデルが増えたときの追従のしやすさが、実用面での次の焦点になりそうです。
論文情報: "LLMRouter: Unified Infrastructure for Developing, Evaluating, and Deploying LLM Routers"(Tao Feng et al., 2026) arXiv:2608.06867, CC BY 4.0
本記事の図(図1、図3、図5)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


