 AI-Papers
- 知識を蓄える全層共有のFFNメモリと、それを反復参照して推論するSelf-Attentionを分離した新アーキテクチャMobiusを提案
- 7Bモデルはゼロから学習し、Transformer相当の性能を学習データ62.6%で達成しデータ効率を約1.6倍改善
- 35BのIntern-S2-MobiusはQwen3.5から継続学習で構築し、同等スコアを保ちつつ推論を約4倍高速化
研究の背景
大規模言語モデル(Large Language Model、以下LLM)の性能はモデルサイズと学習データを増やすほど向上してきましたが、その伸びは近年頭打ちに近づいています。上海AI Lab(Shanghai AI Laboratory)の研究チームは、この停滞の原因が従来のTransformerアーキテクチャそのものにあると考えました。
従来のTransformerには、大きく3つの非効率があります。
- 同じ知識が複数の層に重複して保存され、記憶の効率が悪い
- 問題の難しさに関係なく、冗長で回りくどい思考過程を出力しがち
- 層ごとにFFN(Feed-Forward Network、知識を蓄える全結合層)が固定され、深い層が浅い層の知識を再利用しにくい
これら3点はいずれも、知識の置き場所と計算の手順が層の中で一体化していることに由来します。そこで提案されたのが、知識の保存と推論の計算を明確に切り離した新アーキテクチャMobiusです。この設計思想に基づき、35Bの基盤モデル「Intern-S2-Mobius」が構築されました。
知識と推論を分ける発想
Mobiusの中心にあるのは、モデルを「知識を蓄えるメモリ」と「そのメモリを使って考えるReasoner」に分離するという考え方です。メモリは全層で共有される1つの巨大なFFNとして実装され、知識ベクトルをまとめて保管します。一方のReasonerはSelf-Attention(入力の関連部分に注目する仕組み)が担い、必要な知識をメモリに何度も問い合わせながら段階的に推論を進めます。
従来のTransformerではFFNが各層に固定されていたのに対し、Mobiusではすべての層が同じ知識の集合体へ自由にアクセスできます。複数のFFNを横方向につなげて1つの共有プールにまとめる設計により、同じ知識を層ごとに持ち直す無駄がなくなります。この「知識と推論の分離」によって高い圧縮率で知識を蓄えられるため、少ない学習データでも十分な知識を獲得できます。
推論の途中結果は隠れ状態(hidden state)としてキャッシュされ、知識とReasonerの間を橋渡しする運び手の役割を果たします。大規模化しても効率が落ちないよう、メモリはMoE(Mixture of Experts、専門家混合)と同じ発想でまばらに活性化される仕組みも取り入れました。
高速推論を支える仕組み
Mobiusが約4倍の高速化を実現する鍵は、2つの工夫にあります。1つは「後ろ向きの残差接続(backward residual connection)」です。通常の残差接続が浅い層から深い層へ情報を渡すのに対し、この仕組みは深い層が浅い層の知識へ直接アクセスできるようにし、長い思考の連鎖で情報を作り直す手間を省きます。
もう1つは「潜在空間での動的推論」です。Mobiusはトークンを1つずつ生成するのではなく、モデル内部で知識をたどる処理と複数トークンの反復を繰り返し、情報密度の高い隠れ状態を作ってから出力します。これにより、複数トークンを一度に予測するMulti-Token Prediction(MTP、複数トークン同時予測)を自然にサポートできます。
下の図は、層ごとに次に予測されるトークンを可視化した「予測レンズ」の比較です。Mobiusは途中の層でも正解に沿った予測を示し、5トークンの下書きがすべて受理されました。一方、比較対象のQwen3.5では先頭2トークンしか受理されていません。Mobiusが情報を分散させず、コンパクトな内部表現へ集約していることがうかがえます。
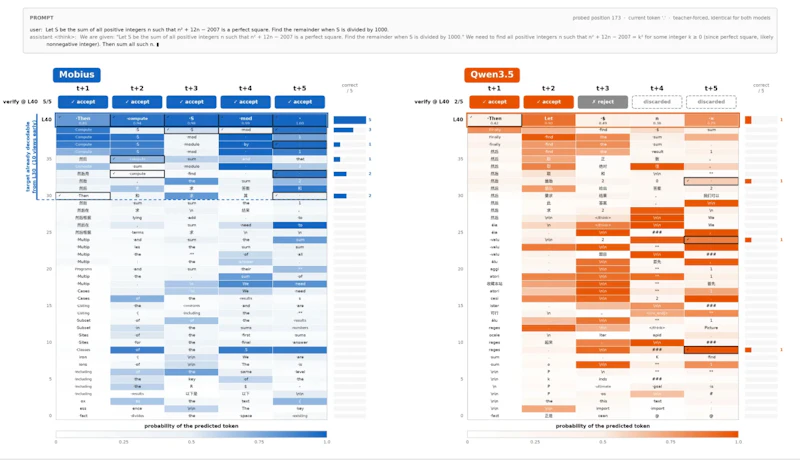
この効果は出力の簡潔さにも表れます。論文の例では、ある線形代数の問題に対しQwen3.5が2364トークンを費やしたのに対し、Mobiusはわずか516トークンで回答しました。冗長な導出や検算を内部で済ませることで、無駄な出力を大きく削減しています。トークン圧縮による効率化という点では、OmniPackのような学習不要の圧縮手法とも問題意識が通じます。
実験で示された性能
研究チームは2つの方法でMobiusを検証しました。1つはゼロから学習した7Bモデル、もう1つはQwen3.5-35Bをアーキテクチャ変換して継続学習した35BのIntern-S2-Mobiusです。
7Bモデルは、同規模のTransformerと同等の下流タスク性能を、学習データ62.6%で達成しました。これはデータ効率を約1.6倍改善したことを意味します。35Bモデルは同等のスコアを保ちながら、エンドツーエンドで約4倍の推論高速化を実現しました。主な数値は次の表の通りです。
項目 | Mobius | 比較対象 |
|---|---|---|
MMLU Pro(35B) | 89.05 | 85.31(ベースライン) |
同等性能に要した学習データ(7B) | 62.6% | 100%(Transformer) |
線形代数問題の出力トークン数 | 516 | 2364(Qwen3.5) |
知識ベンチマークのMMLU Pro(大学レベルの多分野試験)でベースラインを上回った点は、知識をまとめて保管する設計が暗記性能を損なわないことを示しています。
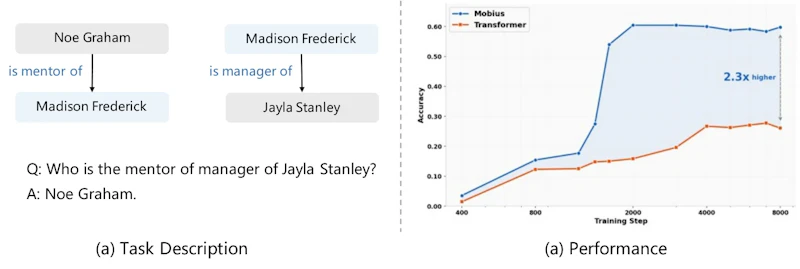
知識どうしのつながりを学べているかを測る合成的推論タスクでも、Mobiusは優位を示しました。500エンティティの単一ホップ知識と400エンティティの2ホップ知識で学習し、100エンティティの2ホップ知識で評価するこの課題では、単なる暗記ではなく知識の連結が問われます。下の図の通り、Mobiusは収束が速く最終精度も高くなりました。
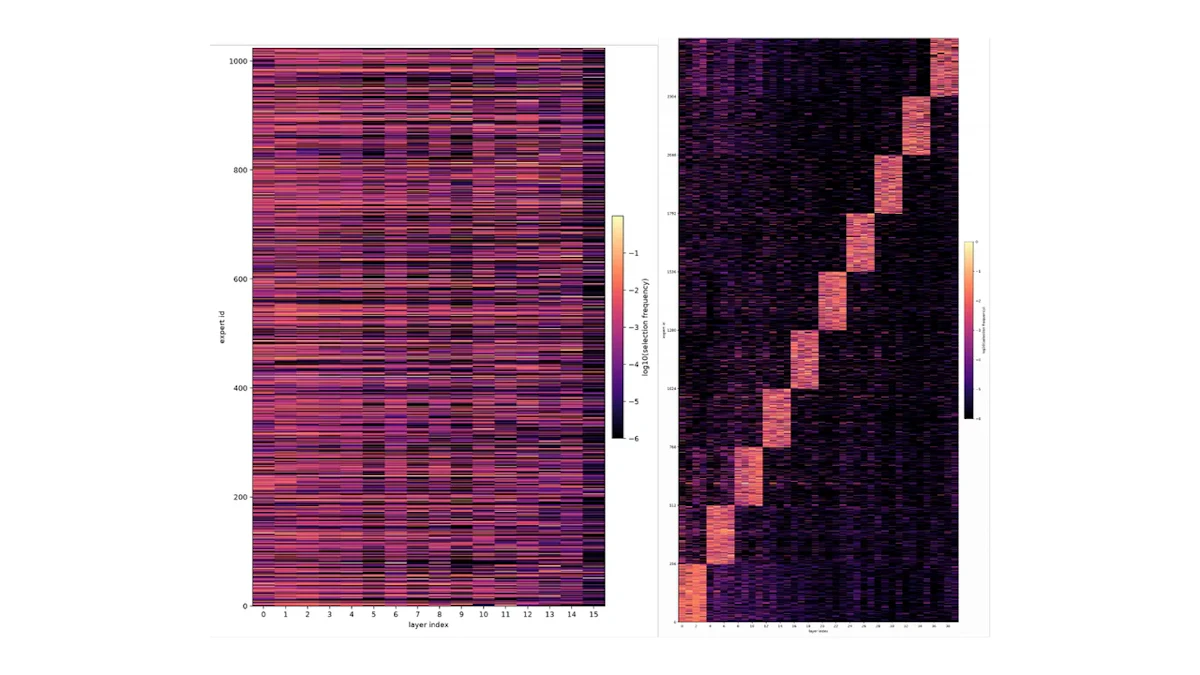
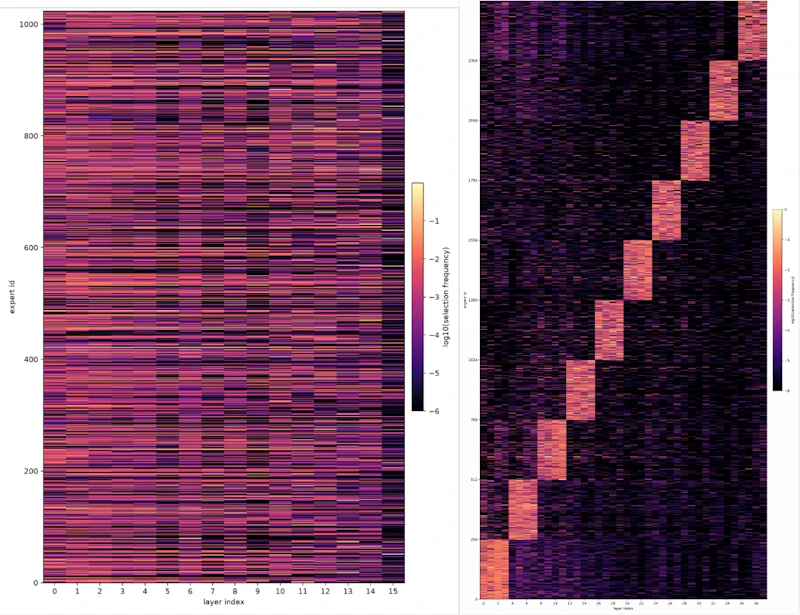
専門家の活性化パターンにも違いが見られます。ゼロから学習した7Bでは推論層をまたいで比較的均一に活性化しており、共有メモリを柔軟に使えていることを示します。一方、変換して継続学習した35Bでは、元のチェックポイントの経路構造を引き継いだブロック対角のパターンが濃く残りました。
まとめと今後の展望
Mobiusは、知識の保存と推論の計算を切り離すことで、少ない学習データと高速な推論を両立させたアーキテクチャです。知識と計算を分離する考え方は特定モデルに限らず幅広いLLMへ応用でき、効率化を目指す設計の1つの方向性を示しました。
一方で課題も残ります。35Bモデルは変換元の経路構造を引き継ぐため、ゼロから学習した場合ほどメモリを自由に使えていない可能性があります。均一な活性化がそのまま性能向上につながるかは、同規模での対照実験による検証が必要だと論文自身も述べています。バージョン名の「v0」が示す通り、Mobiusはまだ発展途上のアーキテクチャであり、今後の改良でどこまで潜在能力を引き出せるかが焦点となります。
論文情報: "Intern-S2-Mobius: Foundation Model with Decoupled Knowledge and Reasoning"(Kai Chen et al., 2026) arXiv:2608.14290, CC BY 4.0
本記事の図(図1〜図3)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


