 AI-Papers
- 論文執筆の全工程を、既存のコーディング支援ツール上で動く13個の合成可能なスキルとして再構成した自動生成システムです
- 結果を見る前に必要な証拠を先に決める設計により、主張の捏造検出率を単発の14%から全体で92%へ引き上げました
- 引用の正確性99.5%、図表の編集可能性96.4%、1本あたり8.1ドル・3.2時間という実用的なコストで論文を生成します
研究の背景
大規模言語モデル(Large Language Model、LLM)を使って研究論文をまるごと自動生成しようとする試みは、これまでも数多く登場してきました。しかし多くのシステムには共通の弱点があります。それは、モデルが「実験結果を実際に測定する前に、都合のよい結論を先に決めてしまう」という問題です。
この癖があると、生成された論文には測定していない数値や、実験で裏付けられていない主張がまぎれ込みます。いわゆる結果の捏造です。人間の査読者ですら見抜きにくいこうした問題は、AIによる研究自動化を実用化するうえで大きな障害になっていました。
「Spark-to-Paper」は、この課題に正面から取り組んだシステムです。研究のアイデア(論文ではSparkと呼ばれる短い提案)を入力するだけで、文献調査から実験の設計と実行、証拠に基づく主張の修正、出版可能な図表の生成までを一貫して自動化します。関連する動きとしては科学研究の自動化を掲げる新会社Discovery Loopのような取り組みもあり、この分野への関心は急速に高まっています。
提案手法
Spark-to-Paperの最大の特徴は、論文執筆を専用のエージェント基盤で作り込むのではなく、既存のコーディング支援ツールの上で動く13個の合成可能なスキルとして実装した点にあります。それぞれのスキルは独立した部品として組み合わせられるため、拡張や差し替えが容易です。
システムは大きく9つの段階(Stage 0からStage 8)で構成されます。Stage 0で結果の扱い方(実際に実験を行うか、既存データを使うかなど)のモードを選び、Stage 1からStage 7が持続的なプロジェクト成果物を介して連携します。条件付きのStage 8では、測定された証拠を論文原稿へ書き戻します。
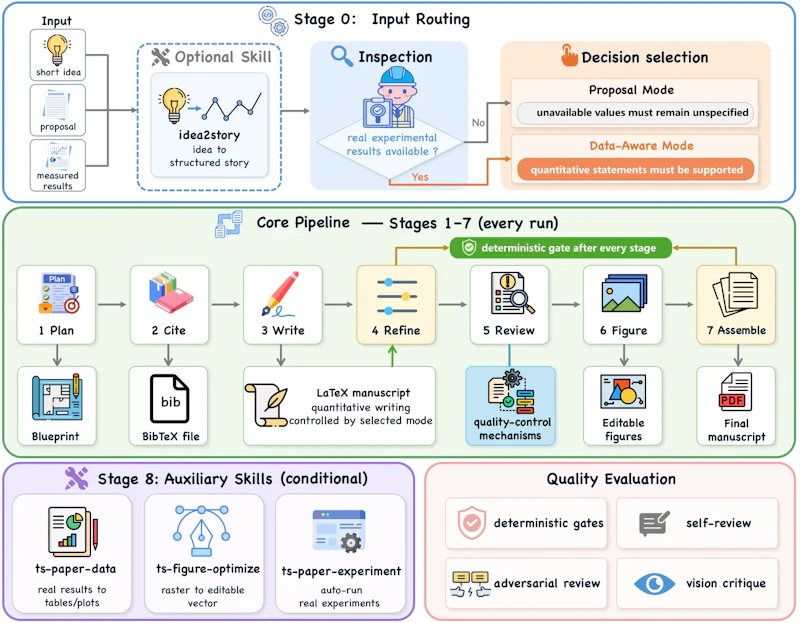
ここで重要なのが、判断と実行の役割分担です。文脈に依存する曖昧な判断はモデルに任せ、正しさを検証できる操作は決定的なツール(プログラムによる自動処理)に任せます。この切り分けにより、モデルが自由に振る舞える範囲を意図的に狭め、検証可能な部分は機械的に確認するという仕組みを実現しています。
証拠を先に決める設計
捏造を防ぐ鍵は、実験の計画と結果の報告を明確に分離したことにあります。従来のやり方では、モデルが結果を見ながら都合よく主張を組み立てられました。Spark-to-Paperでは、結果を観測する前に「どの主張を裏付けるには、どんな証拠が必要か」を先に規定します。
そのうえで実際に実験を行い、測定された結果に沿って原稿の主張を修正します。証拠が先、結論は後という順序を強制することで、裏付けのない断定が入り込む余地を減らしているわけです。
この設計の効果は数値にはっきり表れています。単発の生成では主張の捏造を14%しか検出できなかったのに対し、システム全体を通すと92%まで検出率が向上しました。加えて、敵対的な査読(あえて粗探しをする厳しいチェック)でも74%の精度を確保しています。
もう1つ興味深いのが「自己反駁ループ」への対策です。これは、実験を繰り返すうちにモデルが当初の研究目的そのものを否定し続けてしまう失敗パターンを指します。Spark-to-Paperは決定的な整合性チェックと自己批判を組み合わせ、このループが暴走しないよう歯止めをかけています。
編集可能な図表の生成
論文の図表は、後から手直しできることが実用上とても大切です。Spark-to-Paperは図の役割に応じて生成方法を使い分けます。実験で測定した結果は、決定的な作図処理を経てそのままベクトル形式のPDFとして出力します。ベクトル形式なので、拡大しても劣化せず編集も容易です。
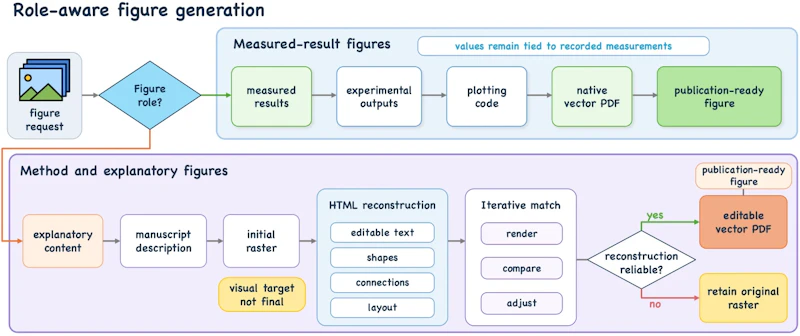
一方、手法の概念を説明する図は、いったんラスター画像(点の集まりで表す通常の画像)を目標として作り、それをHTMLで反復的に再構築してベクトル形式へ書き出します。再構築が不安定な場合は、元のラスター画像に戻す仕組みも備えています。この工夫により、図表の96.4%が編集可能な状態で生成されました。
実験結果
Spark-to-Paperの性能を主要な指標でまとめると、次のようになります。捏造検出をはじめ、実用性を左右するコストや時間まで含めて評価されている点が特徴です。
指標 | 結果 |
|---|---|
引用の正確性 | 99.5% |
図表の編集可能性 | 96.4% |
捏造検出率(単発 → 全体) | 14% → 92% |
敵対的査読の精度 | 74% |
1本あたりのコスト | 8.1ドル |
平均生成時間 | 3.2時間 |
トークン消費量 | 1190万トークン |
引用の正確性99.5%は、存在しない文献をでっち上げる「引用のハルシネーション」がほぼ抑えられていることを示します。1本あたり8.1ドル・3.2時間というコストは、人間が同じ作業を行う場合と比べて桁違いに安く、短時間です。
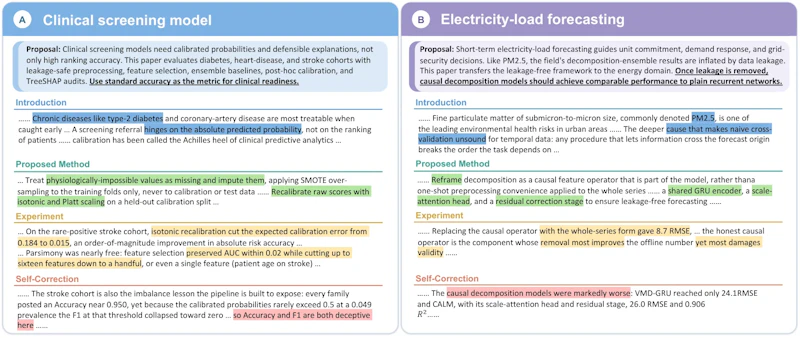
ケーススタディでは、短い提案を1本入力するだけで、異なる分野のデモ論文が生成される様子が示されています。当初モデルが抱いていた誤った想定が、実験を通じて修正されていく過程も確認できます。
まとめと今後の展望
Spark-to-Paperは、論文執筆という複雑な作業を13個の合成可能なスキルへ分解し、既存のコーディング支援ツール上で軽量に実装したシステムです。判断はモデルに、検証はツールにという役割分担と、証拠を先に決める設計によって、捏造検出率を14%から92%へ大きく引き上げました。
一方で、論文自体は他システムとの直接的な性能比較を示しておらず、生成される研究の科学的な新規性や妥当性をどこまで人間が信頼できるかは、今後さらに検証が必要な論点です。敵対的査読の精度74%という数値も、まだ改善の余地があることを物語っています。
とはいえ、実験計画と結果報告を分けるという発想は、AIによる研究自動化における捏造問題への具体的な処方箋として意義があります。専用基盤を作らず既存ツール上でスキルとして組み上げる方針も、再現や拡張のしやすさという点で参考になるでしょう。
論文情報: "Spark-to-Paper: End-to-End Research Paper Generation as a Composable Skill"(Zhuoyang Qian et al., 2026) arXiv:2608.11924
本記事の図(図1〜図3)は解説のため上記論文より引用しています。


