 AI-Papers
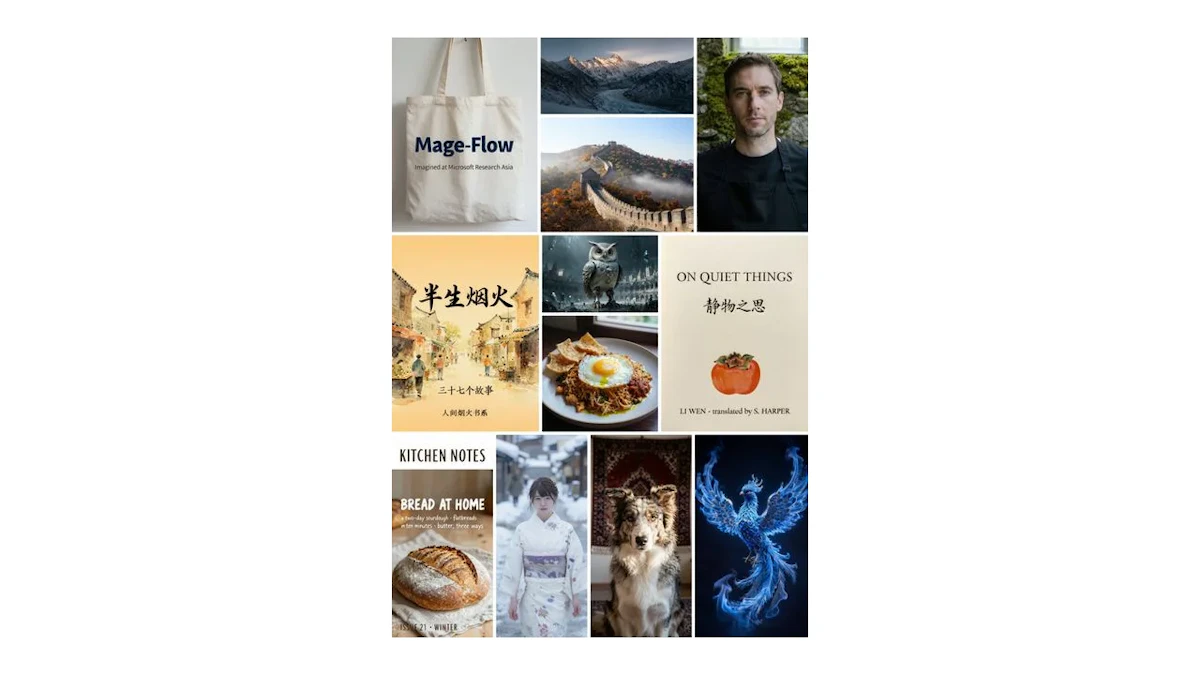
- 4BパラメータのMage-Flowが1024²解像度の生成を0.59秒、編集を1.02秒で処理しGenEval 0.88を記録
- 軽量トークナイザMage-VAEはFLUX.2-VAE比で符号化12分の1、復号22分の1の計算量に削減
- 可変長トークンのパッキングにより512〜2048pxを固定バケットなしで学習し、学習速度を約2.5倍に改善
研究の背景
テキストから画像を生成するモデルは年々大型化しています。FLUX.2-devは32B、Qwen-Imageは20B、HunyuanImage-3.0にいたっては80Bのパラメータを持ちます。
品質は確かに向上しましたが、1枚の生成に数秒から数十秒かかり、GPUメモリも数十GB必要になりました。個人開発者が手元の環境で動かすのは現実的ではなくなっています。
もうひとつの見落とされがちなボトルネックがトークナイザです。拡散モデルは画像をそのまま扱わず、VAE(変分オートエンコーダ。画像を圧縮した潜在表現に変換する仕組み)を通してから処理します。従来のVAEは解像度が上がるほど符号化と復号のコストが急増し、学習全体のスループットを押し下げていました。
Mage-Flowは、この2点に同時に手を入れた4Bの基盤モデルです。テキストからの画像生成と、指示文による画像編集を1つのバックボーンで扱う点も特徴になっています。
軽量トークナイザ Mage-VAE
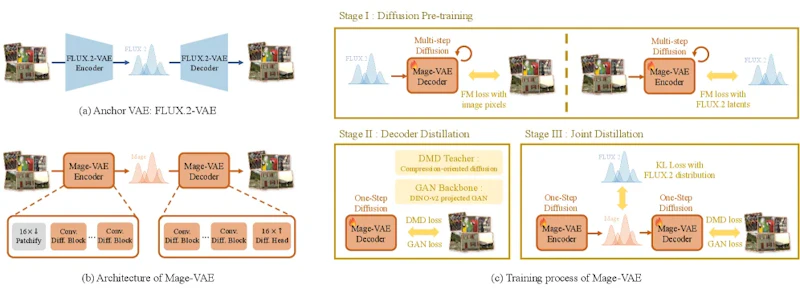
Mage-VAEは、拡散モデルの考え方をVAE自体に持ち込んだ設計です。エンコーダもデコーダも「1ステップの拡散モデル」として構成されており、畳み込みベースの拡散ブロックを積み重ねた軽量な構造になっています。反復的なノイズ除去を行わないため、1回の順伝播で符号化と復号が完了します。
もう一つの鍵がアンカー潜在正則化です。通常のVAEは潜在分布を標準正規分布に近づけますが、Mage-VAEはFLUX.2-VAEが作る潜在分布を「アンカー(基準)」として、そちらに寄せるよう学習します。これにより、生成モデルが扱いやすい潜在空間の構造を保ったまま軽量化でき、下流の生成器ではFLUX.2-VAEと差し替えて使うこともできます。
効率面の成果は明確です。1画素あたりの符号化はFLUX.2-VAE比で約12分の1、復号は約22分の1のMAC(掛け算と足し算をまとめて数える演算量の単位)まで下がりました。それでいてCLIC 2020データセットでの再構成品質はPSNR(元画像をどれだけ忠実に復元できたかを示す指標。数値が高いほど忠実)36.61、SSIM 0.9450、LPIPS 0.0148と実用的な水準を保っています。
ネイティブ解像度への対応
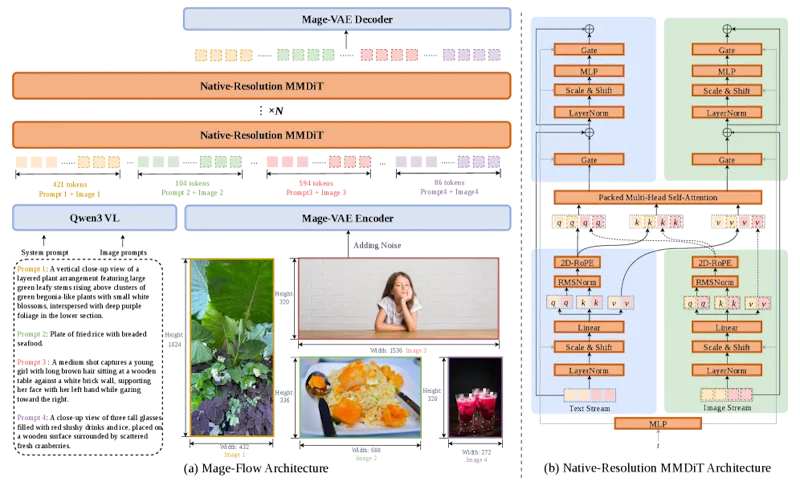
従来の学習では、画像を「1024×1024」「768×1344」といった決まったサイズのバケットに振り分けるのが一般的でした。Mage-FlowのMultimodal Diffusion Transformer(MMDiT)はこのバケットを廃し、それぞれの画像を元のアスペクト比のまま可変長のトークン列に変換します。
複数のサンプルは、一定のトークン予算のもとで1つの連続したバッチに詰め込まれます。パディング(無駄な埋め草トークン)が発生しないので、計算資源が有効に使われる仕組みです。位置情報はサンプルごとの2D回転位置埋め込みで与えられ、注意計算にはFlashAttentionの可変長版(メモリ効率を高めたアテンション計算の実装)が使われます。編集タスクでは、元画像と出力画像を区別するためのフレーム次元が追加され、位置インデックスが3次元に拡張されます。
この設計により、512pxから2048pxまで、さらに512×2048のような4対1の極端な縦横比までを1つのモデルで扱えるようになりました。生成の学習にはrectified flow matching(ノイズから画像へできるだけ真っ直ぐな経路をたどるように学習する手法)が用いられています。
データと学習パイプライン
学習データの規模も相応です。生成側は約100億件のWeb上の画像とテキストの組から、フィルタリングと重複除去を経て約13億件を残しました。キャプションはQwen3-VLによって、次の4段階の粒度で付与されています。
- 語句レベル
- 実体レベル
- 構図レベル
- 写真的記述
粒度を使い分けることで、短い指示にも詳細な描写にも対応できる学習データが整います。編集側は公開データと自社合成を合わせた約9000万件の三つ組(元画像、指示文、目標画像)から出発し、3つのQwen3.5-9B審査モデルの多数決で4500万件まで絞り込みました。
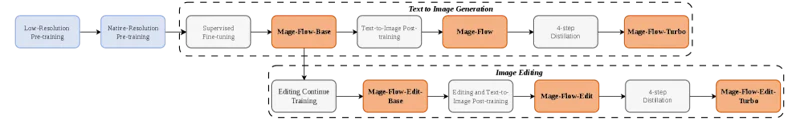
学習は低解像度からネイティブ解像度へ段階的に進み、教師ありファインチューニングでベースモデルを作ります。そこから生成側は強化学習の一種であるDiffusion-NFTで指示追従性やテキスト描画を磨き、4ステップ蒸留でTurbo版を作る流れです。編集側も同じベースから分岐します。
学習インフラの改善によりモデルFLOP利用率は33.20%から77.26%へ上がり、ピークメモリは175.45GBから141.44GBへ減少しました。全体では2.49倍の高速化を達成しています。
実験結果
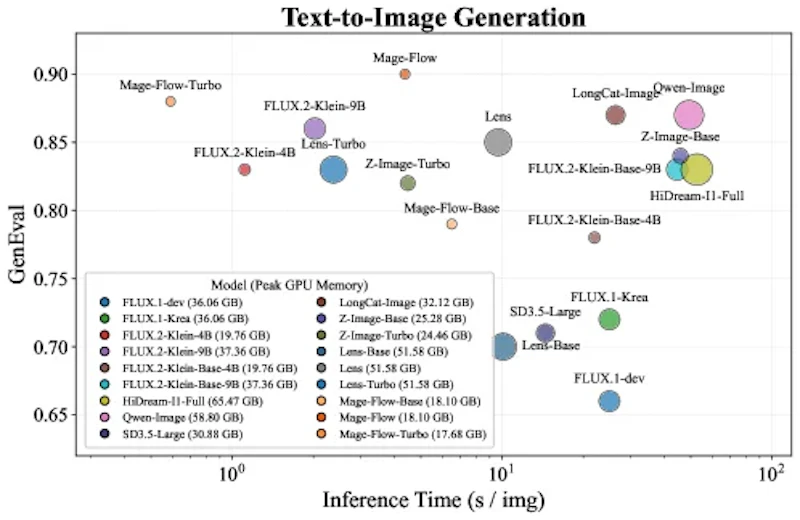
4ステップのMage-Flow-Turboは、GenEval(プロンプトどおりの物体や属性が描けているかを測る評価)で0.88、DPG-Benchで85.48を記録しました。中国語を含む長文テキスト描画の評価でもLongText-ENが0.911、LongText-CNが0.801と高い数値を示しています。
編集側のMage-Flow-Edit-Turboは、GEdit-Bench-ENで8.271、GEdit-Bench-CNで8.264、ImgEditで4.38という結果でした。速度面では単一のA100 GPUで以下のとおりです。
モデル | ステップ数 | 1024²の推論時間 |
|---|---|---|
Mage-Flow | 30 | 4.37秒 |
Mage-Flow-Turbo | 4 | 0.59秒 |
Mage-Flow-Edit | 30 | 10.55秒 |
Mage-Flow-Edit-Turbo | 4 | 1.02秒 |
比較対象のFLUX.2-devは、メモリ要件の関係でA100を2枚使わないと評価できなかったと報告されています。4Bという規模でありながら、品質と速度とメモリのバランスで有利な位置を占めていることがわかります。
まとめと今後の展望
Mage-Flowは、モデルを大きくする以外の方向で品質と効率を両立させた事例といえます。トークナイザの計算量を1桁以上削り、解像度バケットを廃して学習効率を上げるという地味な改善の積み重ねが、4Bという規模での1秒以内の生成につながりました。推論効率の追求という点では、OrbitQuantのような量子化による高速化とも方向性が重なります。
一方で注意すべき点もあります。Turbo版は4ステップまで蒸留する代わりに、一部のベンチマークで通常版よりスコアが下がります。論文自身も、敵対的ガイダンスの効果は一律ではなくベンチマークによって差が出ると認めています。また、報告されている速度やメモリの数値は著者らの計測環境に基づくもので、他の実装や量子化条件では結果が変わりうる点も考慮が必要でしょう。
それでも、生成と指示ベース編集を1つのモデルで扱え、単一GPUで動く規模に収まっているという設計は、実務での採用ハードルを大きく下げます。科学図表向けにファインチューニングしたMage-Flow-SciFormaが9B規模のベースラインに匹敵したという報告もあり、用途特化での展開にも余地がありそうです。
論文情報: "Mage-Flow: An Efficient Native-Resolution Foundation Model for Image Generation and Editing"(Xinjie Zhang et al., 2026) arXiv:2607.19064, CC BY 4.0
本記事の図(図1〜図4)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


