 AI-Papers
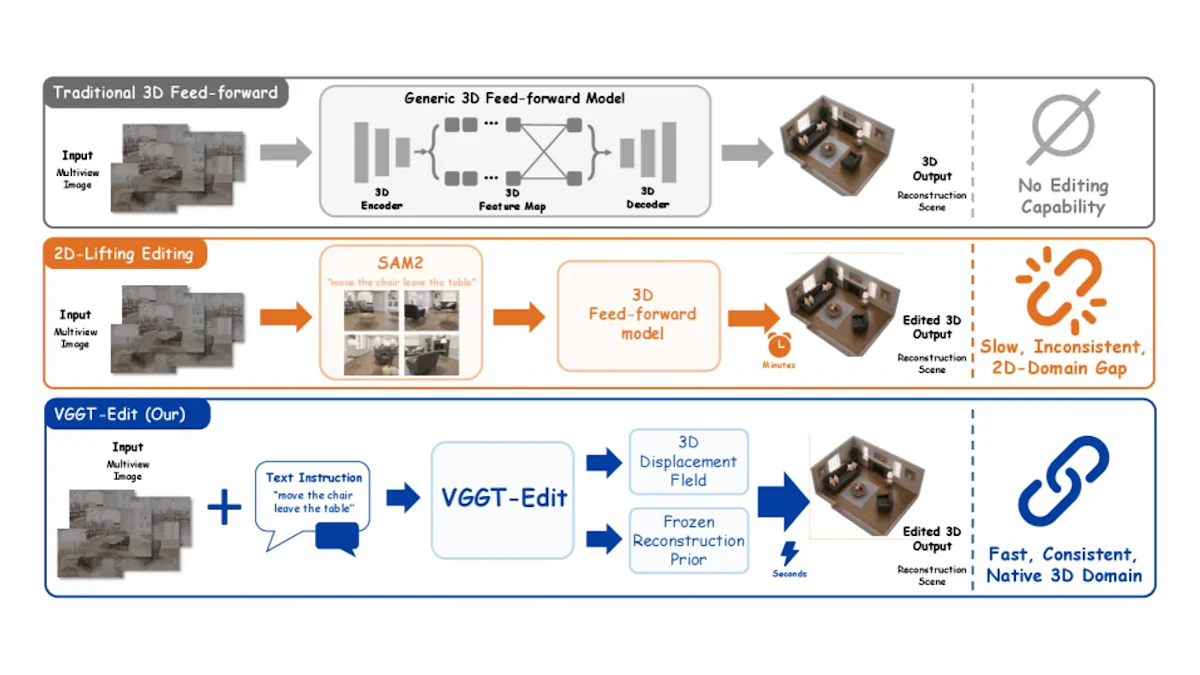
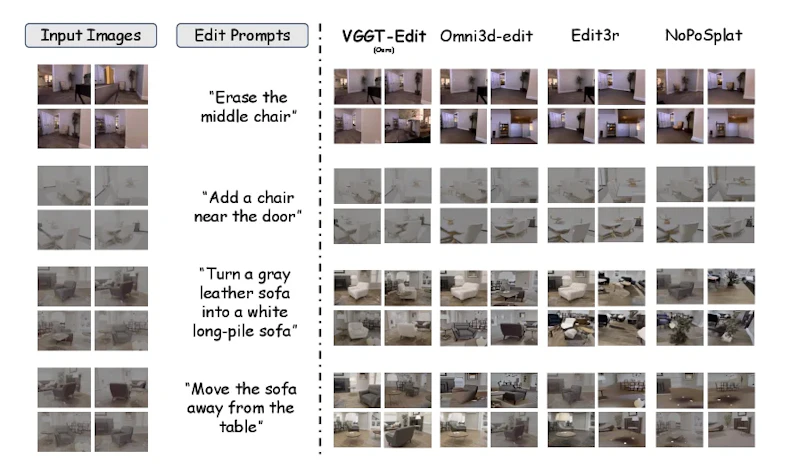
- テキスト指示のみでオブジェクトの追加・削除・変換・移動を約5秒で完了するフィードフォワード3D編集フレームワーク
- 深度同期テキスト注入とレジデュアル変換ヘッドで、2Dリフティング手法のテクスチャ不鮮明・多視点不一貫性を根本解決
- 新規構築のDeltaSceneデータセット(約10万ペア)でCLIP Score 30.2・C-FID 122.4という最先端性能を達成
研究の背景と課題
3Dシーンの編集は、ゲーム開発や映像制作、建築可視化など幅広い分野で需要が高い技術です。しかし従来の手法は、2D画像生成モデルを用いてシーンをリフティング(2D→3D変換)するアプローチが主流であり、テクスチャのぼやけや多視点間の不一貫性といった問題が常につきまとっていました。
さらに最適化ベースの手法では、Score Distillation Sampling(SDS、スコア蒸留サンプリング)と呼ばれる反復的な最適化処理が必要で、1シーンの編集に数百秒を要することも珍しくありません。リアルタイムに近い編集体験を実現するには、設計の根本的な見直しが求められていました。
DeltaSceneデータセットの構築
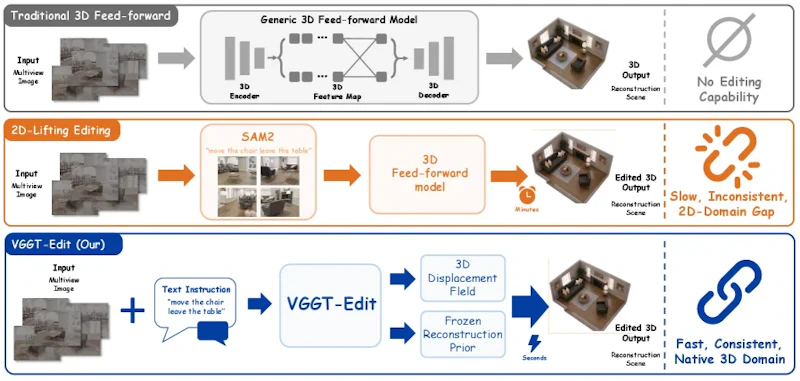
VGGT-Editを学習させるため、研究チームはDeltaSceneデータセットを新たに構築しました。Replica、ScanNet、ScanNet++という3つの室内シーンデータソースから、約9万5,000ペアの訓練データと500ペアのテストデータを生成しています。
データ生成パイプラインの核心は、LLM(大規模言語モデル)とVLM(視覚言語モデル)を組み合わせた多段階フィルタリング機構にあります。Qwen3.5-Plusによる自然な編集指示の生成、VLMによる対象物の視認性確認、そして2Dマスクを3D空間に投影して多視点一貫性を検証する「3Dコンセンサスフィルタリング」の3ステップを経ることで、高品質なペアデータのみを選別しています。対応する編集操作は「追加(Add)」「削除(Delete)」「変換(Modify)」「移動(Move)」の4種類で、これらを組み合わせた複合的な編集にも対応できる設計です。
VGGT-Editのモデルアーキテクチャ
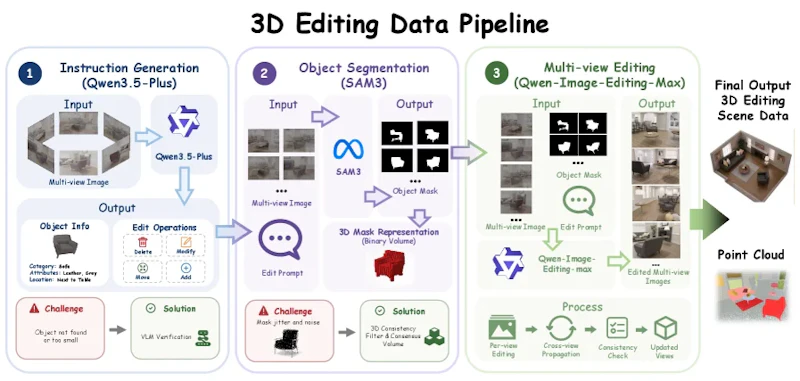
VGGT-EditはVisual Geometry Grounded deep structured Transformer(VGGT)を基盤として構築されており、3つの主要コンポーネントが連携して動作します。
第1の「深度同期テキスト注入(Depth-Synchronized Text Injection)」は、テキスト埋め込みをバックボーンの複数のTransformerレイヤーに同期的に注入する仕組みです。テキストの意味情報が空間的な幾何学情報の形成段階に合わせて注入されることで、セマンティックなガイダンスと3D構造が適切に整合します。
第2の「レジデュアル変換ヘッド(Residual Transformation Head)」は、元の3Dポイントマップに対する差分変位(ΔP)のみを予測します。編集対象領域にのみ変位を適用し、静的な背景はベースジオメトリをそのまま保持する設計であるため、編集によるノイズや背景歪みを根本から抑えることができます。
第3の「ビューアウェア重要度重み付け(View-Aware Importance Weighting)」は、可視マスク面積や境界比、バックボーンの信頼スコアに基づいて各視点の重みを動的に調整します。この機構により、遮蔽領域付近での境界ノイズや人工的なアーティファクトを効果的に抑制できます。
実験結果と性能評価
定量評価では、CLIP Score(テキストと画像の一致度)30.2、C-FID(生成品質を測るFréchet Inception Distance)122.4、C-KID 0.048を達成し、比較したすべてのベースライン手法を上回っています。CLIP Scoreは最良のベースライン比で1.3ポイント向上し、C-FIDはこれまでの最低値を更新しました。
推論速度の面では、最適化ベース手法のEditSplatが約600秒を要するのに対し、VGGT-Editの処理はわずか約5秒で完結します。これは従来手法と比べて2倍から120倍の高速化に相当し、SDS最適化が不要なフィードフォワード設計の優位性が、この数値差に集約されています。
アブレーション研究の知見
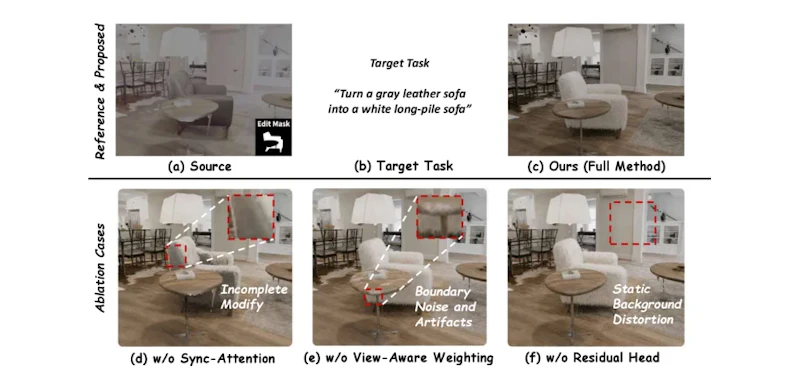
各コンポーネントの寄与を検証するアブレーション実験では、深度同期テキスト注入を除去するとCLIP Scoreが28.1に低下し、素材変更が不完全になることが確認されています。ビューアウェア重み付けを外すと27.8まで低下し、遮蔽領域付近に境界ノイズやアーティファクトが生じました。レジデュアルヘッドを取り除いた場合はCLIP Score 29.5と比較的高い値を維持するものの、C-FIDが131.4まで悪化し、静的な背景に微妙な歪みが現れることもわかっています。
特にレジデュアルパラダイムは「背景ドリフト」の防止に顕著な効果をもたらしており、変位をゼロから予測するフルリグレッション設計と比べ、編集範囲外の領域の安定性が大きく向上しています。
まとめと今後の展望
VGGT-Editは、テキスト指示による3Dシーン編集においてフィードフォワード推論の実用性を証明した研究です。深度同期テキスト注入とレジデュアル変換ヘッドという2つの設計の組み合わせにより、品質・速度・多視点一貫性のバランスを高い次元で両立しています。
3D空間での多視点一貫性を追求する研究という観点では、TrackCraft3Rによる密な3D追跡手法も注目を集めており、こうした手法との組み合わせによるさらなる発展も期待されます。
現状では室内シーンが中心ですが、屋外環境や動的物体を含む複雑なシーンへの拡張が実現すれば、リアルタイムに近い3D編集ワークフローの普及に向けて大きな一歩となるでしょう。
論文情報: "VGGT-Edit: Feed-forward Native 3D Scene Editing with Residual Field Prediction"(Kaixin Zhu et al., 2026) arXiv:2605.15186, CC BY 4.0
本記事の図(図1、図2、図4、図5、図7)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


