 AI-Papers
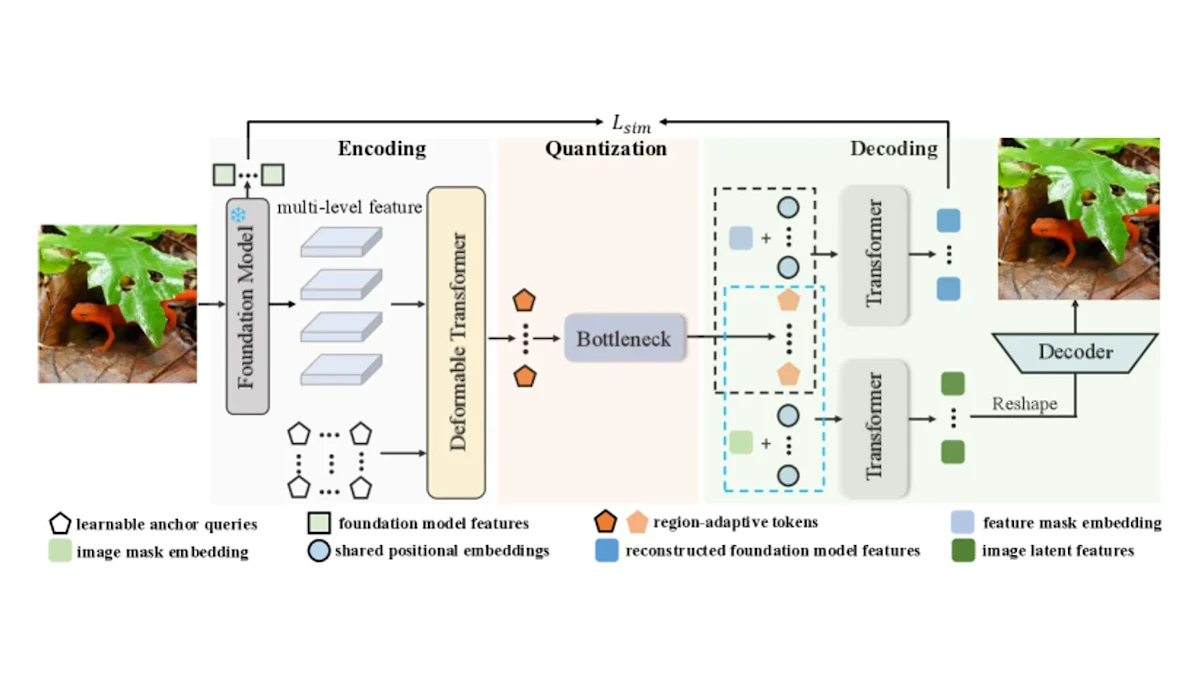
- 凍結した視覚基盤モデル(VFM)を画像トークナイザーとして転用し、ImageNetでgFID 1.36(離散)・1.25(連続)のSoTA性能を達成
- 変形可能Transformerによる領域適応的量子化で576トークンを256トークンへ削減し、バニラVQGANより3倍速く収束
- Classifier-Free Guidanceなしで推論でき推論速度を最大4倍高速化。DINOv2・SigLIP2が最も効果的なVFMと判明
研究の背景
画像生成モデルの品質と速度を大きく左右するのが「トークナイザー」です。これは画像を生成モデルが扱いやすい離散または連続の数値列(トークン)に変換するエンコーダーであり、VQGAN(Vector Quantized GAN)がその代表例として広く使われてきました。
従来のトークナイザーはゼロから学習するか、画像再構成タスクのみで最適化されることが多く、「画像の意味的な構造を豊かに表現できるか」という点では限界がありました。一方で、DINOv2やSigLIPといった視覚基盤モデル(VFM: Vision Foundation Model)は、大規模な自己教師あり学習や言語監督学習により、画像の高度な意味表現をすでに獲得しています。
そこで問われたのが「すでに優れた表現能力を持つVFMを、そのまま画像トークナイザーへ転用できないか」という問いです。VFMTokはこのアイデアを具体化した研究であり、VFMのパラメータを一切更新しない(凍結する)まま、高精度なトークナイザーとして機能させることに成功しました。
VFMTokの核心:領域適応的量子化
従来の画像トークナイザーは、画像を均等なグリッドに分割してトークンを生成します。しかしこの方式では、空が広がる背景のような「均質な領域」でも細かいグリッドを敷いてしまい、冗長なトークンが生まれます。
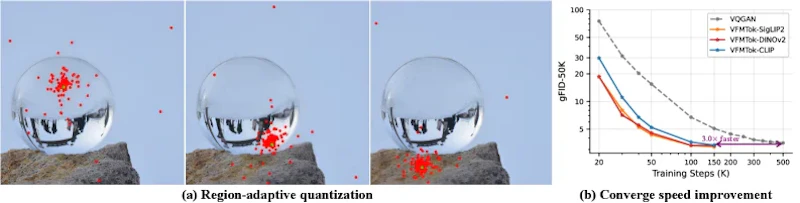
VFMTokが採用する領域適応的量子化(Region-Adaptive Quantization)は、この問題を解消します。変形可能Transformer(Deformable Transformer)と学習可能なアンカークエリを組み合わせ、画像内の意味的に類似した領域をまとめてサンプリングし、各領域のVFM特徴を抽出します。これにより、元々576個あったトークンを256個に削減しつつ、再構成品質を維持できます。
フレームワーク全体の構造
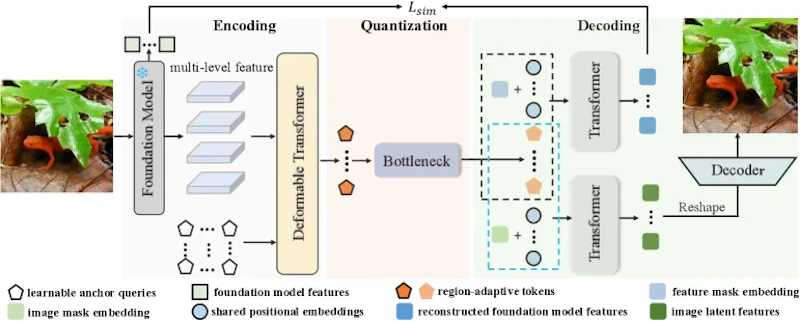
VFMTokのパイプラインは大きく3段階に分かれます。まず凍結済みVFMから多階層の特徴マップを抽出し、次に変形可能Transformerがこれらを学習可能なグリッドクエリで処理して領域適応トークンを生成します。そして「ボトルネック」を通じてトークンをデコーダーへ渡す流れです。
ボトルネックは用途に応じて2種類を選択できます。自己回帰型生成モデル向けには離散的なベクトル量子化(VQ)を使う「VFMTok」、拡散モデルや流れ推定モデル向けには連続値を扱う「VFMAE」です。どちらも同一のアーキテクチャ設計を共有しており、用途に応じて切り替えられる汎用性を備えます。
デコーダーは2種類の再構成を同時に行います。一方はVFMの最終層出力との類似度を最大化する「セマンティック再構成」であり、もう一方は画像ピクセルへの「ピクセル再構成」です。この双方向の学習目標が、意味的な忠実性と視覚的な品質を両立させます。
学習損失としては、次の4つが組み合わされています。
- ピクセル再構成損失
- LPIPS知覚損失
- GAN敵対的損失
- VFM特徴とのコサイン類似度損失
これらを併用することで、画素レベルの忠実さと意味レベルの一貫性が同時に確保されます。
また、この研究ではどのVFMが最適かも体系的に評価しています。DINOv2-L(潜在マスク画像モデリングを組み合わせた自己教師あり学習)とSigLIP2-L(グローバルコントラスト学習と潜在マスク画像モデリングを兼ね備えた言語監督学習)が最も高い効果を示しました。InsightTokのようなコンテンツ対応トークナイザーと同様に、「どのような事前学習目標を持つモデルを使うか」が生成品質を左右するという知見は、今後の画像トークナイザー設計に重要な示唆を与えます。
実験結果:SoTAを達成
ImageNet 256×256を使ったクラス条件付き画像生成の評価では、VFMTokは最先端の性能を達成しました。主な指標は次の通りです。
指標 | VFMTok(離散・AR) | VFMAE(連続) |
|---|---|---|
生成FID(gFID) | 1.36 | 1.25 |
再構成FID(rFID) | 0.89 | - |
コードブック使用率 | 100% | - |
gFIDは離散・連続のいずれのモードでも既存手法を上回りました。従来のVQGANバリアントでよく問題となる「コードブックの一部しか使われない」現象が解消され、コードブック使用率が100%に達している点も実用上の利点です。
収束速度もバニラVQGANと比較して3倍速くなっています。学習に必要な計算資源が削減できるため、実験サイクルを大幅に短縮できます。
さらに、推論時に一般的な品質向上テクニックであるClassifier-Free Guidance(CFG)を使わなくても競争力のある品質を維持します。CFGは通常、1回の推論あたり2倍の計算コストを要しますが、VFMTokはそれなしで動作します。このCFG不要による削減と、576トークンから256トークンへのトークン数削減が組み合わさり、推論速度は最大4倍まで高速化されました。
まとめと今後の展望
VFMTokは、大規模なVFMに蓄積された豊かな視覚表現を「凍結したまま」画像生成パイプラインへ持ち込むという、シンプルでありながら効果的なアプローチを示しました。領域適応的量子化によるトークン数削減、セマンティック再構成目標による品質向上、CFG不要での高速推論という3つの特性が組み合わさり、実用性の高い手法となっています。
課題としては、VFMTokが依存するVFM自体の選択や事前学習の質に性能が左右される点が挙げられます。また今回の評価はImageNetのクラス条件付き生成に集中しており、テキスト条件付き生成や動画生成への拡張における有効性は今後の検証が必要です。より大規模なVFMへの適用や、マルチモーダルな生成タスクへの展開が、次の研究方向として期待されます。
論文情報: "Vision Foundation Models as Generalist Tokenizers for Image Generation"(Anlin Zheng et al., 2026) arXiv:2605.18390, CC BY 4.0
本記事の図(図1〜図2)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


