 AI-Papers
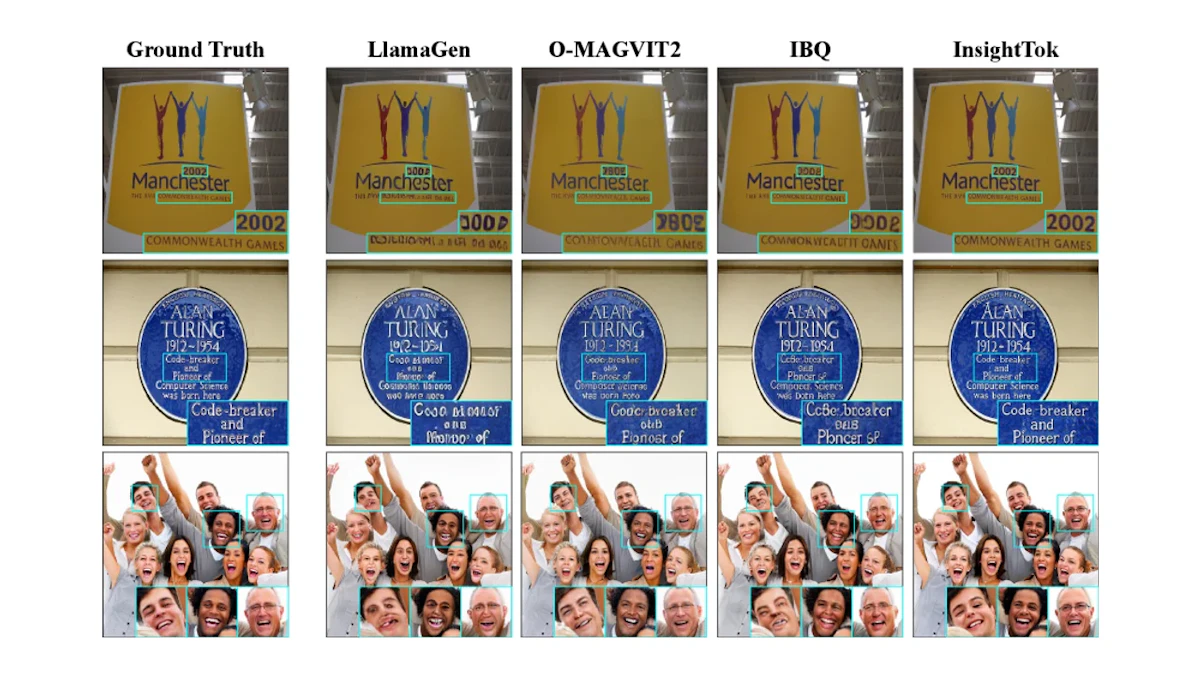
- コンテンツ対応の局所知覚損失をトークナイザ訓練に組み込み、16kコードブック・16倍ダウンサンプリング制約下でNEDベースの文字認識精度(1−NED)95.83%を達成
- ArcFaceを用いた顔アライメント損失により、131kコードブックを持つEmu3.5-IBQを上回る顔類似度スコアを実現
- GitHubにコード・モデルチェックポイントが公開済みで、InsightARシステムとの統合による生成品質向上を実証済み
研究の背景
自己回帰型画像生成(Autoregressive Image Generation)とは、画像をトークン列として扱い、言語モデルと同じ方式で逐次的に次のトークンを予測しながら画像を生成する手法です。大規模言語モデルの訓練方式との親和性が高く、近年急速に研究が進んでいます。
この手法の品質を左右するのが、連続画像を離散トークン列に変換するトークナイザの性能です。標準的な手法では画像を16分の1に縮小(16倍ダウンサンプリング)し、16,384エントリのコードブック(離散表現の辞書)に量子化します。
しかしこの過程で、テキスト文字の輪郭が潰れて判読不能になったり、顔の繊細なディテールが失われたりする問題が起きていました。
清華大学 LeapLab が提案するInsightTokは、この問題に取り組んだコンテンツ対応トークナイザです。既存の制約(16kコードブック・16倍ダウンサンプリング)を維持したまま、テキストと顔の再現精度を大幅に改善します。
提案手法の概要
InsightTokの核心は、標準的なトークナイザ損失に「局所コンテンツ対応知覚損失(Localized Content-Aware Perceptual Loss)」を追加する点です。損失関数全体は次のように構成されます。
全体損失 = 画像レベル損失(再構成・コードブック・知覚・敵対的)+ α₁×テキスト損失 + α₂×顔損失
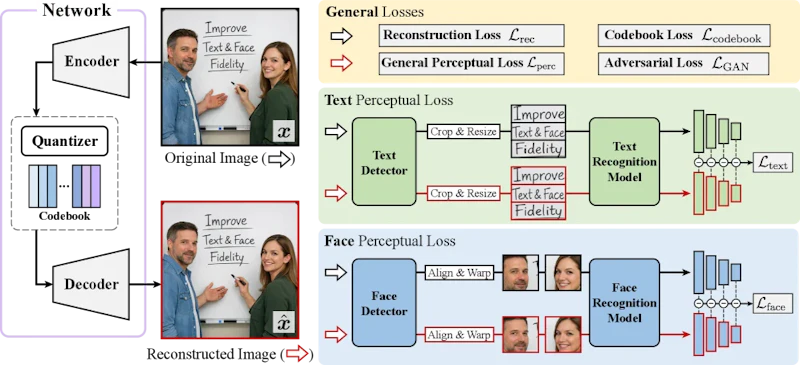
テキスト損失(ℒ_text)では、差分可能な二値化処理で画像内のテキスト領域を検出し、元画像と再構成画像から対応するパッチを切り出します。そのパッチを5層の隠れ層を持つ事前学習済み文字認識ネットワークに通し、特徴空間での差分を損失として計算します。
極端に小さい文字インスタンスが学習を支配するのを防ぐため、各テキスト領域の面積比を重みとして用いるのがポイントです。
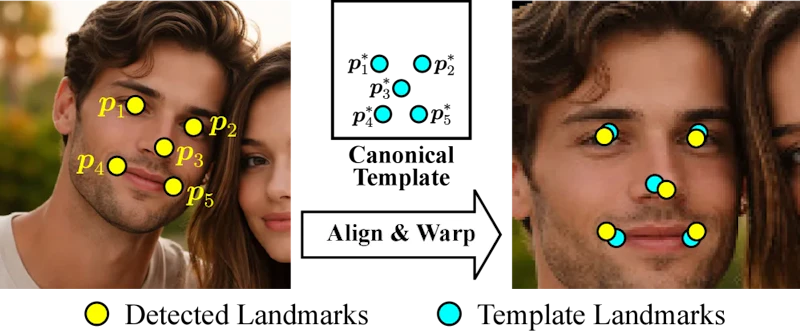
顔損失(ℒ_face)では、まず顔検出で5つのランドマーク(目・鼻・口角)を特定し、最適ランドマーク対応に基づく類似変換で顔領域を正準テンプレートにアライメントします。ポーズや拡大率のばらつきを除去した後、ArcFace(顔認識モデル)に通してアイデンティティ保存の観点から監督します。こちらも面積比に基づく重み付けを採用しています。
顔アライメントの仕組み
訓練は3段階で実施されます。第1段階として標準損失のみで20万ステップ学習し、第2段階でテキスト・顔損失を追加した4万ステップ、第3段階としてデコーダの精緻化に4万ステップを費やします。モデル全体のパラメータ数は4億2600万、埋め込み次元は256です。
再構成品質の評価
画像再構成品質の評価には自己回帰型生成モデルの評価に広く使われる指標群に加え、テキストや顔に特化したTokBenchが用いられました。
テキスト再構成精度では、IBQ-16kの2.28%に対してInsightTokは16.44%を記録しました。顔類似度は平均スコア0.36で、コードブックが8倍以上大きい(131kエントリ)Emu3.5-IBQをも上回っています。主な数値は次の表のとおりです。
指標 | InsightTok | 比較対象 |
|---|---|---|
テキスト再構成精度 | 16.44% | IBQ-16k: 2.28% |
顔類似度(平均スコア) | 0.36 | 131kエントリのEmu3.5-IBQを上回る |
PSNR(画素単位の再現度) | 23.64 | 既存手法と同水準 |
rFID(再構成画像の分布のずれ) | 0.69 | 既存手法と同水準 |
テキスト再構成精度の伸びは、論文が報告する評価全体の平均では28.89ポイントの改善にあたります。PSNRは値が大きいほど、rFIDは値が小さいほど再現性が高いことを示す指標で、この2つが既存手法の水準にとどまっている点から、テキストと顔の改善が全体の画質を犠牲にしていないことが読み取れます。
アブレーション実験では面積加重の重要性が確認されました。非加重で特殊損失を適用した場合、テキスト精度は改善するものの、rFIDが0.60から1.11へと悪化します。面積加重を導入することで、テキスト・顔の品質向上と汎用画像品質の維持を両立できることが示されました。
InsightARとの統合結果
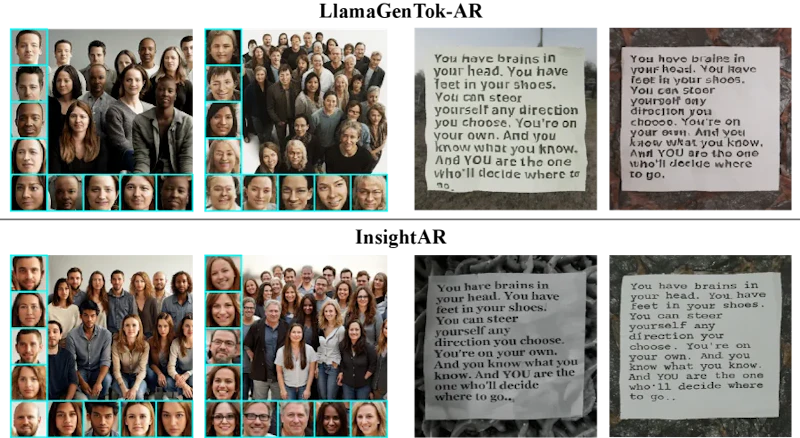
InsightTokをベースに自己回帰型生成システム「InsightAR」を構築し、生成品質を評価しました。テキスト生成の評価には、文字列間のNED(Normalized Edit Distance、正規化編集距離)から算出した認識精度(1−NED)を使っています。結果は次の表にまとめました。
評価項目 | InsightAR | 比較 |
|---|---|---|
テキスト認識精度(1−NED) | 95.83% | LlamaGenTok-AR: 79.86% |
顔品質(MagFaceスコア) | 23.33 | 16倍ダウンサンプリングのモデルで最高値 |
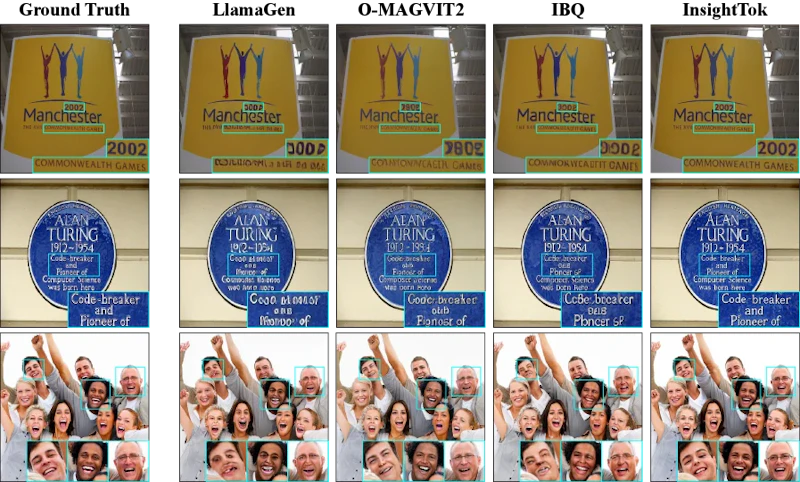
MagFaceは顔画像の品質を測る指標です。テキストの判読性と顔のディテールが実際にどう変わるかは、次の図で比較できます。
まとめと今後の展望
InsightTokは、コードブックサイズやダウンサンプリング率という基本構造を変えることなく、テキスト文字と顔という視覚的に要求の高い領域の品質を引き上げた手法です。コンテンツの種類に応じた局所的な監督信号を訓練に取り入れるというアイデアは、単純な作りながら効果を出しています。
著者たちは顔再現度の向上に伴う悪用リスク(なりすましなど)にも言及しており、透かし(ウォーターマーク)技術の組み合わせや人口統計学的バイアスの監査を推奨しています。コードとモデルチェックポイントはGitHubで公開されており、自己回帰型生成モデルを研究する上で有用なベースラインとなるでしょう。
論文情報: "InsightTok: Improving Text and Face Fidelity in Discrete Tokenization for Autoregressive Image Generation"(Yang Yue et al., 2026) arXiv:2605.14333, CC BY 4.0
本記事の図(図1〜図4)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


