 AI-Papers
- 全注意LLMに内在する疎性を活用し、約1,200ステップの軽量な追加学習だけで疎注意モデルへ変換するRTPurboを提案
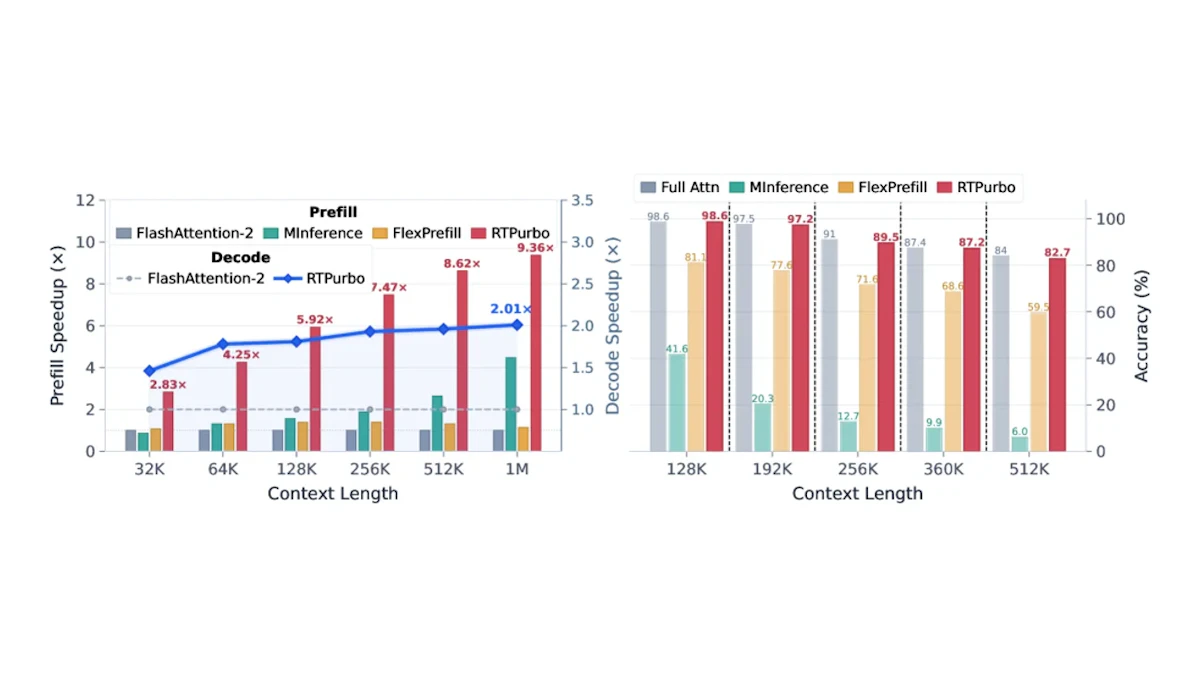
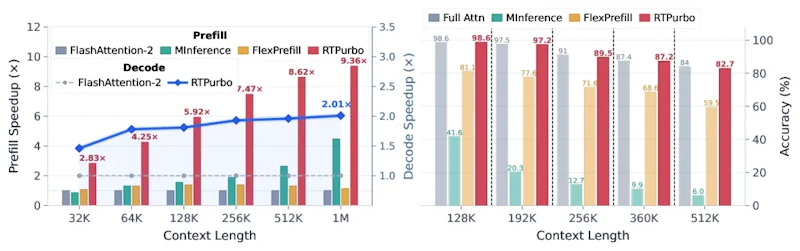
- 100万トークンのプリフィルで最大9.36倍、デコードで2.01倍の推論高速化を精度をほぼ維持しながら達成
- 注意ヘッドをretrieval headとlocal headに分類し、16次元インデクサーによる動的トークン選択を2段階学習で習得
研究の背景と課題
大規模言語モデル(LLM)の基盤であるTransformerの全注意機構(Full Attention)は、シーケンス中の全トークン間の関係を計算します。精度は高い一方で、計算コストがシーケンス長の2乗に比例して増大するため、100万トークンを超える長文脈の推論では実用的な速度を保つのが困難です。
この問題への対応として、事前学習時から疎な注意パターンを組み込む「ネイティブ疎注意モデル」の研究が進んでいますが、膨大な学習コストが必要です。学習なしで疎性を活用する手法(RazorAttn、Minference、SnapKVなど)も存在しますが、長距離の複雑な検索が求められるタスクで精度が落ちる課題を抱えていました。
本論文が提案するRTPurboは、既存の全注意LLMをわずか数百ステップの軽量な追加学習で高精度な疎注意モデルに変換する手法です。「全注意LLMは本質的に疎であり、最小限の適応だけで疎モデルに転換できる」という知見を出発点にしています。
全注意LLMに潜む3つの疎性
RTPurboは、全注意LLMの内部動作に関する3つの観察を組み合わせて設計されています。
第1の観察は注意ヘッドの役割分担です。LLMの注意ヘッドを分析すると、長距離の情報検索(retrieval)を必要とするのは全体の約15%の「retrieval head」に限られます。残りの多数は直近の文脈だけを参照する局所処理を行っており、全トークン分のKVキャッシュを保持するのは過剰です。
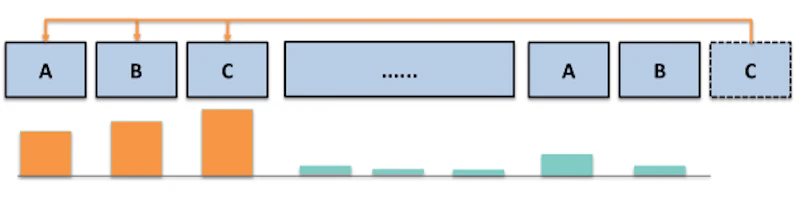
第2の観察は低次元部分空間での検索です。長距離検索はフルサイズのベクトルを使わなくても、わずか16次元の低次元空間で十分に表現できます。これはRoPE(回転位置埋め込み)における低周波成分が、位置によらず安定した意味情報を保持する性質によるものです。16次元の軽量インデクサーで、フル次元の注意計算と同等のトークン選択が実現します。
第3の観察はクエリ依存の動的なトークン予算です。必要なトークン数はクエリの内容によって大きく変わります。単純な検索では468トークンで十分なのに対し、複雑なクエリでは2,462トークンが必要なケースが実験で確認されています。固定のtop-k選択より、確率の累積和が閾値を超えた時点で停止する動的なtop-p選択が実情に即しています。
RTPurboのアーキテクチャ
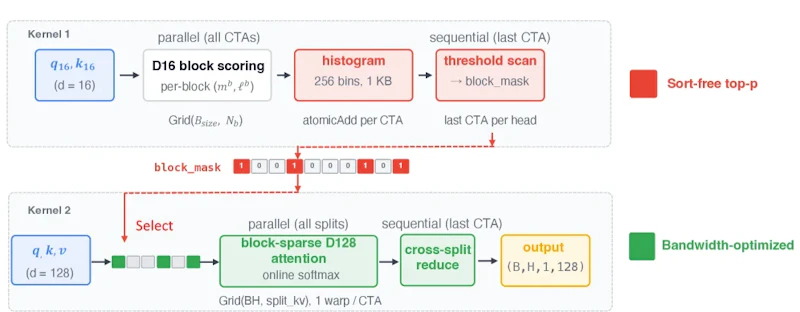
RTPurboはこれら3つの観察を統合した推論フレームワークです。まずオフライン処理として、Needle-in-a-Haystack(NIAH)テストを使ったキャリブレーションで各注意ヘッドをretrieval headとlocal headに分類します。retrieval headはフルKVキャッシュを保持し、local headは8,000トークンのスライディングウィンドウと4つのsinkトークンのみを使用します。
推論時には、retrieval headの各クエリに対して16次元の軽量インデクサー(投影行列WhQ、WhK ∈ ℝ^(16×dh))でKVキャッシュをスキャンし、関連性の高いトークンを動的なtop-p閾値で絞り込みます。選択されたトークンのみでフル次元の注意計算を実施するため、長文脈でも計算コストを大幅に削減できます。また、KVキャッシュのINT2量子化で3倍高速化するOScaRのようなKVキャッシュ圧縮手法とも原理的に組み合わせが可能です。
2段階の軽量学習
RTPurboの学習は合計約1,200ステップで完了します。既存LLMの事前学習と比較して圧倒的に少ないステップ数です。
第1ステージ(低次元射影学習)では、モデルの重みを凍結したまま16次元インデクサーの投影行列のみを学習します。オリジナルの全注意分布と低次元投影後の注意分布のKLダイバージェンスを最小化する損失を使い、約3,000万トークン・600ステップで収束します。
第2ステージ(自己蒸留)では、疎注意を有効にした状態でエンドツーエンドに学習し、全注意の元モデルをteacherとして上位10件のlogitのみを蒸留します。特定のデータセットへの過依存を避けるため、少量(約120万トークン)の汎用データで600ステップを学習するだけで済みます。
実験結果と既存手法との比較
Qwen3-Coder-30B-A3Bなどのモデルを対象に、LongBench、RULER、AIME24/25、MMLU-PROなど複数のベンチマークで評価されました。
精度面では、LongBenchの平均スコアが全注意の53.80%に対してRTPurboは54.24%と同等以上。RULER 64Kでも85.49%(全注意: 86.23%)とほぼ無損失です。AIME24/25では全注意と完全に一致する86.67%を達成しています。
速度面では、100万トークンのプリフィルで最大9.36倍の高速化(32Kでも2.83倍)、デコードで2.01倍の高速化を実現しています。動的疎性はタスクの複雑さに応じて78.7%から89.2%の範囲で自動調整されます。既存手法との比較では、RazorAttn(学習不要だが検索タスクで精度低下)、SnapKV(同一疎性で3.8%の注意損失)、Quest(粗いブロック単位疎性で精度損失)を大きく上回っています。
まとめと今後の展望
RTPurboは、既存の全注意LLMに潜む疎性を体系的に活用し、ネイティブ疎注意モデルの大規模な再学習なしに高速な疎推論を実現する実用的な手法です。約1,200ステップという低い学習コストで100万トークン近くの長文脈に対して10倍近い高速化を達成しながら精度をほぼ維持できる点は、実際のLLMデプロイに直接応用できる価値があります。
課題としては、retrieval headの分類に用いるNIAHキャリブレーションがモデルやタスクによって調整が必要な点、また超長文脈での検索精度保証の定量的な評価が今後の研究で深められる余地があります。長文脈推論の需要が高まる中、既存モデルを低コストで高速化するこのアプローチは今後さらに注目されるでしょう。
論文情報: "Full Attention Strikes Back: Transferring Full Attention into Sparse within Hundred Training Steps"(Yanke Zhou et al., 2026) arXiv:2605.16928, CC BY 4.0
本記事の図(図1、図2、図5)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


