 AI-Papers
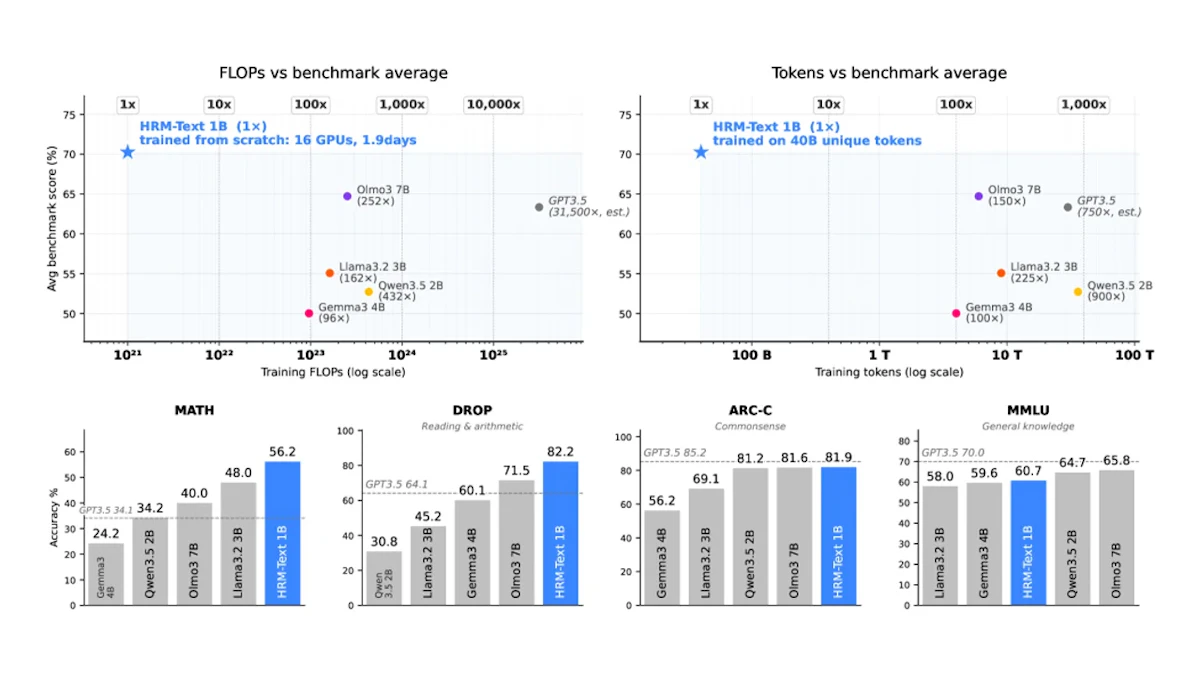
- 1Bパラメータのモデルを約1,500ドル・40Bトークンで学習し、MMLU 60.7%・GSM8K 84.5%という2〜7Bクラスと同等の性能を実現
- 階層型再帰モデル(HRM)が「速い実行層」と「遅い戦略層」に計算を分離し、従来比最大432倍少ない計算量で深い推論能力を獲得
- 指示応答ペアのみを用いたPrefixLM事前学習という新しいアプローチで、生テキスト学習を超える応答品質を達成
研究の背景
大規模言語モデル(LLM)の性能向上には、膨大な計算リソースと学習データが必要とされてきました。GPT-4やLlama 3のような最先端モデルは数百億から数千億のパラメータを持ち、学習コストは数百万ドルに達することもあります。
こうした状況は、企業や研究者がAI研究に参入するうえで高い障壁となっています。「少ない計算コストでより賢いモデルを作れないか」という問いに対し、HRM-Textは新しいアーキテクチャと学習戦略を組み合わせた研究です。
HRMアーキテクチャの仕組み
HRM-Textの核心は、階層型再帰モデル(Hierarchical Recurrent Model, HRM)と呼ばれる二重タイムスケール設計にあります。二重タイムスケールとは、更新の速さが異なる2種類の層を組み合わせる考え方です。
通常のTransformerが全層を均等に扱うのに対し、HRMはLモジュール(速い実行層)とHモジュール(遅い戦略層)という2種類のブロックを交互に積み重ねた構造になっています。
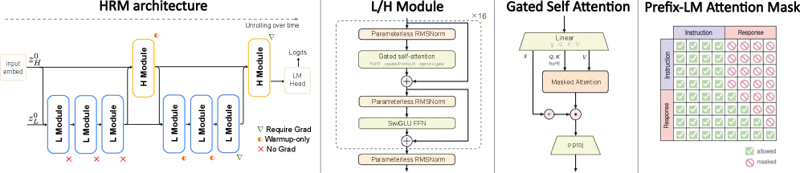
1サイクルの処理では、Lモジュールがトークンレベルのきめ細かな処理を担い、Hモジュールがより抽象的なパターンを蓄積します。前サイクルのHモジュール出力を次サイクルの入力として引き継ぐことで、複数サイクルにわたる深い推論を実現しています。
学習安定化のために「MagicNorm」という独自の正規化手法も導入されました。1Bパラメータでも2〜7Bモデルと同等の表現力を持てるのはこの手法によるものだと論文は説明しています。
PrefixLM事前学習という新戦略
アーキテクチャと同様に重要なのが、学習データと目標関数の設計です。従来のLLM事前学習では、Webテキストをはじめとする膨大な生テキストに対して「次のトークンを予測する」という目標で学習します。
HRM-Textは従来と異なり、指示応答ペアのみを用いた「タスク完了型事前学習」を採用しました。さらにPrefixLMマスクを導入し、指示(質問)部分に双方向注意(Bidirectional Attention)を適用することで、モデルが質問全体を把握してから回答を生成できる構造になっています。
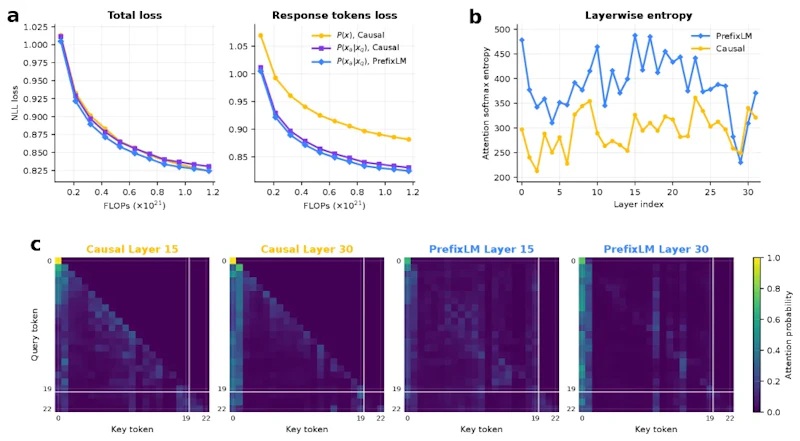
図に示すように、因果的注意が局所的・三角形状のパターンに留まるのに対し、PrefixLMでは指示部全体にわたる大域的な相互作用が生まれています。この設計変更だけで応答トークンの損失が改善されており、生テキスト学習からの脱却が効果的であることを示す結果です。
実験結果と効率の比較
HRM-Text 1Bモデルは16基のGPUで1.9日間(費用換算で約1,500ドル)学習されました。わずか40Bトークンという少量のデータにもかかわらず、主要ベンチマークで次のスコアを達成しています。
ベンチマーク | HRM-Text 1B |
|---|---|
MMLU | 60.7% |
ARC-C | 81.9% |
DROP | 82.2% |
GSM8K | 84.5% |
MATH | 56.2% |
数学の文章題を解くGSM8Kや読解のDROPで8割を超えており、1Bという規模に対して高い水準です。
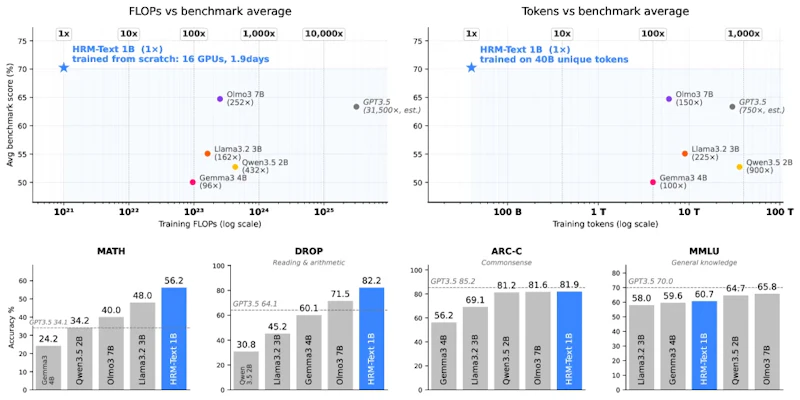
計算効率の面では、同等性能の2〜7Bモデルと比べて最大432倍少ない計算量、最大900倍少ない学習トークン数という結果が論文で報告されています。LLMの効率化という観点では、OScaRのようなKVキャッシュ量子化による推論高速化とは異なり、HRM-Textは学習フェーズそのものの効率化を追求した点が特徴です。
深い層が機能していることの検証
通常の深いTransformerでは、深層の表現が前層と似通ってしまう「表現の過平滑化」という問題が知られています。深層が実質的に機能しなくなるこの問題は、モデルの表現力を制限する要因のひとつです。
HRMの各層を分析した結果、深い層でも前の層から大きな変化が生じており、過平滑化が起きていないことが確認されました。
ロジットレンズ(各層がその時点で何を予測しているかを取り出す分析手法)による調査でも、HRMは浅い層で予測が収束する通常のTransformerとは異なり、深い層まで予測を洗練し続けていました。階層的な再帰構造が、深い層の有効活用を可能にしているという解釈が成り立つでしょう。
まとめと今後の課題
HRM-Textは、アーキテクチャと学習戦略の両面から事前学習の効率化に取り組んだ研究です。1Bパラメータ・約1,500ドルの学習で2〜7Bクラスと同等の性能に達したと論文は報告しており、これが成り立つならLLM研究の参入障壁を下げる可能性があります。
一方で、現在の学習データは指示応答ペアに限定されており、多様な知識をどこまでカバーできるかは今後の検討課題です。より大きなパラメータ規模でのスケーリング特性についても、さらなる検証が求められます。
コードはGitHubで公開されており、研究者が独自に実験を再現・拡張できる状態になっています。
論文情報: "HRM-Text: Efficient Pretraining Beyond Scaling"(Guan Wang et al., 2026) arXiv:2605.20613, CC BY 4.0
本記事の図(図1〜図3)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


