 AI-Papers
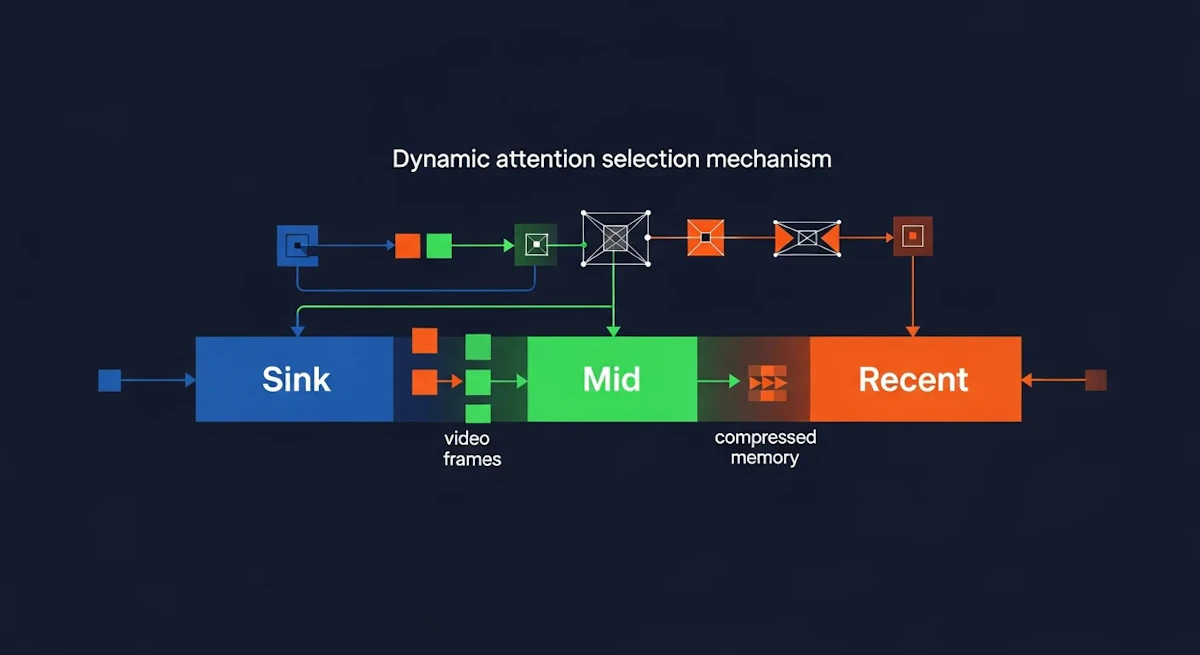
- 自己回帰型動画拡散モデルのKVキャッシュ爆発問題をSink/Mid/Recentの3段階戦略で解決し、メモリを4GB以下に抑制
- 5秒クリップの学習データから120秒(2分)の動画を単一H200 GPU上で生成する24倍の時間外挿に成功
- VBench Dynamic Degree 56.25を達成し、コードをGitHub(ShandaAI/PackForcing)で公開済み
研究の背景
近年、自己回帰型動画拡散モデルは短編動画の生成品質を大きく向上させてきました。しかし、こうしたモデルを長時間の動画生成に応用しようとすると、2つの深刻な問題が浮上します。
1つ目はKVキャッシュの爆発的増大です。自己回帰モデルは過去の全フレーム情報をKey-Value(KV)キャッシュとして保持しながら次のフレームを生成する仕組みとなっています。動画が長くなるほどキャッシュ量は線形に増加し、2分間の動画では138GBものメモリが必要となる計算です。
2つ目は時間的矛盾(temporal inconsistency)の問題です。長時間の生成では初期フレームと後期フレームの意味的な整合性が失われやすく、シーンの突然の変化やオブジェクトの消失といった不自然な動画が生じてしまいます。
従来の手法ではキャッシュの単純な切り捨てや圧縮が試みられてきたものの、情報の損失が大きく、長編動画の品質を保つのは容易ではありませんでした。PackForcingはこの2つの課題を、学習段階に短編動画クリップのみを使用する形で乗り越えているフレームワークです。
PackForcingの提案手法
PackForcingの核心は、KVキャッシュを3つの役割別領域に分割する「Sink/Mid/Recent」戦略です。各領域が異なる時間スケールの情報を担うことで、メモリ効率と映像品質を両立しています。3つの領域はそれぞれ次の役割を持ちます。
- Sink(シンクトークン): 動画の先頭8フレーム分を完全解像度で保持する
- Mid(ミッドトークン): 動画の大半の履歴情報を圧縮して格納する
- Recent(リーセントトークン): 直近のフレームを完全解像度で保持する
Sinkは全トークン予算の2%未満という小さな容量ながら、シーン全体のレイアウトや意味的な基準を動画全体を通じて提供します。生成が2分間続いても、Sinkトークンは動画の意味的な基準点として一貫して機能します。
Midの圧縮は、HR(高解像度)ブランチとLR(低解像度)ブランチの2経路から施され、トークン数ベースで約32倍の削減を実現しました。なお、空間・時間・チャンネル次元を合わせた体積ベースの圧縮率は最大128倍に達します。「32倍」はトークン数の削減量、「128倍」は全次元を合わせた体積削減量を指しており、それぞれ異なる指標です。
Recentは局所的な動きの滑らかさや時間的一貫性を確保する領域です。Recentトークンは次のブロック生成時にMidトークンへ圧縮・移行する設計となっており、情報が段階的に保存されていく仕組みになっています。
動的top-k選択と位置エンコーディング
Midトークンは圧縮されているとはいえ、動画が長くなるにつれてその量も増大します。PackForcingはこの問題を「動的top-k文脈選択」で対処します。現在生成しているフレームとの親和性スコア(内積)を計算し、最も関連性の高いNmid個のブロックだけをキャッシュに保持する仕組みです。
計算コストを抑えるため、クエリのサブサンプリング(比率γで均一サンプリング)、アテンションヘッドの50%のみ使用するHalf-Head評価、ブロックの最初のステップのみスコア計算し以降はキャッシュするStep-wise Cachingという3つの最適化が組み合わされています。これらの工夫により、オーバーヘッドは全体の1%未満に抑えられました。
もう一つの工夫が連続時間RoPE調整です。圧縮によって中間ブロックが省略されると、残ったトークン間の位置インデックスに不連続なずれが生じます。PackForcingはRotary Position Embedding(RoPE、回転位置エンコーディング)の乗法的性質を活用して時間軸方向のシフトを補正し、位置の連続性を全体FLOPs(浮動小数点演算量)の0.1%未満のコストで回復させています。
実験結果と性能比較
PackForcingは832×480ピクセル・16FPS・H200単一GPU上で2分間(120秒)の動画生成を実現しました。KVキャッシュは4GB以下に収まり、比較対象の手法が同条件で138GBを必要とするのと対照的です。
VBenchベンチマークでの主な結果は次のとおりです。
指標 | PackForcing | 比較手法 |
|---|---|---|
時間的一貫性スコア | 26.07 | - |
Dynamic Degree | 56.25 | CausVid比 +7.82 |
CLIP安定性(60秒生成) | -1.14 | Self-Forcing: -6.77 |
Subject Consistency | 90.49 | LongLive: 92.00 |
KVキャッシュ容量 | 4GB以下 | 138GB |
Dynamic Degreeは動的な動きの豊かさを示す指標で、先行手法CausVidと比較して+7.82向上しています。CLIP安定性は時間的一貫性の別の指標で、60秒生成での低下が-1.14に留まり、Self-Forcingの-6.77と比べて大幅に安定した品質を保てているといえます。
ただし、被写体の一貫性を示すSubject Consistencyでは、比較手法LongLiveにわずかに劣後します。著者らは固定圧縮率(最大128倍)がシーンの複雑度に適応しない点も課題として認識しており、今後の改善余地が残っています。
まとめと今後の展望
PackForcingは、短編クリップ(5秒)という限られた学習データから24倍長い動画を生成できる実用的なフレームワークです。Sink/Mid/Recentの3段階分割、動的top-k選択、RoPE調整という3つの設計が組み合わさり、メモリ効率と映像品質の両立を可能にしています。
コードはGitHub(ShandaAI/PackForcing)で公開されており、再現性も高く、長編動画生成の研究・開発基盤として活用できます。自己回帰型拡散モデルにおける長文脈推論の汎用的な解法として、拡散モデルの基礎から理解を深めたい方にも参考になる研究です。


