 AI-Papers
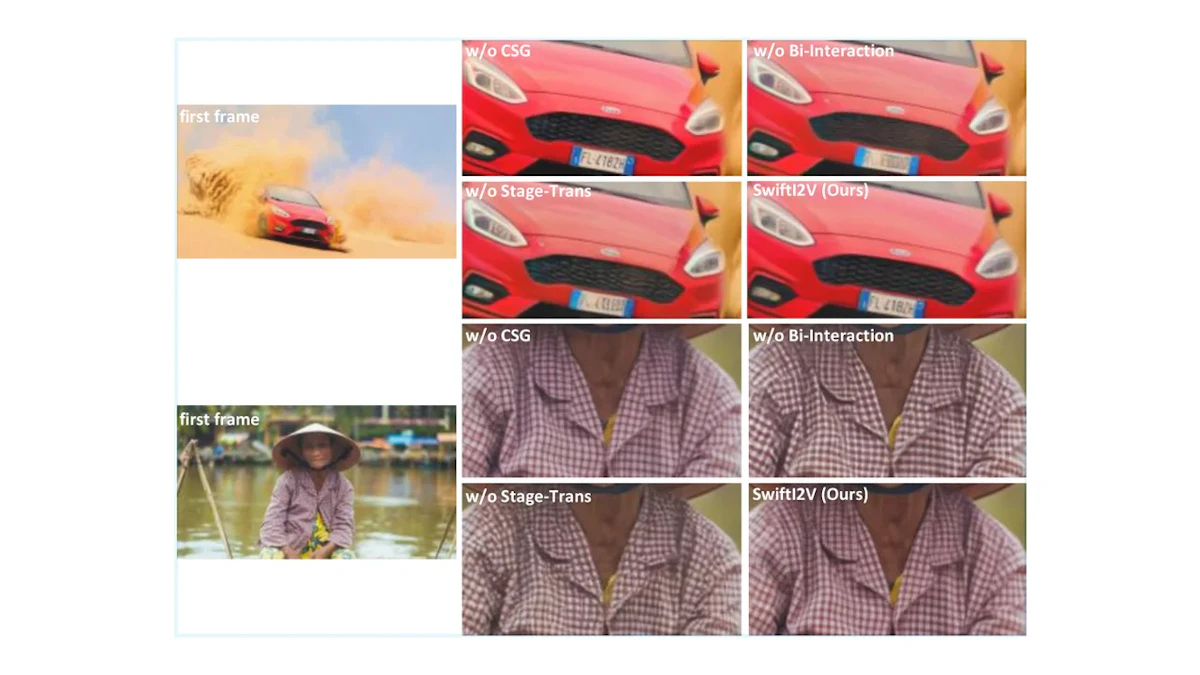
- 2K解像度のI2V生成でVBench-I2Vスコア6.4244を記録し、CineScaleやLTX-2を上回りながら総GPU処理時間を202倍削減
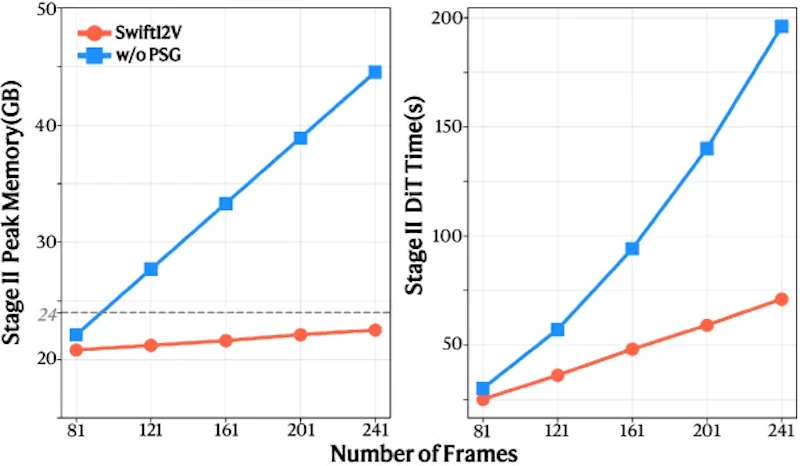
- CSG(セグメント単位条件付き生成)がトークン予算を固定上限で管理し、RTX 4090(24GB)で241フレームの2K動画もピークメモリ24GB以内に収める
- 双方向コンテキスト相互作用でセグメント間の誤差蓄積を防ぎ、エンドツーエンドモデルと同等の時間的一貫性と入力忠実度を両立
高解像度動画生成の課題
拡散モデルを用いたImage-to-Video(I2V)生成は急速に進歩していますが、2K(2560×1408)などの超高解像度では依然として大きな制約があります。Diffusion Transformer(DiT、拡散変換器)は解像度の2乗に比例してトークン数が増えるため、メモリと計算コストが急膨張します。
既存の対処策として、低解像度で動画を生成してから後処理で超解像化するアプローチがあります。しかしこの方法では入力画像の細部を十分に再現できず、細かいテクスチャや構造が失われがちです。
SwiftI2Vはこの2つの課題、すなわち「計算コストの爆増」と「超解像化時の忠実度低下」を同時に解決するフレームワークとして提案されました。
SwiftI2Vの2段階構成
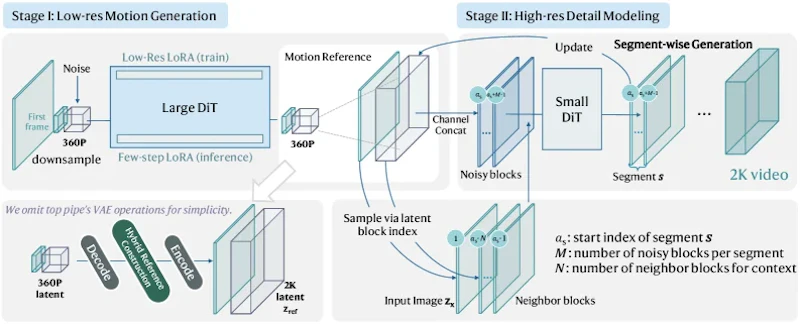
SwiftI2Vは役割を分担した2段階フレームワークを採用しています。Stage Iでは入力画像を360P(640×352)にダウンサンプリングし、Wan2.1-I2V-480PとLoRA(低ランク適応)を組み合わせた大型DiTで低解像度の「動きリファレンス」を4ステップで生成します。動画全体の動きの骨格をここで定義します。
Stage IIでは、Stage Iの出力を2KにアップスケールしたものとVAE(変分オートエンコーダ)潜在空間上の入力高解像度画像をチャネル方向で連結します。入力画像の第1フレームをそのまま置換する「ハイブリッド参照」を構築することで、小型のDiTが動きの再モデリングではなく高解像度テクスチャの忠実な合成に専念できる設計です。
CSGとは?セグメント単位生成の仕組み
Stage IIの中核技術がConditional Segment-wise Generation(CSG、セグメント単位条件付き生成)です。動画全体を一度にDiTへ入力すれば解像度に比例してトークン数が爆増しますが、CSGでは動画を時間方向にM個のフレームからなる非重複セグメントに分割します。
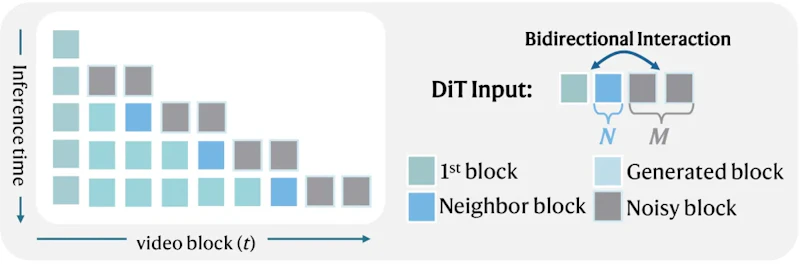
各ステップでは「アンカーブロック(第1フレーム)+ 直前N個のセグメントブロック + 現在のセグメント」だけをAttention計算の対象とするため、トークン予算が固定上限に制御されます。デフォルト設定(M=3、N=1)では21フレームの動画を7セグメントに分割し、各セグメントで4ステップのノイズ除去を実行します。
もう1つの柱が双方向コンテキスト相互作用です。従来の自己回帰型アプローチでは過去のセグメントは固定された参照としてのみ機能しますが、SwiftI2Vではアンカーブロック・近傍ブロック・現セグメントの3者が双方向に情報を交換します。更新は現セグメントのみに適用され、過去のブロックは不変に保たれます。これにより誤差の蓄積を大幅に抑え、セグメントをまたいだ映像の一貫性が維持されます。
実験結果とスケーラビリティ
VBench-I2Vベンチマークの2K解像度評価では、SwiftI2Vが既存手法を上回る総合スコアを記録しました。スコアと生成にかかる条件は次のとおりです。
手法 | VBench-I2V総合スコア | 生成にかかる条件 |
|---|---|---|
SwiftI2V | 6.4244 | H800 1枚で111秒 / RTX 4090(24GB)で約380秒 |
DiffVSR | 6.4228 | - |
CineScale | 6.3638 | H800 4枚で5600秒 |
LTX-2 | 6.3579 | - |
CineScaleと比較すると、GPU処理時間は202倍削減されています。品質を落とさずにコンシューマー向けGPU 1枚で回せる点が、この手法の実用上の利点です。
スケーラビリティの観点では、CSGによってピークGPUメモリは241フレーム時点でも24GB以下に維持され、処理時間はフレーム数にほぼ線形で増加します。CSGを取り除くとメモリと処理時間が急増し、コンシューマーGPUでの運用が不可能になることがアブレーション研究で確認されました。同じ動画生成領域ではストリーミング動画生成の改善を目指すStream-R1のような研究もありますが、SwiftI2Vはオフライン高解像度生成の効率化に特化したアプローチです。
アブレーション研究の知見
双方向コンテキスト相互作用を削除すると、VBench-I2V総スコアは6.392に低下します。因果マスクのみのアプローチでは後方セグメントへの誤差蓄積が明確に確認されており、双方向設計の有効性が裏付けられました。
また「Stage転移訓練」(セグメント境界の滑らかさを学習するための専用訓練)を省略すると、Stage Iで生じたアーティファクトが後段まで持続することも示されています。
VAEの再構成精度についても分析されており、高解像度になるほどLPIPS(知覚的類似度指標)が悪化する傾向が確認されました。これはVAEが学習時の解像度範囲外での汎化に限界があることを示すもので、今後の改善課題として明示されています。
まとめと今後の展望
SwiftI2Vは2段階フレームワークとCSGを組み合わせることで、2K I2V生成における品質と効率のトレードオフを大きく改善しました。エンドツーエンドモデルと同等以上のVBench-I2Vスコアを維持しながら、24GBのコンシューマーGPUでの実用的な運用を実現した点に研究上の意義があります。
課題としては、VAEの解像度汎化限界や、セグメント分割に起因するフレーム境界付近のわずかな不連続性が残ります。NeurIPS 2026に投稿済みのこの研究が公開されれば、オープンソースの高解像度動画生成ツールとしての普及も見込まれます。
論文情報: "SwiftI2V: Efficient High-Resolution Image-to-Video Generation via Conditional Segment-wise Generation"(YaoYang Liu et al., 2026) arXiv:2605.06356, CC BY 4.0
本記事の図(図2、図3、図7)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


