 AI-Papers
- Test-Time Scaling戦略の設計をLLMエージェントが自動化し、AIME・HMMTなど数学推論ベンチマークで手動設計を上回る精度とコストのトレードオフを実現
- オフラインリプレイ環境と1次元のベータパラメータ化で探索を効率化し、全探索コストはわずか$39.9・160分に抑制
- 発見された戦略はAIME25・HMMT25など未見のベンチマークや、Qwen3の0.6Bから8Bまで異なるモデルスケールへも汎化
研究の背景
大規模言語モデル(LLM)の性能を引き出す手段として、近年「Test-Time Scaling(TTS)」が研究者の間で注目を集めています。TTSとは、モデルの再訓練を行わず、推論時により多くの計算を割り当てることで精度を高めるアプローチです。
具体的には、モデルが複数の推論の「枝」を並行して展開し、途中で有望な枝を選別しながら最終的な答えを導きます。この枝を「いつ増やすか」「いつ打ち切るか」「いつ答えを確定するか」を決める役割を担うのがTTSコントローラです。
ところがコントローラの設計は研究者が手作業で行うのが一般的でした。問題の種類やモデルの規模が変わるたびに試行錯誤が必要なうえ、人間の直感では見落とされる最適解が存在する可能性も否定できません。GoogleのチームはこうしたTTS設計の手間を自動化するフレームワーク「AutoTTS」を提案しました。
幅と深さの制御空間
AutoTTSは、あらゆるTTS戦略を「幅」と「深さ」の2軸で統一的に記述できるという洞察から出発します。幅とは並行して探索するチェーン(推論の枝)の本数、深さは各チェーンをどこまで掘り下げるかを表します。
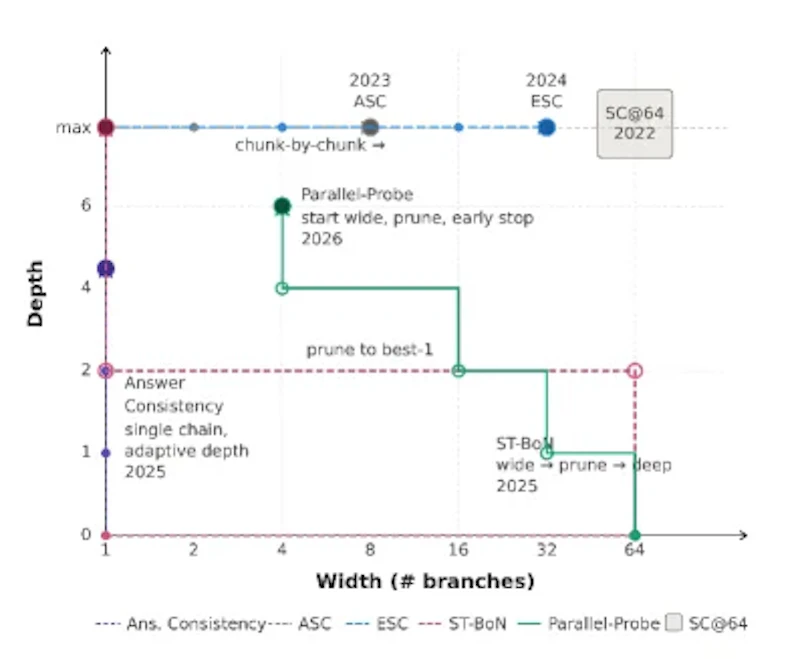
たとえばSelf-Consistency(SC@64)は64本の枝を最初から最後まで走らせる単純な手法ですが、途中の状況に応じた調整がないため計算コストが高くなりがちです。AutoTTSはこの制御空間全体を探索し、精度とコストを最大限に両立する軌跡を自動で見つけます。
AutoTTSの仕組み
AutoTTSはTTS戦略の発見を「コントローラ合成問題」として定式化しました。コントローラは各ステップで分岐(BRANCH)・継続(CONTINUE)・プローブ(PROBE)・枝刈り(PRUNE)・停止(STOP)のいずれかのアクションを選びます。状態として「現在の問題、アクティブな枝の集合、各枝の深さ、これまでに得られたフィードバック」を保持します。
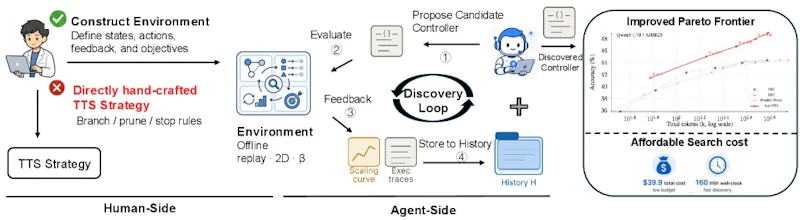
探索の核となるのがオフラインリプレイ環境です。まず問題ごとに128本の推論軌跡を事前に収集し、500トークン間隔でプローブ信号(途中の自信度など)を記録します。コントローラを評価する際はこの事前収集データを参照するだけなので、追加のLLM呼び出しが不要となり評価コストをほぼゼロに抑えられます。
探索エージェント(explorer LLM)は5ラウンドにわたって反復改善を行います。各ラウンドでは、これまでの精度・トークン使用量・実行トレースの履歴を踏まえて新しいコントローラのコードを提案し、評価結果を受けて次の提案を洗練させます。
ベータパラメータ化で探索圧縮
コントローラ内部には分岐のしきい値や枝刈りの基準など多数のハイパーパラメータが存在し、これらを同時に最適化しようとすると探索空間が急速に広がります。AutoTTSはこれを解決するため「ベータパラメータ化」を導入しました。1つのβ値がすべての内部しきい値に単調に対応するよう設計することで、高次元の探索問題を1次元の探索問題に圧縮します。β値が大きいほど多くのトークンを使う(広く・深く探索する)という直感的な対応関係が保たれます。
実験結果と汎化性
実験ではQwen3の0.6B・1.7B・4B・8Bモデルを対象に評価を実施しました。コントローラの探索はAIME24(数学オリンピック予選問題)で行い、発見された戦略をAIME25とHMMT25(ハーバード・MIT数学トーナメント)という未見のベンチマークでテストしました。
発見された戦略は、SC@64やASC・ESC・Parallel-Probeといった手動設計のベースラインに対して精度とコストのパレートフロンティアを改善しました。同じコストでより高い精度を達成するか、同じ精度をより低いコストで実現できることが示されています。さらにAIME24で発見した戦略がAIME25・HMMT25でも有効であり、モデルスケールを変えた場合にも汎化することを確認しました。
AlphaEvolveのようにAIがアルゴリズムを自律的に探索・改善するアプローチが広がるなか、AutoTTSはその推論戦略最適化版として位置づけられます。探索全体にかかったコストはわずか$39.9・160分であり、実験室規模での再現が現実的な範囲に収まっています。
まとめと今後の展望
AutoTTSは、研究者が手動でTTS戦略を設計するという従来の作業をLLMエージェントに委ねる新しい方向性を示しました。オフラインリプレイ環境とベータパラメータ化の組み合わせで探索コストを大幅に削減しつつ、手動設計を上回る戦略を自動で発見できる点が実用上の強みです。
現時点では数学推論ベンチマークでの検証が中心ですが、コーディングや科学的推論など他の領域への適用可能性も高いと見られます。探索コストが約$40という水準は、大規模な計算資源を持たない研究チームや開発者にも再現・応用しやすく、TTS戦略の設計をより広いコミュニティに開く研究として意義があります。コードはGitHubで公開予定とされています。
論文情報: "LLMs Improving LLMs: Agentic Discovery for Test-Time Scaling"(Tong Zheng et al., 2026) arXiv:2605.08083
本記事の図(図1〜図2)は解説のため上記論文より引用しています。


