 AI-Papers
- DDPMはガウスノイズを段階的に付加する「順拡散」と、逆向きにノイズを除去する「逆拡散」の2プロセスで学習・生成を行います。
- DDIMとLatent Diffusion Modelにより推論の高速化と高解像度化が実現し、Stable Diffusionとして広く普及しました。
- Flow MatchingとDiTアーキテクチャが次世代の標準となり、Stable Diffusion 3・FLUX・Soraなど最先端モデルを支えています。
拡散モデルとは何か
拡散モデル(Diffusion Model)とは、データに段階的にノイズを加えて壊し、その過程を逆向きに学習することで新しいデータを生成する機械学習モデルです。2020年にHoらが発表した「DDPM(Denoising Diffusion Probabilistic Models: ノイズ除去拡散確率モデル)」が火付け役となり、画像・音声・動画生成の分野で急速に普及しました。
直感的なイメージとしては、「コップの水に一滴のインクを垂らすと、分子が拡散して均一に広がっていく」物理現象が参考になります。この現象から着想を得て、画像をランダムなノイズへ変換するプロセスを数式でモデル化し、それを「逆再生する方法」をニューラルネットワークに学習させるのが拡散モデルの核心です。
GAN・VAEと何が違うのか
拡散モデルを理解するうえで、先行する生成モデルとの比較は役立ちます。GAN(Generative Adversarial Network: 敵対的生成ネットワーク)は高品質な画像を生成できますが、学習が不安定で「モード崩壊」と呼ばれる特定のパターンしか生成できなくなる問題がありました。VAE(Variational Autoencoder: 変分オートエンコーダ)は学習が安定している一方で、生成画像がぼやけやすいという弱点があります。
モデル | 生成品質 | 学習安定性 | 多様性 | 主な弱点 |
|---|---|---|---|---|
GAN | 高い | 不安定 | 低い | モード崩壊 |
VAE | 中程度 | 安定 | 高い | ぼやけた出力 |
拡散モデル | 非常に高い | 安定 | 非常に高い | 生成速度が遅い |
DDPMの2つのプロセス
順拡散プロセス
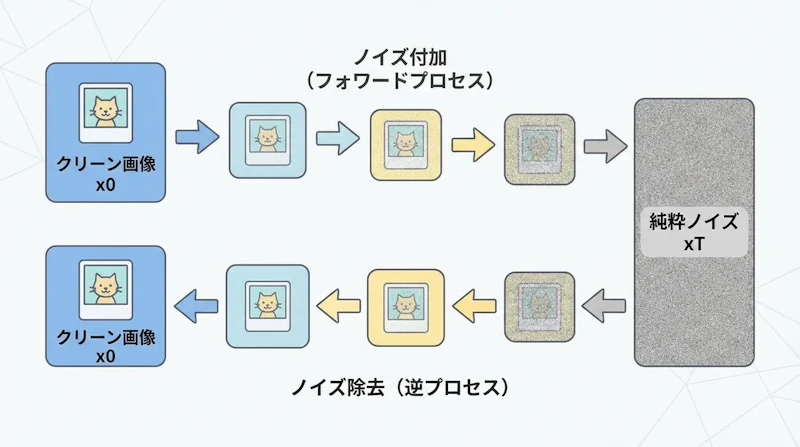
DDPMの学習は「順拡散プロセス(Forward Process)」から始まります。学習データの画像(x₀)に少量のガウスノイズを繰り返し加えていき、T ステップ後に純粋なノイズ(xT)になるまで段階的に壊します。各ステップで追加するノイズの量は「ノイズスケジュール」と呼ばれるパラメータで制御され、最終的に画像はランダムノイズと区別がつかなくなります。
この過程は「マルコフ連鎖」として定式化されており、時刻 t の状態は直前の t-1 の状態のみに依存します。重要なのは、順拡散プロセスにはニューラルネットワークの学習が必要ないという点です。数式で決まった確率的プロセスとして定義されており、T ステップ後の状態は常にガウス分布に収束します。
逆拡散プロセス
モデルの「学習」が行われるのが「逆拡散プロセス(Reverse Process)」です。U-Net をベースにしたニューラルネットワークが、ノイズの多い画像 x_t から「少しだけノイズが少ない」状態 x_{t-1} を予測することを学習します。具体的には、各タイムステップ t で加えられたノイズ ε そのものを予測するよう訓練されます。
推論時は純粋なガウスノイズ(xT)から出発し、学習した逆拡散ステップを T 回繰り返すことで、徐々に意味のある画像を生成します。「一気に完成画像を作る」のではなく、「少しずつノイズを取り除く」反復プロセスが品質向上の鍵です。
DDIMによるサンプリング高速化
DDPMの大きな課題は生成速度でした。高品質な画像を得るには 1,000 ステップ以上の逆拡散が必要で、実用上の障壁となっていました。これを解決したのが 2020年に提案された DDIM(Denoising Diffusion Implicit Models)です。
DDPMが確率的(ランダムな要素を含む)サンプリングを行うのに対し、DDIMは決定論的なサンプリングを採用します。同じ学習済みモデルをそのまま使いつつ、サンプリングステップを 50〜100 に削減しても品質をほぼ維持できます。また、同じ初期ノイズから出発すれば常に同じ画像が得られる「再現性」も利点の一つです。
Stable Diffusionの仕組み
潜在空間での拡散
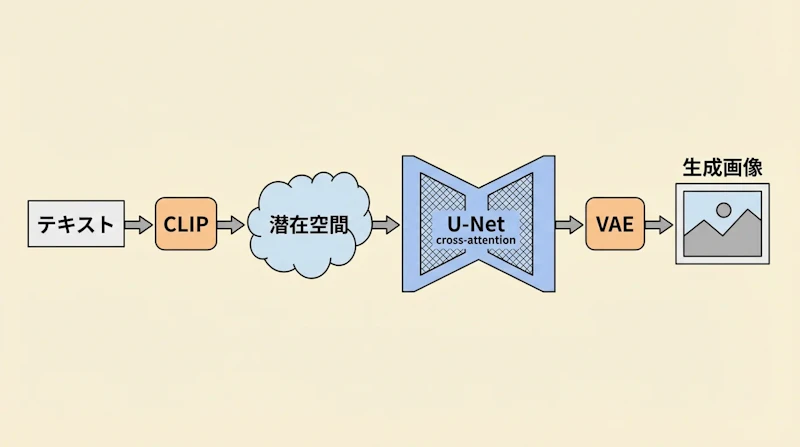
2022年に公開された Stable Diffusion は、「Latent Diffusion Model(LDM)」という手法を採用することでブレークスルーを起こしました。従来の拡散モデルは画像のピクセル空間(例:512×512 ピクセル = 786,432 次元)で拡散を行っていましたが、LDM は VAE(変分オートエンコーダ)で画像を低次元の潜在空間(64×64 程度)に圧縮してから拡散させます。
これにより計算コストが大幅に削減され、一般的な GPU で高解像度の画像生成が可能になりました。潜在空間の拡散が完了した後、VAE のデコーダが潜在表現を元の画像空間に復元します。
CLIPによるテキスト条件付け
テキストプロンプトから画像を生成するには、言語と視覚の橋渡しが必要です。Stable Diffusion では CLIP(Contrastive Language-Image Pretraining)と呼ばれるモデルがテキストを埋め込みベクトルに変換し、U-Net の「クロスアテンション(Cross-Attention)」機構を通じて各デノイジングステップに条件付けを行います。これにより「青い空に飛ぶ龍」といったテキストを視覚的な特徴として拡散過程に反映できます。
DDPM・DDIM・Flow Matchingを比較する
項目 | DDPM | DDIM | Flow Matching |
|---|---|---|---|
サンプリングステップ | 1,000+ | 50〜100 | 10〜50 |
サンプリング方式 | 確率的 | 決定論的 | 決定論的ODE |
学習目標 | ノイズ予測 | ノイズ予測 | 速度場(ベロシティ)予測 |
軌跡の形状 | 曲がりくねる | 曲がりくねる | 直線的 |
代表モデル | DALL-E 2 | Stable Diffusion 1/2 | SD3, FLUX, Sora |
Flow Matchingへの進化
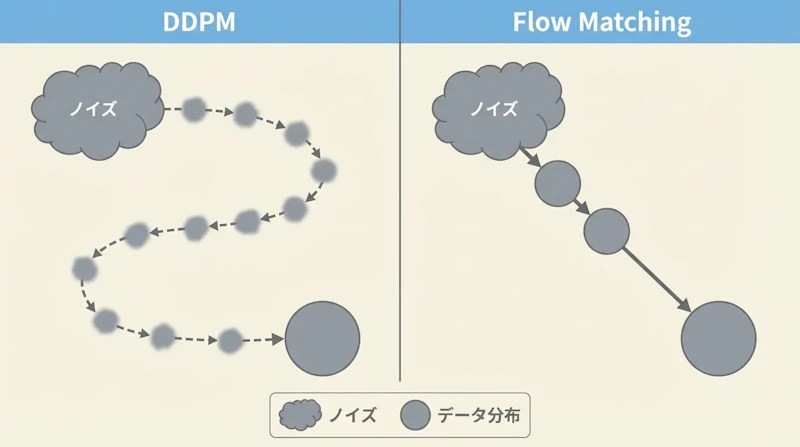
Flow Matching は 2022〜2023年にかけて注目を集めた新しいパラダイムです。拡散モデルが「ノイズを段階的に除去する確率的プロセス」で学習するのに対し、Flow Matching は「ノイズ分布からデータ分布へ向かう速度場(Velocity Field)」を直接学習します。
イメージとしては、DDPMが「でこぼこした山道を何百歩も歩いてゴールに到着する」のに対し、Flow Matching は「直線のルートを少ないステップで進む」ようなものです。軌跡が直線的になるため、より少ないステップで高品質なサンプルが生成でき、学習も安定します。
学習目標もシンプルになります。DDPMがノイズ ε を予測するのに対し、Flow Matching はデータ点とノイズの間の速度ベクトルを予測します。損失関数は単純な平均二乗誤差(MSE)で、理論的な保証もより明快です。Stable Diffusion 3(SD3)・FLUX.1・OpenAI の Soraは Flow Matching をベースとしており、現在の最先端モデルの標準技術となっています。
DiTアーキテクチャとSoraへの展開
U-Net をニューラルネットワークのバックボーンとして使うのが長年の主流でしたが、2022年に「DiT(Diffusion Transformer)」が登場し、アーキテクチャの刷新が始まりました。DiT は U-Net を Transformer に置き換えたモデルです。Transformer はAttention機構を核とした高いスケーラビリティを持ち、パラメータ数を増やすほど性能が向上する「スケーリング則」が明確に機能することが確認されています。
DiT と Flow Matching の組み合わせは現代の画像・動画生成モデルの定番となっており、Stability AI の Stable Diffusion 3、Black Forest Labs の FLUX.1 がその代表例です。OpenAI が 2024年に発表した動画生成モデル「Sora」も DiT を採用しており、動画のフレームをパッチ単位で処理する「Spacetime Patch」という手法で長尺・高品質動画の生成を実現しています。
活用領域とこれから
拡散モデルの応用範囲は画像生成にとどまりません。現在活発に研究・実用化が進んでいる領域は以下のとおりです。
- 動画生成: Sora、Wan2.1、CogVideoX など時間軸を含む拡散
- 音声・音楽生成: AudioLDM、MusicLDM によるオーディオ合成
- 3D・分子設計: 新素材・創薬分野での分子構造生成
- 画像編集: インペインティング(部分補完)・アウトペインティング(外挿)
- 医療画像: MRI 超解像、合成データによるデータ拡張
2026年現在、Flow Matching と DiT を組み合わせたアーキテクチャが次世代の標準として確立しつつあります。一方、Consistency Model(一貫性モデル)など「さらに少ないステップで高品質生成を目指す」研究も進んでおり、リアルタイム生成の実現が現実味を帯びています。拡散モデルの基礎にある「壊してから学ぶ」という発想は、画像以外の領域にも広がり続けており、この技術の仕組みを理解することは生成AIの現在地と未来を読み解くうえで欠かせない知識となっています。


