 AI-Papers
- ロールアウト信頼性(Inter-Reliability)と空間・時間的複雑度(Intra-Perplexity)を単一の報酬モデルで統合制御する新しい報酬蒸留フレームワーク
- アーキテクチャ変更・推論オーバーヘッドなしで全ベンチマーク指標においてReward Forcingを上回る品質を実現
- 長時間動画(最大180秒)でも品質低下を抑制し、60秒動画で視覚品質・動的妥当性ともに人間評価60%超の勝率を記録
研究の背景
近年、動画生成モデルの高速化手法として分布マッチング蒸留(Distribution Matching Distillation、DMD)が注目を集めています。DMDは、多ステップの拡散モデルをより少ないステップで動作する学生モデルに蒸留する手法で、推論速度を大幅に短縮できます。
自己回帰型ストリーミング動画拡散モデルでは、フレームを逐次生成するロールアウト(rollout)と呼ばれる処理単位が存在します。従来のDMDはすべてのロールアウトを均等に扱い、空間的・時間的な各領域にも一律の最適化強度を適用していました。この「一律処理」が生成品質の上限を制限していると、Stream-R1の著者らは指摘しています。
実際のロールアウトには、報酬モデルのスコアが高い信頼性の高いものと低いものが混在します。UniVidXのような動画生成の多面的な品質制御が示すように、動画の空間・時間的な品質を細かく制御することは複雑な課題です。Stream-R1はこの問題に報酬モデルを軸とした新しいアプローチで挑んでいます。
DMD蒸留の2つの課題
Stream-R1が解決を目指す問題は、2つの「分散の軸」として整理されています。
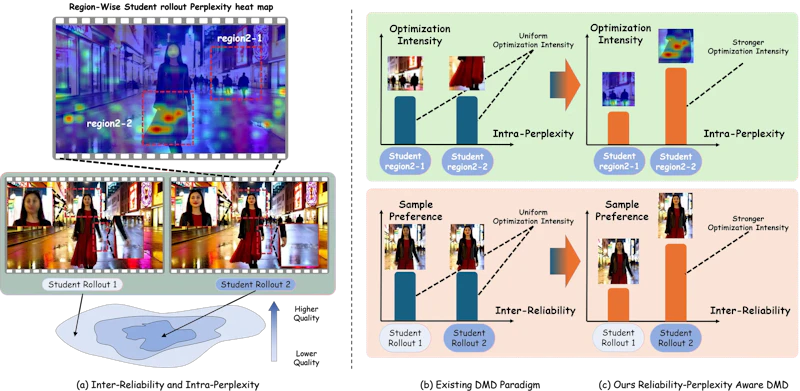
第1の軸はInter-Reliability(ロールアウト間の信頼性差異)です。あるロールアウトでは報酬モデルが高スコアを付ける一方、別のロールアウトでは低スコアになります。従来のDMDはこの差異を無視してすべてを均等に学習するため、信頼性の低い監督信号がノイズとして学習に混入してしまいます。
第2の軸はIntra-Perplexity(ロールアウト内の空間・時間的複雑度差異)です。同一ロールアウトの中でも、ブレが大きいフレームの下半分など「改善効果が期待できる領域」と、すでに高品質な領域が混在します。従来手法はこれも一律に扱うため、最適化リソースが効率的に配分されません。
Stream-R1の提案手法
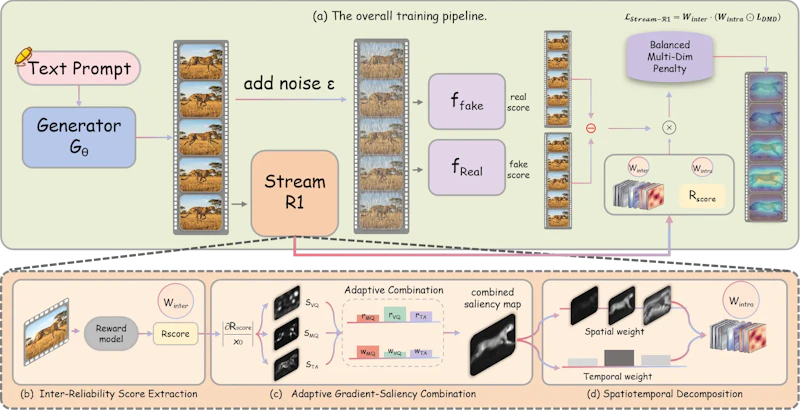
Stream-R1は、2つの課題を単一の報酬モデルで統合的に対処します。損失関数は2段階の重み付けで変更されています。
まず、Inter-Reliability重み(W_inter)として、報酬モデルのスコアを指数関数的に変換したスカラー値を各ロールアウトに掛け合わせます。これにより、報酬スコアが高い(信頼性の高い)ロールアウトの学習信号が相対的に強化されます。
次に、Intra-Perplexity重み(W_intra)として、同じ報酬モデルを逆伝播させて得られるピクセル単位の勾配顕著性マップを使用します。視覚品質(VQ)、動き品質(MQ)、テキスト整合性(TA)の3軸の顕著性を組み合わせて統合マップを生成し、空間方向と時間方向に分解することで各フレーム・各ピクセルの最適化強度を決定します。最終的な損失はこの2つの重みを組み合わせた形式 L = W_inter · (W_intra ⊙ L_DMD) で表されます。
実験結果
Stream-R1の性能は、短動画・長動画の両設定で評価されています。短動画(標準ベンチマーク、VBench 946プロンプト)では、総合スコア84.40を記録し、ベースラインのReward Forcingに対して全指標で優位を示しています。教師モデルであるWan2.1(スコア84.26)さえも上回る結果であり、蒸留でありながら元モデルを超える品質を達成しています。
長動画生成においても効果は明確です。60秒動画のVLM(視覚言語モデル)評価では視覚品質4.92、テキスト一致4.11を記録し、Reward Forcing(4.82、4.04)を上回りました。人間評価でも動的妥当性63.0%、視覚品質60.0%の勝率でReward Forcingに対する優位性を確認しています。
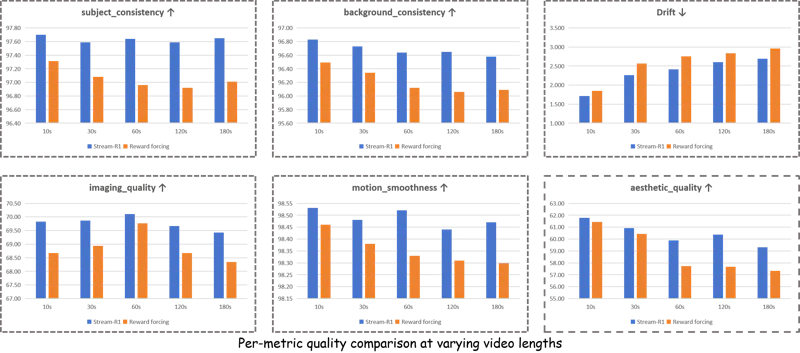
動画が長くなるほど性能差が拡大する傾向も観察されています。120秒・180秒の動画では6指標すべてでStream-R1がReward Forcingを一貫して上回り、長い自己回帰ロールアウトで蓄積される品質劣化を空間・時間的報酬誘導重み付けが効果的に抑制していることが示されています。
推論速度については教師モデルの30倍高速化を維持しており、アーキテクチャ変更や追加推論コストを伴わずにこれらの改善を実現しています。
まとめ
Stream-R1は、DMD蒸留における「ロールアウト間の信頼性差異」と「ロールアウト内の空間・時間的複雑度差異」という2つの課題を、単一の報酬モデルで統合的に対処する手法です。既存のDMDパイプラインに重み付けを追加するだけで適用できるため、実装コストも低く抑えられています。
短動画・長動画の双方で全指標の向上を示したこの研究は、ストリーミング動画生成モデルの品質向上において、蒸留段階での監督信号の質が重要な役割を果たすことを示しています。今後は異なる動画生成アーキテクチャへの適用や、報酬モデルの種類を変えた場合の汎用性検証が課題として挙げられます。
論文情報: "Stream-R1: Reliability-Perplexity Aware Reward Distillation for Streaming Video Generation"(Bin Wu et al., 2026) arXiv:2605.03849
本記事の図(図1、図2、図4)は解説のため上記論文より引用しています。


