 AI-Papers
- デュアルストリームMoEで理解・生成の能力経路を分離しながら共有コンテキストで協調学習し、3Bの活性化パラメータで7Bクラスのモデルを超える性能を実現
- モダリティ認識型位置エンコーディング「MaPE」が異種の視覚トークン間の干渉を軽減し、VBenchで統合モデル最高スコア85.11を達成
- 画像・動画の生成から編集まで6タスクを単一モデルで処理し、GEdit-Benchでも統合モデル中トップの7.30を記録
研究の背景
画像・動画を扱うAIモデルは、近年「理解」「生成」「編集」それぞれの分野で発展してきました。しかし多くの場合、これらは独立したモデルとして設計されており、複数のタスクを実際のアプリケーションで組み合わせるには、複数のモデルを並行して運用する必要がありました。
この状況を改善しようとする統合モデルの研究は増えています。ただし、そこには大きな技術的障壁があります。
理解タスクには意味論的な情報(「何が写っているか」)が重要ですが、生成タスクには画素レベルの精細なパターンが求められます。この表現要件の違いが、単一モデルで両者を高品質に扱うことを難しくしてきました。
ByteDanceの研究チームが2026年5月に発表したLanceは、「分離された能力経路」と「統一コンテキスト学習」を組み合わせて、この課題に取り組んだフレームワークです。単純にモデルを大きくするのではなく、マルチタスク協調学習の設計を工夫することで性能向上を狙っています。
デュアルストリームMoEの仕組み
Lanceの中核を担うのが、デュアルストリーム混合専門家(Dual-Stream Mixture-of-Experts, MoE)アーキテクチャです。MoEとは、入力に応じて異なる「専門家」モジュールを使い分ける設計手法を指します。全パラメータを常に使うのではなく必要な専門家だけを活性化させるため、メモリ効率が高い点も特徴です。
Lanceでは「理解専門家」と「生成専門家」の2種類の経路を設けています。テキスト生成・動画分析などの理解タスクは理解専門家が、画像・動画の生成・編集は生成専門家が主に担当します。両者が共有されたマルチモーダルコンテキスト上で動作するため、一方のタスクで得た知識が自然にもう一方へ波及する「マルチタスク相乗効果」が生まれます。
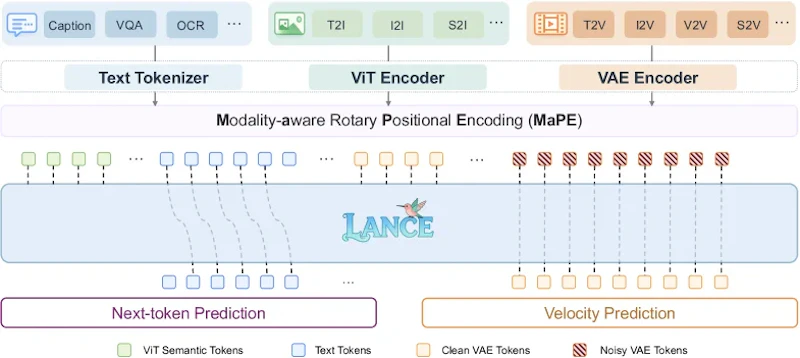
出力は2系統のヘッドで生成されます。テキスト出力は言語モデリングヘッド(LMヘッド)が自己回帰的な次トークン予測で担当し、画像・動画の視覚出力はフローヘッドが拡散ベースの速度予測(velocity prediction)で担当します。この分業により、テキストと視覚それぞれに適した生成方式を単一モデルの中で両立させています。
MaPEによる位置エンコーディングの刷新
もう一つの柱がMaPE(Modality-Aware Positional Encoding、モダリティ認識型位置エンコーディング)です。位置エンコーディングとは、モデルがシーケンス内の各トークンの位置関係を把握するための仕組みで、Transformerアーキテクチャの基本要素にあたります。
統合モデルでは、意味論的な情報を持つViTトークンと、画素の変化パターンを表すVAE潜在空間トークンが混在します。これらを区別せず同一の位置エンコーディングで処理すると、タスク間で信号の干渉が起き、性能が低下します。
MaPEはモダリティの種類に応じた位置オフセットを時間次元に付与し、視覚トークン間の機能的な境界を位置空間でも明確にします。これによりタスク間の整合性が高まり、理解と生成を同一シーケンス上で同時に扱う際の品質低下を抑えられます。
6タスクを1モデルで処理
Lanceが対応するタスクは3カテゴリ・6種類に及びます。
- 理解(X2T): 画像の内容説明(I2T)
- 理解(X2T): 動画の内容説明(V2T)
- 生成: 任意入力からの画像生成(X2I)
- 生成: テキスト・参照映像からの動画生成(X2V)
- 編集: 画像編集
- 編集: 動画編集
これら6種類を別々のモデルに分けず、1つのモデルで切り替えて扱える点がLanceの設計上の狙いです。
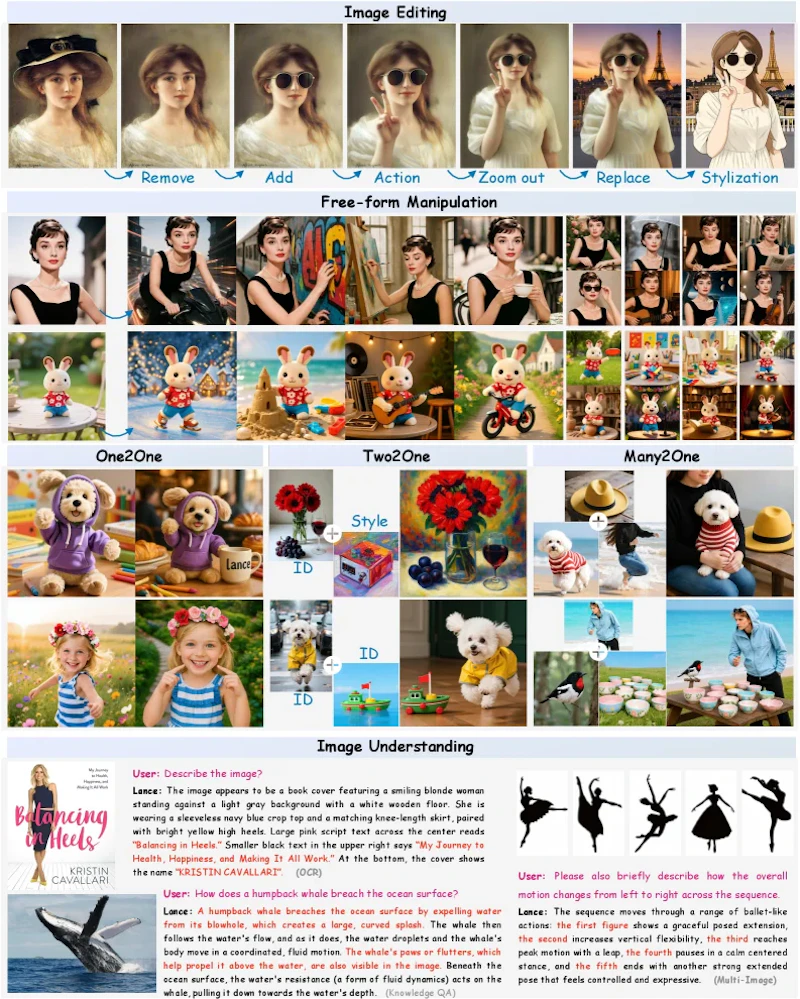
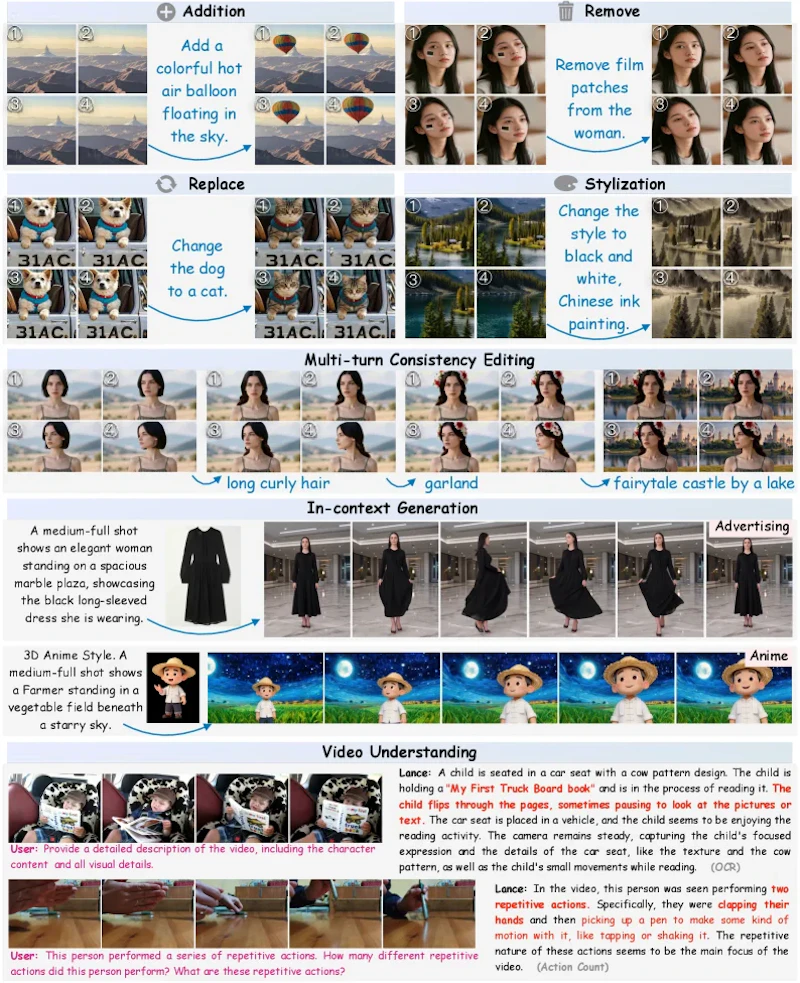
動画生成の分野では、LongLive-2.0のような特定能力に特化したモデルが速度や長時間生成を追求する研究が進んでいます。Lanceはこれとは対照的に、理解・生成・編集を統一的に扱う「ゼネラリスト」としての方向性を取り、単一のモデルで幅広いタスクに対応できる実用性を示しました。
実験結果
Lanceは活性化パラメータ3Bという比較的小さな規模でありながら、7Bクラスの統合モデルを複数のベンチマークで上回りました。画像生成品質を測るGenEvalでは、BAGEL(7B)とShow-o2(7B)をいずれも超えています。主なベンチマークの結果は次のとおりです。
ベンチマーク | Lance(活性化3B) | 比較対象 |
|---|---|---|
GenEval(画像生成品質) | 0.90 | 0.88(BAGEL 7B) |
DPG-Bench(指示と画像の整合性) | 84.67 | - |
VBench(動画生成品質) | 85.11 | 81.34(Show-o2) |
MVBench(動画・画像の理解) | 62.0 | 55.7(Show-o2) |
GEdit-Bench(編集) | 7.30 | - |
VBenchの85.11は統合モデルの中で最高スコアであり、Show-o2の81.34を大きく上回る結果です。視覚的品質の面では、20Bクラスのモデルと同等の水準に迫ると論文は報告しています。
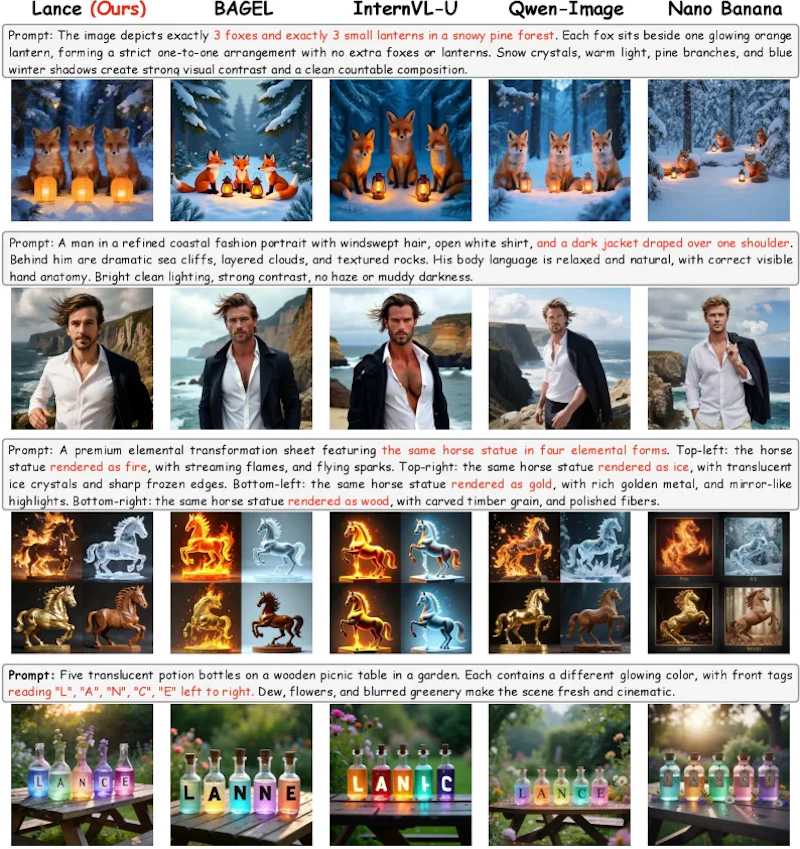
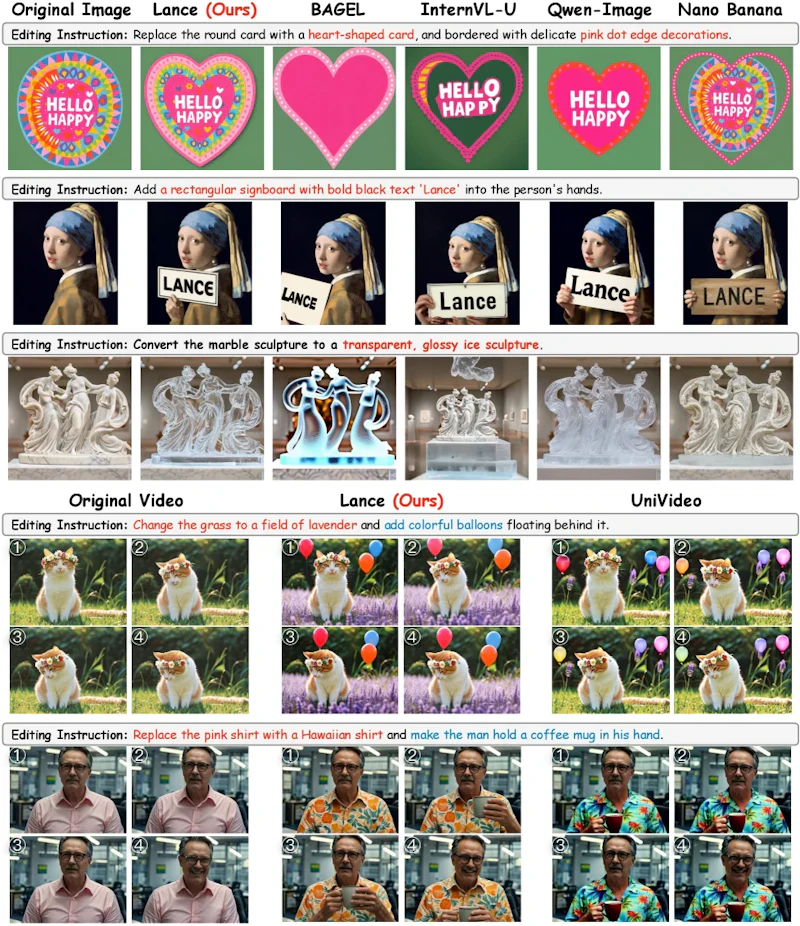
編集タスクのGEdit-Bench 7.30も統合モデル中のトップスコアで、背景変更・素材変更・対象の削除や置換のカテゴリで特に高い評価を得ました。一方で、テキスト文字の修正(text editing)は精度が課題として残っており、今後の改善点として論文でも明示されています。
スケーリングが示した相乗効果
論文では、トレーニングトークン数を0.5兆(0.5T)から1.5兆(1.5T)まで段階的に増やした際の性能変化も検証されています。DPG-BenchとVBenchはともにトークン数に応じて着実に改善し、マルチタスク協調学習による相乗効果が数値として確認されました。
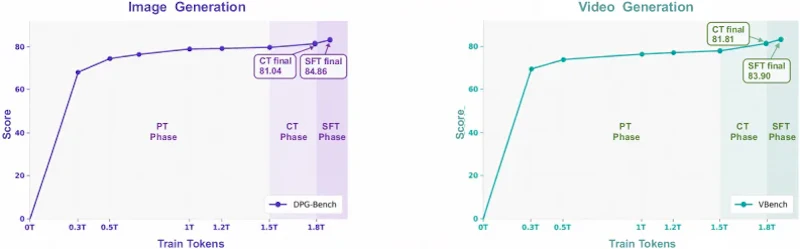
0.5Tトークンの段階では、テキスト指示の意味理解はできているものの、細部の再現に粗さが残ります。1.5Tトークンになると、複数物体の動力学的な表現や構造の忠実な再現が大幅に向上することが、定性的な比較でも確認されました。この結果は、統合学習によるタスク間の知識転移が継続的に効いていることを示唆します。
まとめ
Lanceは、デュアルストリームMoEとMaPEという2つの設計上の工夫により、理解・生成・編集という性質の異なるタスクを単一モデルで高品質に処理しました。パラメータ効率にも優れ、3Bの活性化パラメータで7Bクラスのモデルに匹敵する性能を複数ベンチマークで示しています。
コードとモデルはGitHubで公開されており、再現実験や応用研究に使いやすい状況です。テキスト文字編集の精度など残課題はあるものの、「能力経路の分離と協調」という設計思想は、今後の統合マルチモーダルモデル研究における参照点になるでしょう。
論文情報: "Lance: Unified Multimodal Modeling by Multi-Task Synergy"(Fengyi Fu et al., 2026) arXiv:2605.18678
本記事の図(図1〜図6)は解説のため上記論文より引用しています。

