 AI-Papers
- マイグレーション対応の配置制御器がGPU間の負荷不均衡を動的に解消し、最悪ケースのチャンクレイテンシを37.5%削減
- 需要変動に応じたGPUオートスケーリングでアイドル時のリソース浪費を排除し、平均GPU運用コストを37.2%削減
- Shengshu Technologyの実運用トレースとNVIDIA B300最大64基で検証済み、GitHubでコード公開
ストリーミング動画生成の特殊性
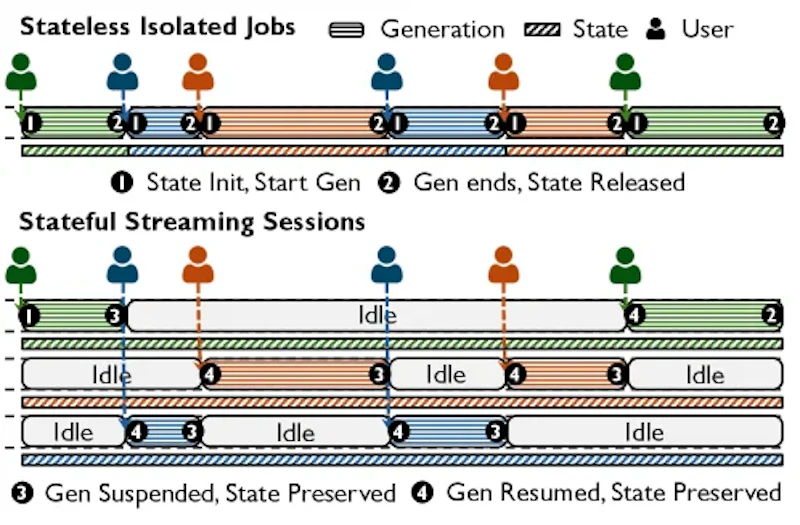
WanやSoraのような最新の動画生成モデルは、完成した動画を一気に出力するのではなく、短い断片(チャンク)を順番に生成しながらリアルタイムでユーザーに届ける「ストリーミング生成」方式を採用しています。この方式では、ユーザーがコンテンツを生成している間、GPU上にセッション状態を維持し続ける必要があります。
従来の画像生成や短いテキスト生成では、リクエストごとに一時的なGPUメモリを確保し、処理が完了したら解放するという「ステートレス」な方式が一般的でした。一方、ストリーミング動画生成はセッションが長時間にわたって存在し、生成と待機を繰り返す「ステートフル」な処理になります。この違いが、既存のサービングシステムでは対応しきれない新たな問題を引き起こします。
実運用が示す2つの課題
論文では、動画生成スタートアップであるShengshu Technologyの本番環境トレースを分析し、ストリーミング生成サービスが直面する2つの根本的な課題を明らかにしています。
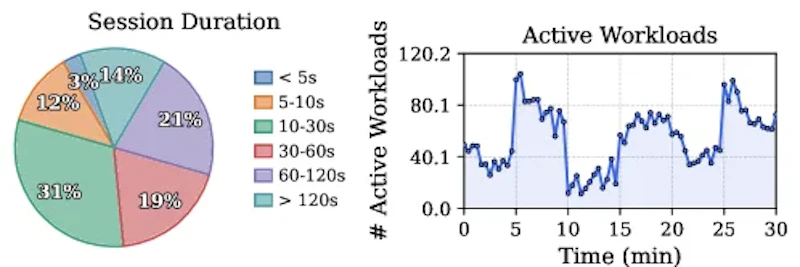
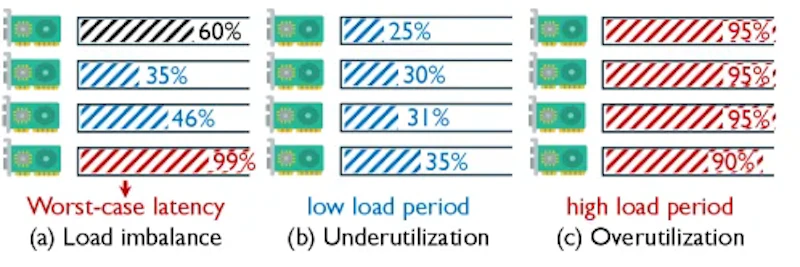
1つ目はセッション継続時間の不均一性です。ユーザーによってセッションの長さは数分から数十分まで大きく異なります。長く続くセッションが特定のGPUに偏ると、そのGPUの負荷が上がり、他のGPUがアイドル状態であっても最悪ケースのチャンクレイテンシが増大してしまいます。
2つ目は時間的な需要変動です。実際の運用では、同時に生成中のセッション数は時間帯によって数倍以上変動します。GPUを最大需要に合わせて固定確保すると閑散期にコストが無駄になり、少なく確保するとピーク時にレイテンシが悪化する。いずれの方向でも最適化できないという構造的な問題です。
TurboServeの設計
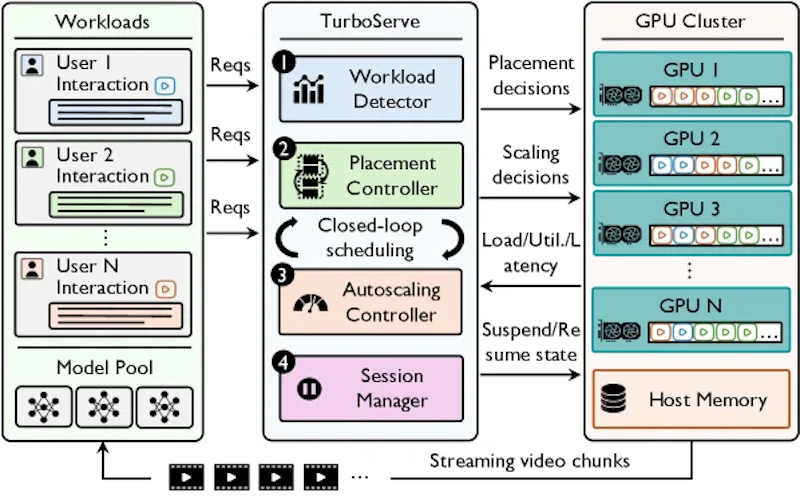
TurboServeはこれらの課題に対して、クローズドループ型スケジューラーを核とした専用サービングシステムとして設計されています。実行時の負荷・稼働率・レイテンシのフィードバックをループしながら、配置とリソース量を動的に制御します。
主要なコンポーネントの1つ目は「マイグレーション対応の配置制御器」です。GPUの負荷が偏ってきたとき、アクティブなセッションを別のGPUへ移動(マイグレーション)させて均等化します。セッションのKVキャッシュなど状態データをNCCL(GPU間高速通信ライブラリ)で転送し、生成を中断せずに引き継ぎます。移動コスト(通信時間)を考慮した「マイグレーション対応型の最小最大再バランス」アルゴリズムを採用しており、移動の効果がコストを上回る場合のみ実行します。
2つ目の柱が「負荷駆動型GPUオートスケーリング」です。需要が増えるとGPUを追加し、需要が落ち着くとセッションを残りのGPUに集約してからアイドルGPUを解放します。また、ユーザーが生成を一時停止しているアイドルセッションは、GPUメモリからホストメモリ(CPU側のRAM)にオフロードしてGPUリソースを解放します。
リアルタイムのストリーミング動画処理という観点では、LiveEditの3段階蒸留アプローチもモデル側から推論速度を改善する取り組みとして参考になります。TurboServeはモデル自体を変更せずサービング層の制御ロジックで効率化する点が対照的で、両者は補完的な関係にあります。
実験結果
評価はShengshu Technologyの本番トレースを用い、NVIDIA B300 GPUを最大64基使用したクラスターで実施されました。比較対象は既存の汎用サービングシステムです。主要な指標での改善幅は次の表のとおりです。
制約条件 | 指標 | ベースラインからの改善 |
|---|---|---|
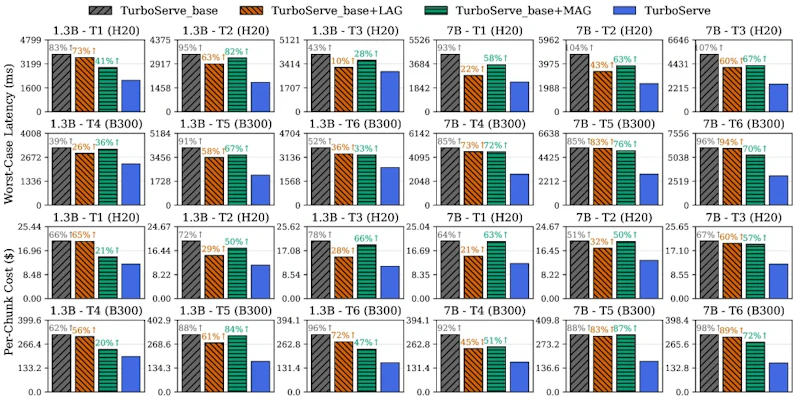
同一コスト制約 | 最悪ケースのチャンクレイテンシ | 最大37.5%削減 |
同一レイテンシ制約 | GPU稼働コスト | 平均37.2%削減 |
WanおよびSoraタイプの2種類のモデルで、複数のワークロードトレースとクラスター規模にわたって一貫した改善が確認されています。
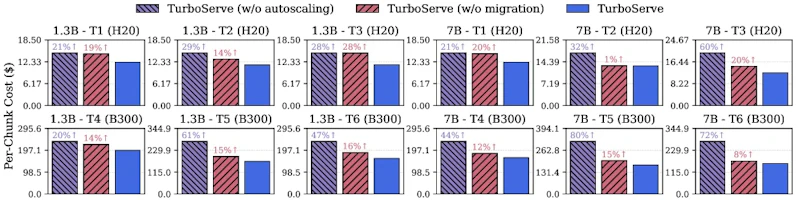
アブレーション実験では、セッション移行機能とGPUオートスケーリングの両方が成果に貢献していることが確認されました。どちらか一方を省いても改善効果は半減し、2つの機構が補完的に機能することが示されています。
まとめと今後の展望
TurboServeは、ストリーミング動画生成というサービング形態に固有の2つの課題(負荷不均衡と需要変動)に正面から取り組んだ初の専用システムです。レイテンシとコストの両面で約37%の改善を実証しました。
動画生成モデルの商用サービスを展開する事業者にとって、GPU費用はランニングコストの大半を占めます。TurboServeのアプローチはモデルの学習や構造を変えず、サービングインフラの制御ロジックで効率化する点で、既存システムへの導入障壁が低いといえます。コードはGitHubで公開されており、実際のシステムへの適用を検討しやすい状態です。
一方、セッション状態のマイグレーションには一定の通信オーバーヘッドが発生するため、モデルサイズやネットワーク帯域によっては恩恵が限定される場面もあります。また、オートスケーリングの反応速度と過剰な増減サイクルのトレードオフは、実際の運用でのチューニングが必要になるでしょう。
論文情報: "TurboServe: Serving Streaming Video Generation Efficiently and Economically"(Youhe Jiang et al., 2026) arXiv:2606.19271
本記事の図(図1、図2、図3、図5、図7、図8)は解説のため上記論文より引用しています。


