 AI-Papers
- 双方向DiTから単方向因果モデルへの3段階蒸留で推論を4ステップに圧縮し、処理時間を197msから7.89msに短縮
- フレーム間で未編集背景のトークンを再利用するAR指向マスクキャッシュにより、冗長トークンの約70%を削減
- ストリーミング動画編集専用ベンチマークで6つのベースラインを全指標で上回り、12.66 FPSのリアルタイム編集を実現
研究の背景
テキスト指示だけで動画の特定領域を編集できる技術は、ARデバイスやインタラクティブな映像制作ツールへの応用が期待されています。しかし既存の手法には大きな障壁がありました。高品質な編集を実現する拡散モデルは、全フレームを双方向に参照して処理するため、推論に数秒単位の時間がかかります。リアルタイム処理には到底届きません。
一方、ストリーミング向けに設計された過去のモデルは、過去フレームのみを参照する因果的構造(Causal Architecture)で応答時間を短く抑えますが、未編集の背景を正確に保持するのが苦手です。編集対象ではない領域がフレームをまたいで変化してしまう問題が起きます。
LiveEditは、この「品質」と「速度」の両立を目指して開発されました。ECCV 2026に採択されており、技術的な信頼性も外部評価で確認されています。
3段階蒸留パイプライン
LiveEditの中核は、高品質な双方向拡散モデル(Bidirectional DiT)の能力を、リアルタイム動作可能な単方向モデル(Causal DiT)へ段階的に移す蒸留パイプラインです。次の3つの段階に分かれています。
- 第1段階(基盤チューニング): 元動画フレームとノイズを付与した潜在表現をチャネル方向に結合し、双方向DiTをファインチューニングする
- 第2段階(教師強制): Chunk-wise Causal Attentionを導入し、第1段階の双方向モデルの出力を教師信号として学習する
- 第3段階(DMD蒸留): Distribution Matching Distillation(DMD)を適用し、推論ステップを4回まで圧縮する
各段階の役割をもう少し詳しく見ていきます。第1段階では編集の基礎能力をモデルに覚えさせます。1フレームあたりの処理時間はこの時点で約197msです。
第2段階のChunk-wise Causal Attentionは、モデルが将来のフレームを参照できないよう制限する仕組みです。単方向モデルへの移行時に生じる注意分布のずれを、この段階で矯正します。
第3段階のDMDでは、通常の拡散モデルが20〜50ステップを要するところを4ステップまで削ります。第2段階の重みから直接初期化することで学習を安定させ、処理時間は約7.89msまで短縮されます。蒸留を用いた生成・編集モデルの高速化という観点では、DanceOPD:生成・編集を1モデルに統合するオンポリシー蒸留フレームワークも関連する手法として参考になります。
AR指向マスクキャッシュ
蒸留だけでは12 FPSには届きません。そこでLiveEditがもう一つの工夫として導入したのが「AR指向マスクキャッシュ」です。動画フレームには編集対象以外の背景領域が大量に存在し、これらは前フレームとほぼ同じ内容であるため、毎フレーム同じ計算を繰り返すのは無駄が多くなります。
マスクキャッシュは、フレーム間のL2距離を計算して変化の少ない未編集領域を特定し、その領域の自己注意(Self-Attention)トークンを直前フレームから再利用します。フィードフォワードネットワーク(FFN)にはキャッシュを適用しません。時間的な冗長性が自己注意層に集中しているためです。この仕組みにより、冗長なトークン計算の約70%を削減します。
結果として1フレームあたりの処理時間は79msとなり、12.66 FPSのリアルタイム動画編集が実現します。キャッシュをFFN層に適用した場合はテキスト整合性スコアが0.236まで急落することが実験で確認されており、自己注意層のみへの適用が性能維持の鍵です。
実験結果
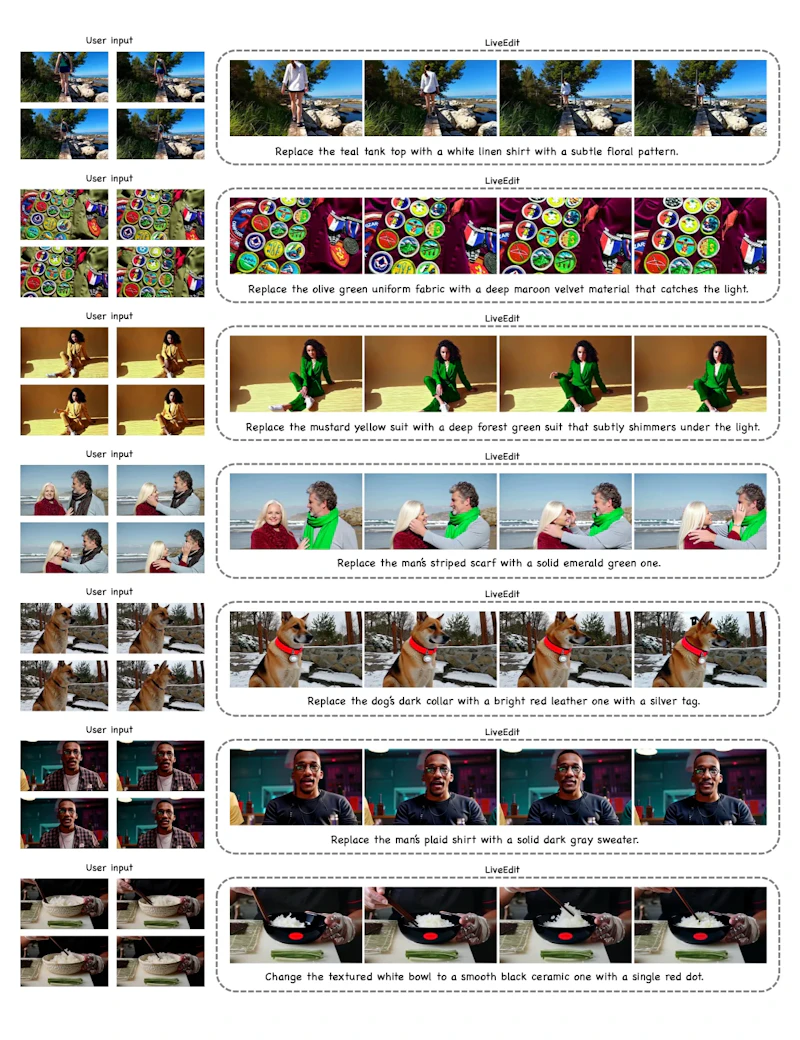
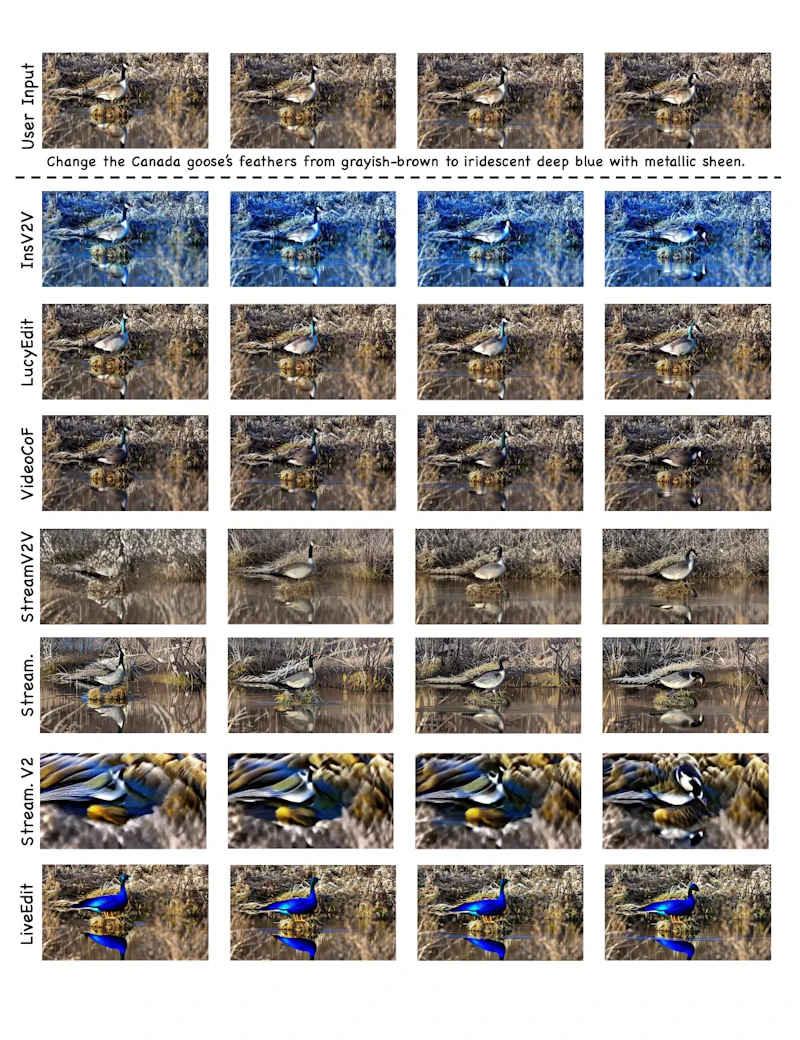
LiveEditの評価には、著者らが新たに構築したストリーミング動画編集専用のベンチマークを使用しています。120本の動画ペアで構成され、テキスト整合性・背景一貫性・動作の滑らかさなど6つの指標で計測します。比較対象にはLucyEdit、InsV2V、VideoCoFなど6つのベースラインを用意しました。
定量評価の結果は次のとおりです。
項目 | LiveEdit |
|---|---|
テキスト整合性スコア | 0.270 |
背景一貫性スコア | 0.956 |
動作の滑らかさ | 0.992 |
処理速度 | 12.66 FPS(79ms/フレーム) |
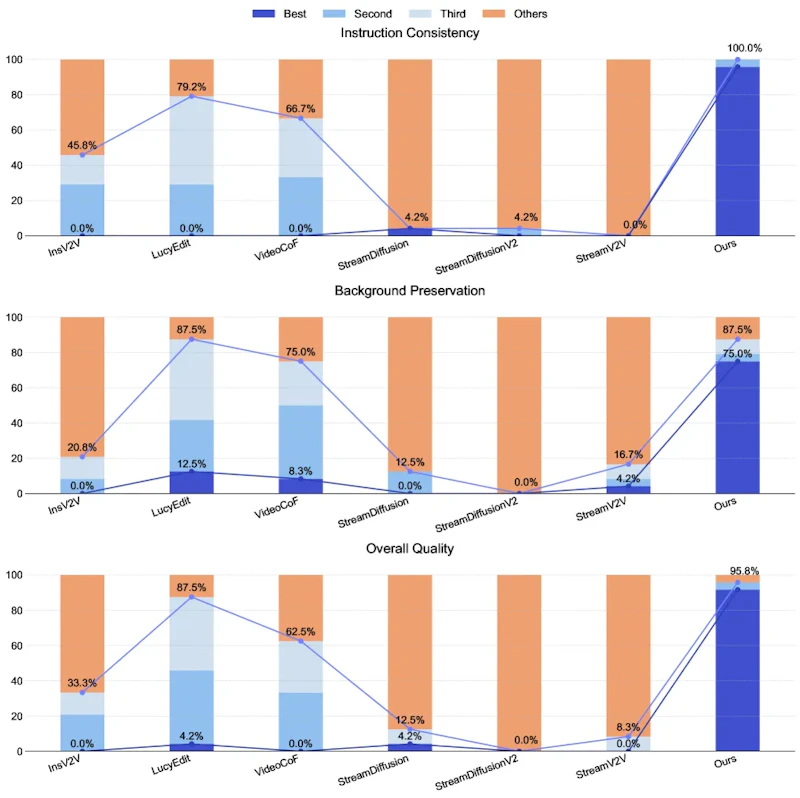
これらの値で全ベースラインを上回りました。ユーザースタディでは、背景保存の評価で参加者の75%がLiveEditを最高と評価しています。指示への忠実さと未編集領域の品質保持を同時に高いレベルで実現した点が、従来手法との大きな差です。
まとめと今後の展望
LiveEditは、拡散モデルの高い編集品質をリアルタイム処理と両立させた実用的なフレームワークです。3段階蒸留とAR指向マスクキャッシュの組み合わせという設計は理解しやすく、他のアーキテクチャへの応用も期待できます。専用ベンチマークの提案も含めて、ストリーミング動画編集という領域の研究基盤を整えた点でも意義があるでしょう。
一方で課題も残ります。マスクキャッシュはFFN層には適用できないため、さらなる高速化には別の手立てが要ります。高解像度や複雑な編集シナリオでの性能維持も今後の検証課題です。ARデバイスやインタラクティブな映像制作ツールへの実用展開を見据えた研究成果といえます。
論文情報: "LiveEdit: Towards Real-Time Diffusion-Based Streaming Video Editing"(Xinyu Wang et al., 2026) arXiv:2606.26740
本記事の図(図1、図3、図5)は解説のため上記論文より引用しています。


