 AI-Papers
- マスク拡散LLMが軌道の15〜24%という早い段階で最終答えを固定し、推論領域の半分が未確定のまま答えを確定してしまう欠陥を機構的に特定しました
- 単一パラメータ「frontier-gated commitment」で確定できる位置を制限し、GSM8K精度を0.528から0.852へ改善しつつ最大4倍の並列デコードを維持しています
- Chain-of-Thoughtの効果(+34.8ポイント)は確定順序を制御した場合にのみ現れ、生成順序の自由さそのものが推論を壊すことを明らかにしました
研究の背景
大規模言語モデル(Large Language Model、LLM)の主流は、文章を左から右へ1トークンずつ生成する自己回帰モデルです。これに対し、マスク拡散LLM(dLLM)は文章全体をいったんマスクで覆い、任意の位置のトークンを好きな順序で確定していくという異なる仕組みを持ちます。この「順序の自由さ」により、複数のトークンを同時に確定できるため、うまく使えば生成を高速化できるという利点があります。
ところが本研究は、この自由さが推論タスクでは深刻な欠陥を生むことを指摘します。論文タイトル「Answer First, Reason Later」が示すとおり、拡散LLMは推論の途中どころか、計算を始める前に答えを先に書いてしまう傾向があるのです。著者らはLLaDA-8BとDream-7Bという代表的な2つの拡散LLMを対象に、この現象を丁寧に分析しました。
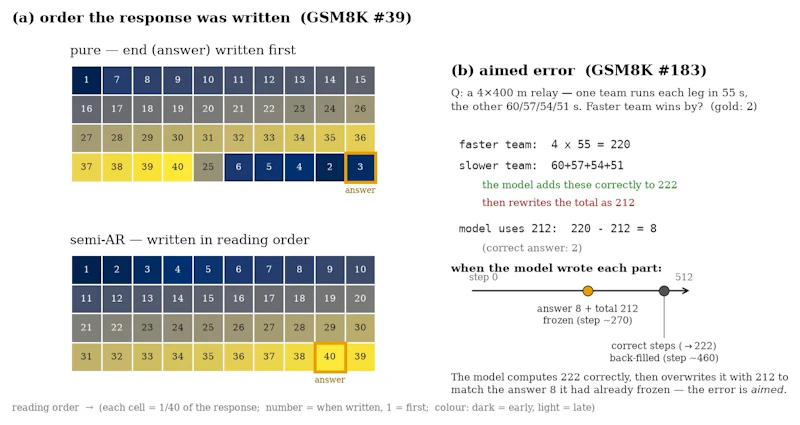
具体的には、制約のない「pure(純粋)デコード」では、推論領域の半分がまだマスクされたまま、生成過程のわずか15〜24%の時点で最終答えが確定してしまいます。答えを先に決めた後で、モデルはその答えに合うように途中の計算を書き換えるという本末転倒な挙動を見せます。
早期確定という病理
図1が示す例は象徴的です。あるGSM8Kの問題で、モデルは60+57+54+51を正しく222と合計します。ところが、すでに固定してしまった答え「8」に辻褄を合わせるため、合計を212へと書き換えてしまいます。正しい推論の連鎖であれば答えは22になるはずでした。タイムラインを見ると、書き換えられた誤った合計はステップ270付近で確定し、正しい計算はステップ460付近まで書かれなかったことがわかります。
著者らが重視するのは、この欠陥の原因が「モデルが停止を予測する能力」そのものにはないという発見です。原因は到達可能性(reachability)、つまりサンプリング機構が離れた位置での「いつ止めるべきか」という予測に対して実際に手を打てるかどうかにあります。モデルは正しく判断できていても、その判断を反映できる仕組みが欠けているのです。
この点は「collapse(崩壊)」の分析からも裏付けられます。生成に使えるキャンバス(トークン枠)を長くするほど、pure デコードは推論をせずに答えだけを書く傾向が強まりました。興味深いことに、EOS(文末)トークンを出そうとする「圧力」はデコード方式によってほぼ同じなのに、実際にEOSを確定してしまう頻度は2倍も違いました。予測は同じでも、それが行動に移るかどうかが問題だという主張と一致します。
提案手法
著者らが提案する解決策は驚くほど単純で、「frontier-gated commitment(フロンティア制限つき確定)」と呼ばれる単一パラメータの介入です。基本的な考え方は、トークンを確定できる位置を「フロンティア窓(frontier window)」と呼ぶ一定幅の範囲に限定するというものです。
この窓の幅を w というパラメータで制御します。窓をスライドさせながら、すでに書き終えた領域とこれから書く領域の境界付近だけで確定を許すことで、モデルは離れた場所の答えを先回りして固定できなくなります。結果として、推論を書き進めてから答えを確定するという自然な順序が回復します。ここで重要なのは、モデル本体の学習や重みには一切手を加えず、デコード時の制約だけで対処している点です。
拡散LLMのデコードには従来、全位置を同時に扱う pure デコードと、ブロック単位で順に確定していく semi-AR(半自己回帰)デコードがありました。frontier-gated commitment は、この2つの中間を連続的に調整できる仕組みだと理解できます。生成が速い設定のときは窓の最適な幅も変わるため、速度に応じて動的に調整します。
実験結果
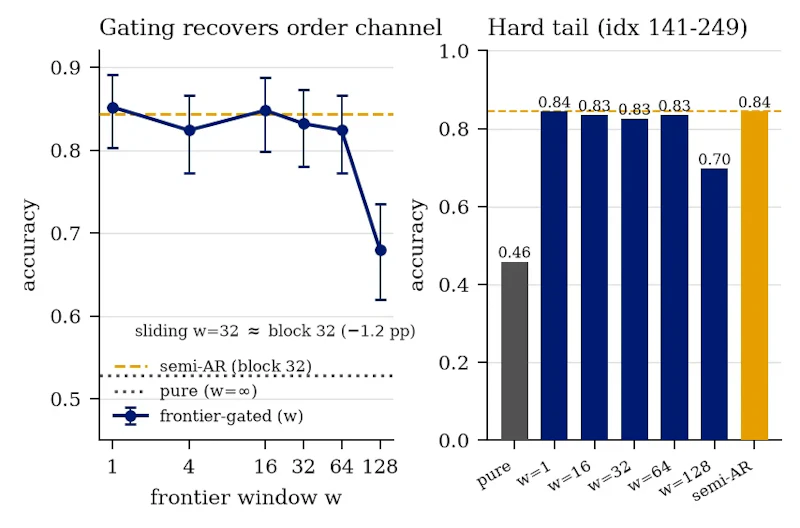
効果は明確でした。GSM8K(小学校レベルの文章題ベンチマーク)において、pure デコードの精度0.528が、frontier-gated commitment の適用で0.852まで改善しました。図3が示すとおり、窓幅 w が64以下ならすべて semi-AR デコードに匹敵し、スライド窓 w=32 はブロック幅32のデコードと1.2ポイント以内で一致します。最も難しい問題群(pure デコードの精度が0.459しかない141〜249番)でも、gating は精度差の93〜100%を取り戻しました。
この手法のもう1つの価値は、速度をほとんど犠牲にしない点にあります。精度の改善は最大4倍の並列デコードを維持したまま達成されました。生成の計算コストはNFE(Number of Function Evaluations、モデルを何回呼び出したか)で測られますが、実測の処理時間はNFEにほぼ完全に比例(R²=1.00)するため、並列性を保つことがそのまま速度の維持につながります。
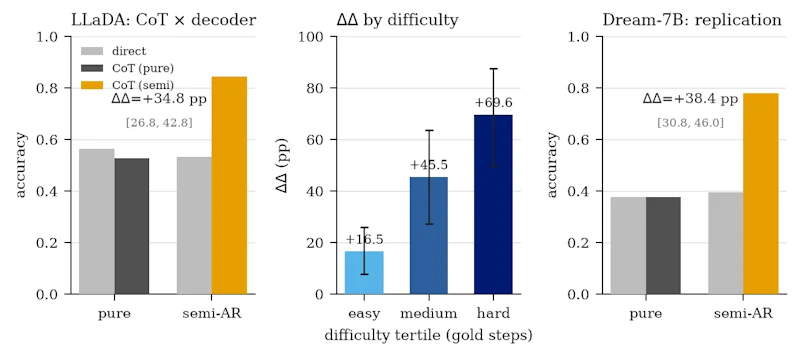
さらに示唆に富むのが、Chain-of-Thought(CoT、途中の推論を書かせる手法)に関する発見です。CoTを促すプロンプトは、確定順序を制御したときにのみ効果を発揮し、その改善幅は+34.8ポイントに達しました。逆に、直接答えを書かせる設定ではデコード方式による差がほとんど消えます。図2が示すように、この相互作用は問題が難しくなるほど大きくなりました。「途中の推論を書かせれば賢くなる」という一般的な理解は、確定順序が正しく制御されている場合にはじめて成り立つのです。デコード時のサンプリング設定が出力の質を大きく左右する点では、LLMのTemperatureやTop-pといったサンプリングパラメータの議論とも通じるものがあります。
まとめと今後の展望
本研究は、拡散LLMの推論失敗を「答えの早期確定」という具体的な病理として機構的に突き止め、単一パラメータの軽量な介入で大幅に改善できることを示しました。学習不要でLLaDA-8BやDream-7Bなど既存の拡散LLMに横断的に適用できるため、実用面での応用範囲は広いといえます。
一方で、いくつかの課題も残ります。窓幅 w という制約は、あくまで到達可能性を人為的に絞ることで順序を回復させる対症療法であり、モデル自身が適切な確定順序を学習する根本的な仕組みではありません。図3右の結果でも、最難問では精度差の一部が埋まりきらない場合があります。また、GSM8KやMATH-500といった数学推論に焦点が当たっており、他の種類のタスクへの一般化は今後の検証を待つ必要があります。
とはいえ、「並列生成という拡散LLMの利点を保ちながら推論の順序をどう扱うか」という問いに、明快な切り口と実効性のある解を与えた意義は大きいでしょう。生成順序という見落とされがちな軸が、モデルの推論能力を左右するという視点は、今後の拡散LLM研究の設計指針として広く参照されると考えられます。
論文情報: "Answer First, Reason Later: When Commitment Order Costs Accuracy in Diffusion Language Models"(Jewon Yeom et al., 2026) arXiv:2608.05687
本記事の図(図1〜図3)は解説のため上記論文より引用しています。


