 AI-Papers
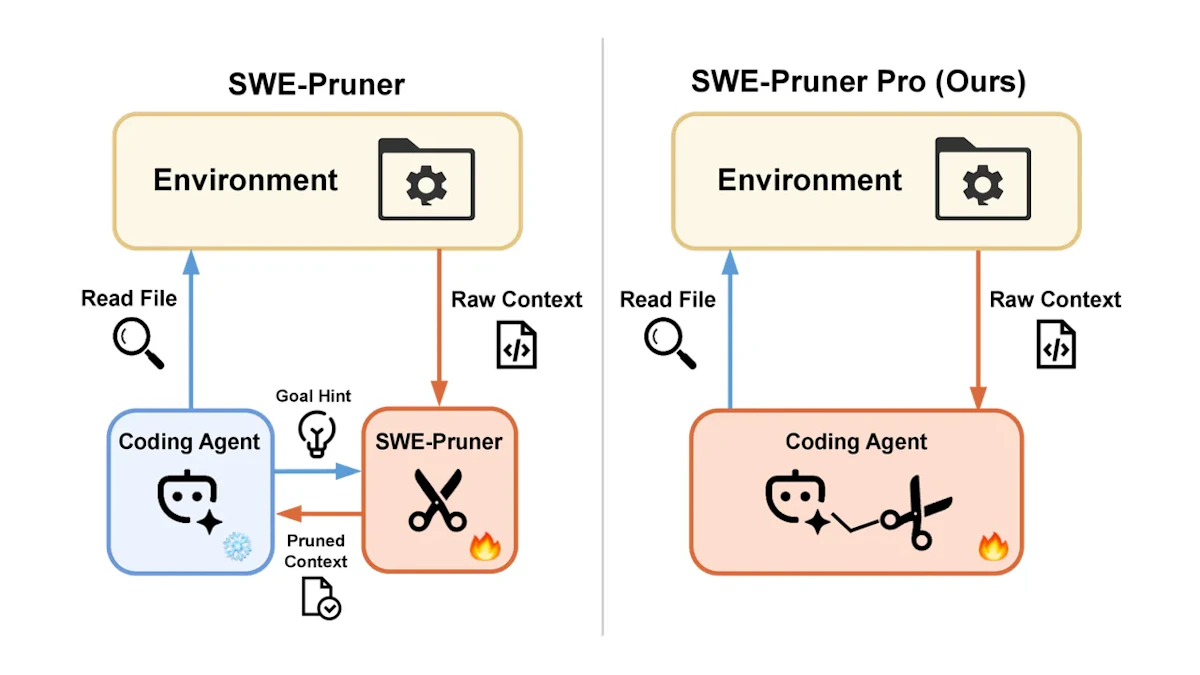
- コーディングエージェント自身の隠れ状態から行単位で残すか捨てるかを判定し、外部の判定モデルを不要にした手法です
- SWE-QA-Proで39.4%のトークン削減、SWE-Bench Verifiedでは解決率が326/500から345/500へ3.8%向上しました
- コードはGitHubで公開されており、追加の順伝播が不要なため処理コストは生成時間の中央値14.7%に収まります
研究の背景
コーディングエージェントは、ファイル閲覧、grep検索、テスト実行といったツールを何十回も呼び出しながら作業を進めます。返ってくるツール出力には、ライセンスヘッダ、空行、ディレクトリ一覧の .. エントリなど、後の判断に一切使われない行が大量に含まれています。
こうした行が履歴に積み上がると、コンテキストは数十万トークン規模まで膨れ上がります。トークン単価の課金と推論の遅延がそのまま増えるうえ、必要な情報がノイズに埋もれて精度まで落ちるという二重の損失が生じてしまうのです。
従来の対策は、刈り込み専用の別モデルを用意する方式でした。ただしこの方式ではエージェントが毎ターン「今から何を知りたいのか」という目的のヒント文を明示的に書き出す必要があり、追加のモデル呼び出しと余分な出力トークンが発生します。長期タスクでコンテキストを膨らませない設計という点では、AgenticSTSのメモリ設計とも問題意識が重なる領域と言えるでしょう。
エージェントは既に知っている
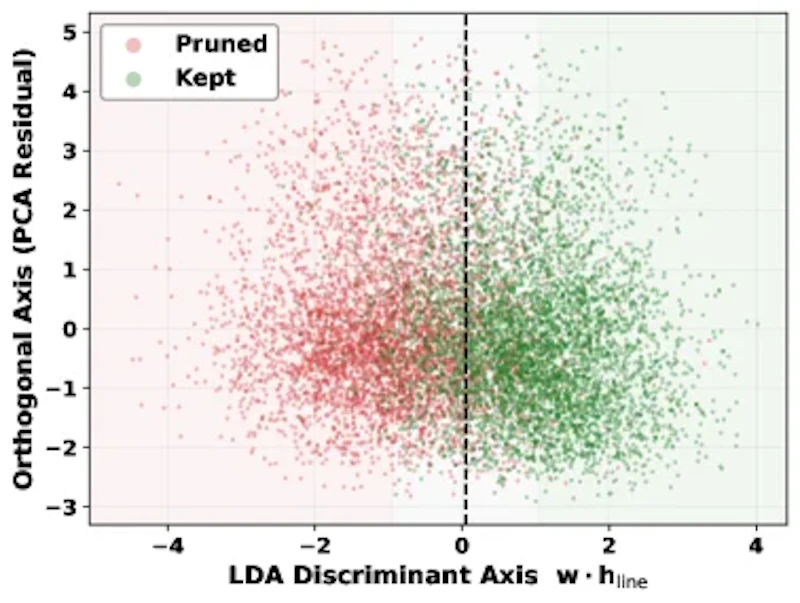
著者らの出発点は、エージェント本体がツール出力を読んだ時点で、どの行が重要かという情報を内部表現として既に持っているのではないか、という仮説でした。
検証として、Qwen3-Coder-Nextの最終層の隠れ状態(モデル内部で各トークンを表す数値ベクトル)を凍結したまま、線形の判定器を1つ載せて「残すべき行かどうか」を予測させています。結果はAUC 0.83(ROC曲線の下側の面積を表す指標で、1.0が完全な分離、0.5がでたらめな予測と同水準)、最良のF1スコアは0.63でした。
単純な線形分離でこの水準に届くという事実は、関連性の情報が隠れ状態にすでに符号化されていることを示しています。一方で2クラスのスコア分布は中間帯で重なっており、線形の判定器だけでは実用に足りないことも同時に分かりました。
SWE-Pruner Proの仕組み
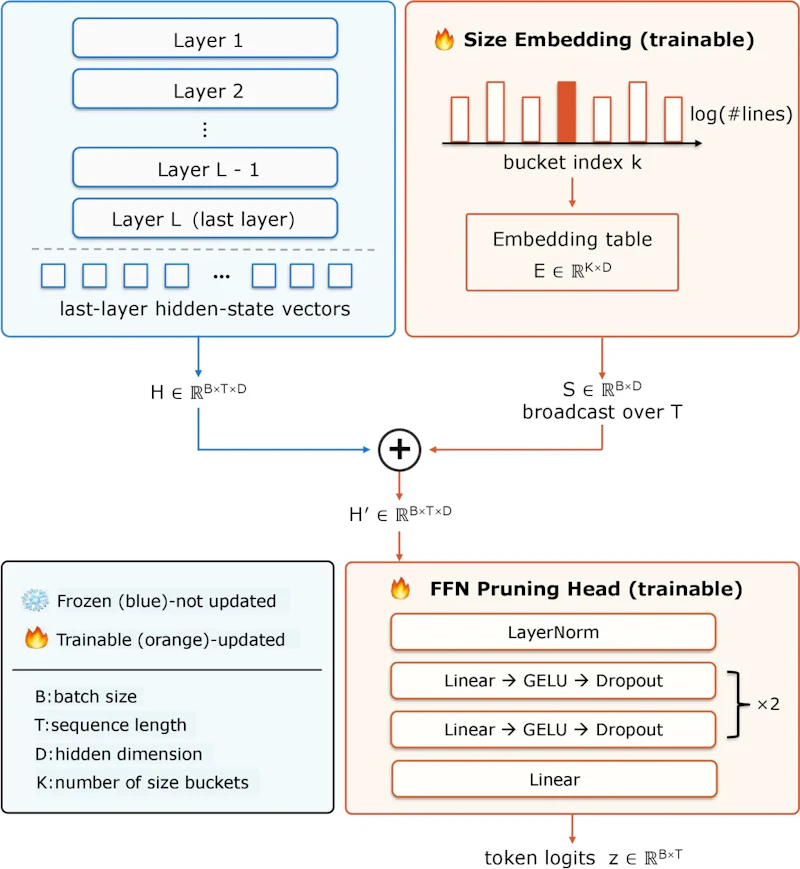
提案手法は、エージェント本体の推論の「ついで」に判定を済ませる設計になっています。エージェントは各ターンで履歴、ツール呼び出し、ツール応答をまとめてprefillします。prefillとは、モデルが入力トークン全体を一度に読み込んで内部状態を構築する処理のことです。
このとき新しく追加されたツール応答のトークンについても隠れ状態が計算されるため、SWE-Pruner Proはそれを横から読み取るだけで判定材料が揃います。ツール応答に対して改めて順伝播を走らせずに済むのが、この設計の要となっています。
読み取った隠れ状態は小さな判定ヘッドに渡され、トークンごとに「残す」確率が出力されます。行の中の多数決で最終的な行単位の判定を下し、刈り込まれた応答が次のターンの履歴に置き換わる、という流れになります。
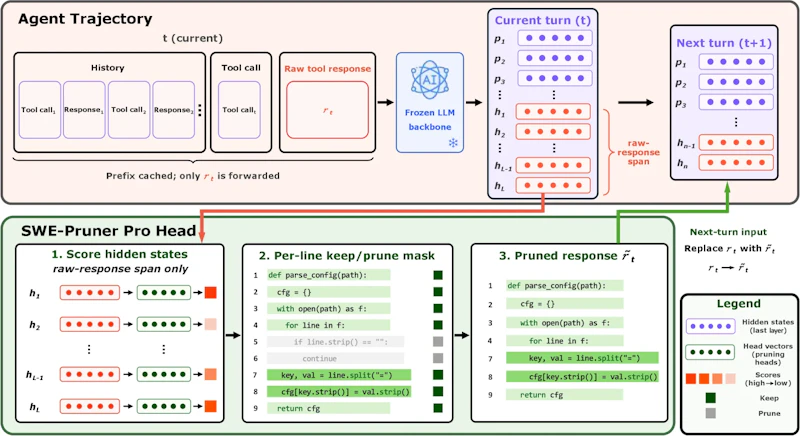
ヘッド自体は、LayerNormとドロップアウトを挟んだ2ブロックの全結合層という軽量な構成です。特徴的なのは長さを意識した埋め込みで、ツール応答の行数を8段階の対数バケットに分けて加算しています。3行のコマンド出力と500行のファイル閲覧では残すべき割合が当然違う、という前提を明示的にモデルへ伝えるための工夫でしょう。
学習データと損失の工夫
学習データはHuggingFace上の5つの軌跡データセットから構築されました。共通形式に整形して5万件の多様なプールを選び出したうえで、Claude Sonnet 4.6に行単位のラベルを付けさせ、最後に人手のチェックで不正なラベルを除いています。最終的に6,252本の軌跡から22,609サンプルが得られました。
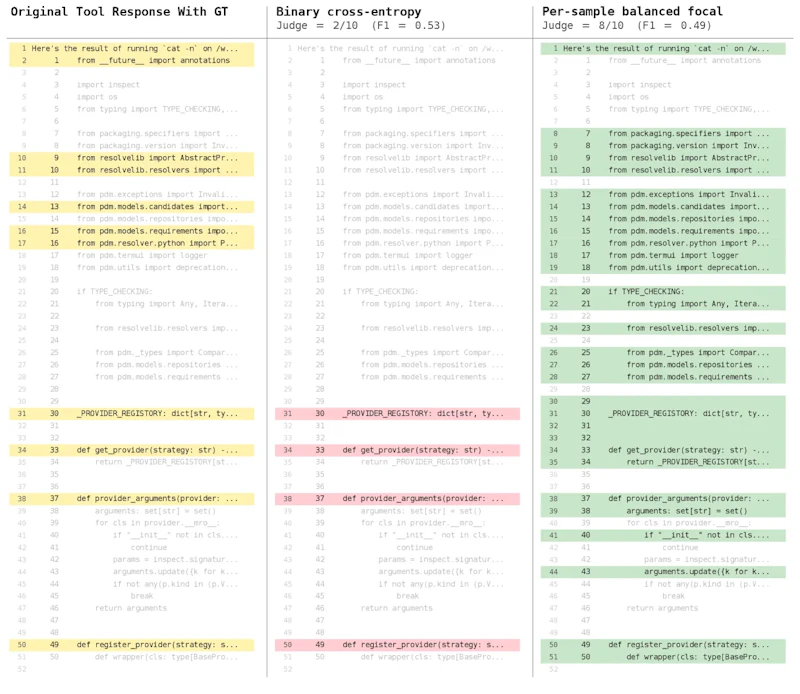
損失関数の設計は、実務的に効いた部分と言えます。標準的なBCE(Binary Cross-Entropy、2値分類で広く使われる損失関数)で学習すると、残すべき行が少数派であるためヘッドが極端に保守的になり、関数のシグネチャだけを残して本体をすべて捨てるという挙動を示しました。
採用されたのは、サンプルごとに正例と負例の損失を別々に平均して等重みで足すbalanced focal lossです。F1スコアだけを見ると他手法と大差がない場面もありますが、下流タスクの判定スコアではBCEの5.95に対して7.08と明確な開きが出ています。指標の数字だけでは手法の良し悪しを測れないという指摘は、他の分類タスクにも通じる教訓でしょう。
実験結果
評価は2つのバックボーンと4つのマルチターンベンチマークで行われました。バックボーンはMiMo-V2-Flash(309BのMoE、Mixture of Expertsの略で、トークンごとに一部の専門家ネットワークだけを動かす構成。実際に動くのは15B分)と、Qwen3-Coder-Next(80BのMoE、活性3B)の2つです。
ベンチマーク | バックボーン | ベースライン | 提案手法 | トークン削減 |
|---|---|---|---|---|
SWE-Bench Verified | MiMo-V2-Flash | 326/500 | 345/500 | - |
Oolong | MiMo-V2-Flash | 92.4% | 94.6% | 30.1% |
SWE-QA-Pro | Qwen3-Coder-Next | 7.60 | 7.84 | 39.4% |
SWE-QA | Qwen3-Coder-Next | 7.71 | 7.73 | 34.7% |
トークンを3割から4割削っても品質が落ちない、それどころか向上する場面があるというのが主要な主張です。長文脈ベンチマークのOolongでMiMo-V2-Flashが92.4%から94.6%へ伸びた結果は、無関係な行を捨てること自体が読解の助けになっている可能性を示しています。
比較対象にはLLMLingua2、Selective Context、RAGによる検索、LongCodeZip、そして目的ヒントを必要とする従来のSWE-Prunerが並びました。処理コストについては、ヘッドの実行時間が生成時間全体に対して中央値14.7%、95パーセンタイルで34.8%と報告されています。削減されるトークン量を考えれば十分に見合う範囲でしょう。
まとめと今後の展望
この研究の面白さは、新しい判定モデルを足すのではなく、すでにモデルの中にある情報を取り出しただけという点にあります。隠れ状態はどうせ計算されているのだから、それを捨てずに使えばよい、という発想の転換です。
一方で制約もはっきりしています。隠れ状態にアクセスできるオープンウェイトモデルでしか使えないため、APIのみで提供される商用モデルには適用できません。ベンチマークもPython中心で、他言語での挙動は未検証のままです。
結果も一様ではありません。Qwen3-Coder-NextとOolongの組み合わせでは精度が81.7%から80.3%へ下がっており、削減が常に無償というわけではないと分かります。著者らも、積極的な刈り込みを安全性が重要な場面で使う際はバックボーンごとの検証が必要だと述べています。それでもコードが公開されている点を踏まえると、トークン課金に悩む開発現場が自分の環境で効果を確かめる価値は十分にあるはずです。
論文情報: "SWE-Pruner Pro: The Coder LLM Already Knows What to Prune"(Yuhang Wang et al., 2026) arXiv:2607.18213, CC BY 4.0
本記事の図(図1、図2、図3、図4、図11)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


