 AI-Papers
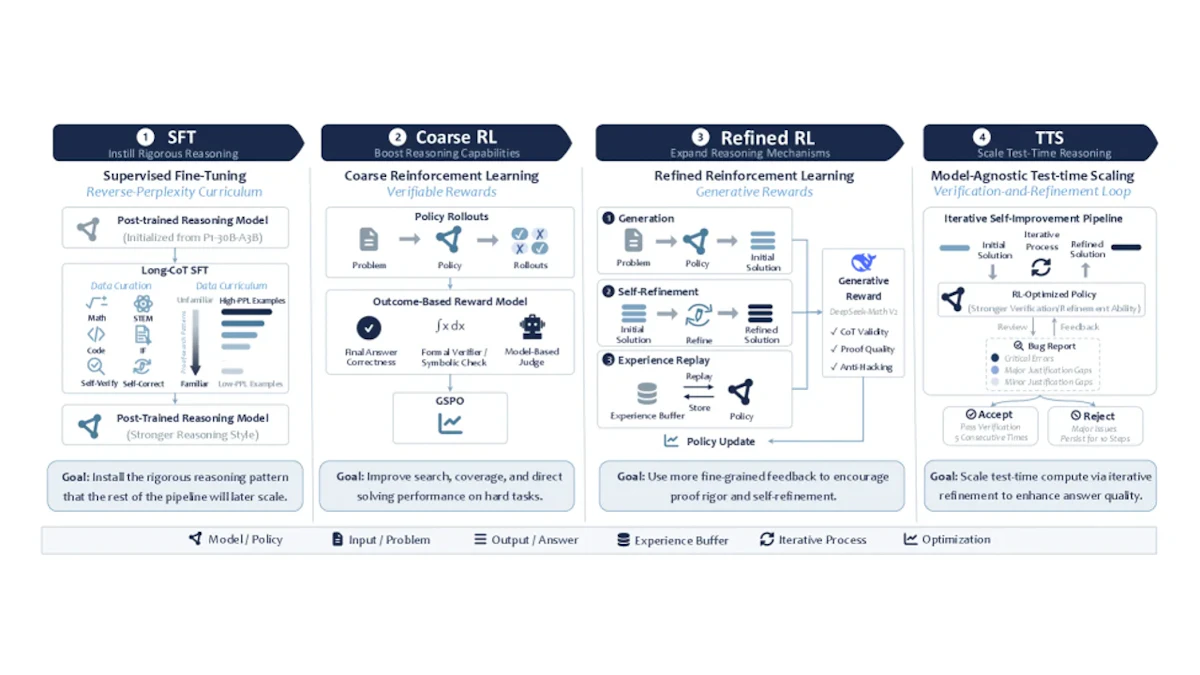
- 30B総パラメータ・3B active(MoE)のSU-01がIMO 2025で35点、USAMO 2026で35点を記録し、いずれも金メダルラインを突破
- 逆パープレキシティカリキュラムSFT→二段階RL→テスト時スケーリングの三段階レシピで、コンパクトなモデルでの高度な数学推論を実現
- IMO-ProofBenchでテスト時スケーリング適用により70.2%を達成。コードとモデル重みが全公開で再現性も高い
研究の背景と課題
国際数学オリンピック(IMO)や全米数学オリンピック(USAMO)は、世界最高水準の数学的思考力を要求するコンテストです。近年、大規模言語モデル(LLM)がこうした競技数学の問題をどこまで解けるかが、AI研究の重要な指標として注目を集めています。
しかし、オリンピアドレベルの推論を実現するには単純なパラメータ増加だけでは不十分です。訓練データの質・学習順序・強化学習の設計・テスト時の計算活用など、複数の要素を統一的に最適化する必要があります。本論文が提案するSU-01は、この課題に対して三段階の「統一スケーリングレシピ」で取り組んだ研究です。
モデルの基本構成
SU-01のバックボーンは30B総パラメータ・3B activeのMoE(Mixture of Experts、複数の専門家モジュールから必要なものを動的に選択する構造)モデルです。このコンパクトな設計により、推論効率を保ちながら高度な推論能力を獲得することを目指しました。
SFT(教師あり微調整)では約338K件の軌跡を使用し、RLでは最大160Kトークンの応答長で訓練されています。100Kトークンを超える長い推論チェーンでも安定して動作する点が、実際の数学証明タスクへの対応力につながっています。
三段階訓練パイプラインの全体像
SU-01の訓練は大きく三つのフェーズで構成されています。
第一フェーズの逆パープレキシティカリキュラムSFTでは、各訓練サンプルをモデルにとっての「難しさ」(パープレキシティ)でスコアリングし、難しいものから易しいものへと順番に学習させます。この逆順学習により、モデルは最初に既存知識と大きく異なる証明探索パターンを習得し、その後で馴染み深い例で定着させるという流れになります。従来の「易しい順から学ぶ」アプローチに比べ、既存能力を保ちながら厳密な推論行動を形成できることが確認されています。
第二フェーズは二段階強化学習(RL)です。まず粗RL(Coarse RL)では8,967件の検証可能なプロンプトを使い、答えの正誤による二値報酬でGSPO(グループシーケンス政策最適化)を適用して推論行動の幅を広げます。続く洗練RL(Refined RL)では、証明レベルの報酬・自己改良・経験リプレイを組み合わせ、証明の品質そのものを最適化します。
第三フェーズのテスト時スケーリング(TTS)では「解く→検証→修正」のループを反復し、推論軌跡を段階的に改良します。このプロセスにより、直接生成では届かなかった難問に対しても金メダルレベルの解答が可能になりました。
SFTデータの構成と訓練段階ごとの性能推移
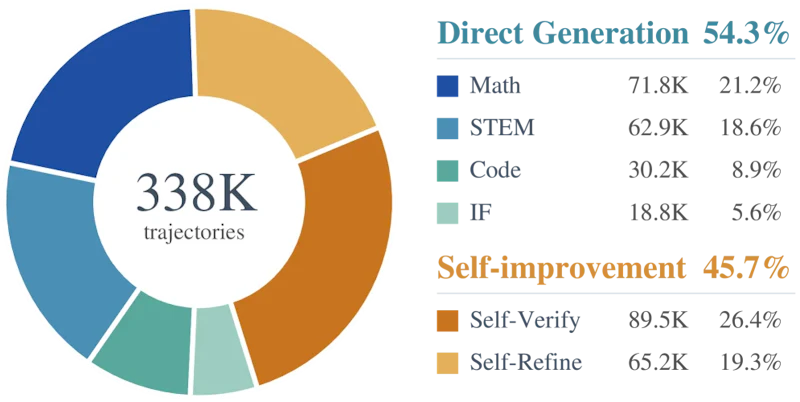
SFTに使用した338K件の軌跡は、数学(Evan Chenの資料・AoPS・Shuzhimi Forum・DeepMath等)、科学(NaturalReasoning)、コード・指示追従(Nemotron・Eurus-2・OpenCodeReasoning)など多様なソースから構成されています。
データはさらに「直接生成グループ」と「自己改善グループ」に分類されます。前者には数学・STEM・コード・指示追従のデータが含まれ、後者には自己検証と自己改良のトレースが含まれます。全サンプルを最大8,192トークン以下に制限することで高品質なデータのみを保持しています。研究レベルの数学ベンチマーク「Soohak」でも示されているように、高品質な数学データの確保はLLMの数学推論能力向上の根幹をなす要素です。
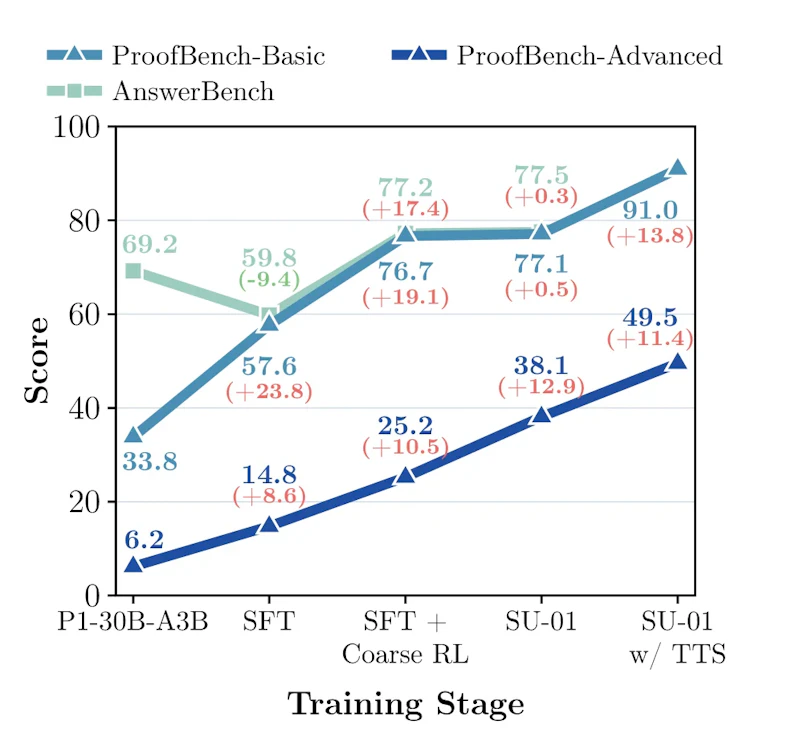
各訓練段階での性能推移を見ると、SFTから粗RL、洗練RLへと段階を踏むごとに推論性能が着実に向上していることが確認されています。特に洗練RLフェーズでの証明品質の改善は、IMO-ProofBenchのような証明指向のベンチマークで顕著に現れています。
オリンピアドでの実験結果
SU-01の最大の成果は、実際の数学・物理オリンピアドにおける金メダルレベルの性能達成です。
大会 | 直接生成 | テスト時スケーリング | 達成水準 |
|---|---|---|---|
IMO 2025 | 21点 | 35点 | 金メダルライン到達 |
USAMO 2026 | 15点 | 35点 | 金メダルライン+10点超 |
IPhO 2024 | 23.5点 | 25.3点 | 金メダルライン超過 |
IPhO 2025 | 20.3点 | 21.7点 | 金メダルライン超過 |
USAMO 2026では340人の競技者中の最高スコアである35点と同等の成績を記録しました。直接生成だけでは金メダルに届かないケースでも、テスト時スケーリングを組み合わせることで確実に突破できる点が、このパイプラインの実用的な強みを示しています。
証明ベンチマーク「IMO-ProofBench」では、テスト時スケーリング適用時に全体70.2%(基本問題91.0%・高度問題49.5%)を達成しました。これは大型モデルであるGemini 3.1 Proの72.6%に迫る性能で、同規模モデルの中では最高水準です。数学・STEM・コード・科学にわたる汎化性能(AnswerBench・AMO-Bench・AIME・FrontierScienceの平均)でも77.3%を記録し、同規模の競合モデルであるQwen3.6-35B-A3B(77.4%)とほぼ同等の水準を達成しています。
まとめと今後の展望
SU-01は、コンパクトなMoEモデルでも適切な訓練レシピを設計すれば国際数学オリンピアドレベルの推論が実現可能であることを示しました。逆パープレキシティカリキュラム・二段階RL・テスト時スケーリングという三つの要素を統一的に組み合わせた点が、本研究の核心的な貢献です。
数学・物理を超えた科学的推論への汎化も確認されており、今後は化学・生物・工学など他の科学分野への応用が期待されます。コードとモデル重みが全て公開されているため再現性が高く、研究コミュニティでの活用も容易です。一方で、高度問題カテゴリのIMO-ProofBenchは49.5%にとどまっており、より難度の高い問題への対応は引き続き課題として残っています。
論文情報: "Achieving Gold-Medal-Level Olympiad Reasoning via Simple and Unified Scaling"(Yafu Li et al., 2026) arXiv:2605.13301, CC BY 4.0
本記事の図(図1〜図3)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


