 AI-Papers
- ノイズ成分を低ランク部分空間に限定しデータ成分をフルランクで保持する「非対称速度パラメータ化」により、ImageNet 256×256でFID 1.57という現時点の最高水準を達成
- アーキテクチャや学習手順を変更せずに既存のフローモデルへ導入でき、従来の最良手法と比べて40%速い収束を実現
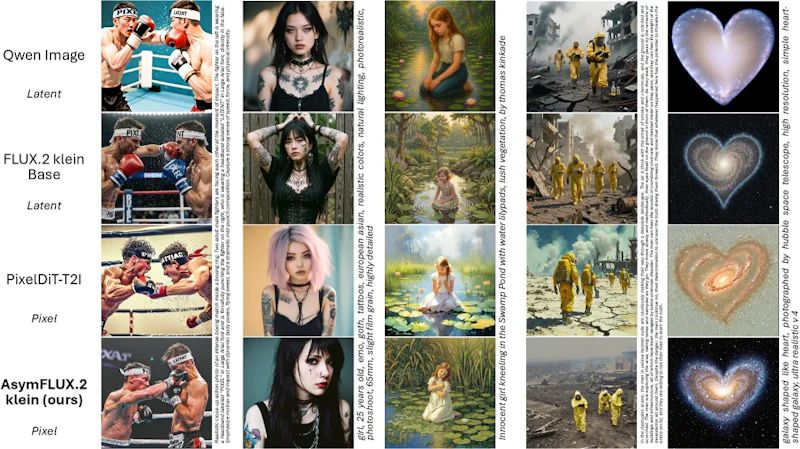
- 潜在空間フローモデル(FLUX.2 klein 9B)をピクセル空間に変換する初の実用的手法も提案し、テキストから画像生成でHPSv3 10.66を達成
研究の背景と課題
フロー整合(Flow Matching)とは、ランダムなノイズから目的の画像へと至るベクトル場(速度場)を学習する生成モデルの枠組みです。動画生成にも応用が広がるAnyFlowのように、この手法は画像・動画を問わず現在の生成AIの中心的フレームワークとして急速に普及しました。
しかし高解像度画像においては、速度予測の際に高次元のノイズを内部表現として保持し続ける必要があり、学習の効率と生成品質に制約をもたらしていたのです。
従来の速度パラメータ化は、データ成分とノイズ成分を対称的に扱う設計です。しかし実際には、画像のデータ(x₀)は低次元の構造的特徴に集中している一方、ノイズ(ε)はより高次元で複雑な構造を持ちます。この非対称性を設計に取り込むことが、フロー生成モデルの性能をさらに引き出すカギと、Stanford大学の研究チームは考察しました。
非対称速度パラメータ化の仕組み
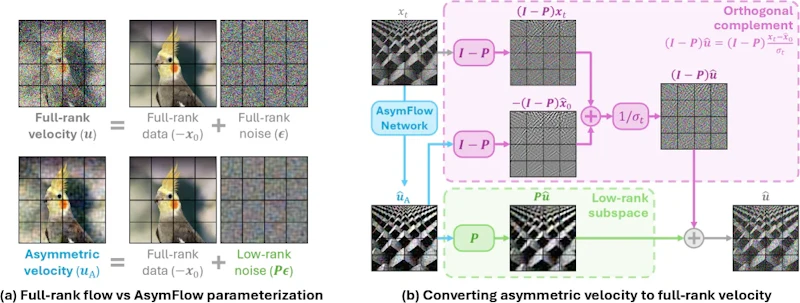
AsymFlowの核心は、速度予測を非対称に設計する点にあります。速度場を「データ成分(x₀)」と「ノイズ成分(ε)」の2つに分解し、それぞれを異なる方法で処理するのが大きな特徴です。データ成分はフルランクのまま維持する一方、ノイズ成分だけを低ランク部分空間への射影(P·ε)に限定することで、高次元ノイズの学習負荷が大幅に下がります。
速度の復元には、低ランク成分(P·û_A)はそのまま速度として直接利用し、直交補集合の成分はx₀からuへの解析的変換式で補完します。これによりフルランクの速度場を完全に再構築でき、ネットワーク構造への変更は不要です。
低ランク部分空間の構成には主成分分析(PCA)ベースの手法が採用されており、ランク数 r=8 が最適なバランスをもたらすことが実験で確認されています。ランダムな部分空間と比べ、PCAベースの構造化された部分空間のほうが大幅な改善をもたらしました。
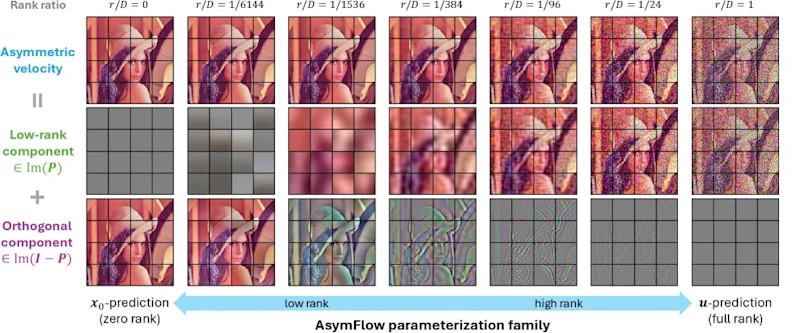
さらにランクrを変化させることで、標準的なx₀予測(r=0)と通常のu予測(フルランク)を両端に持つパラメータ化族が定義され、最適な設定を柔軟に選択できます。
潜在空間からピクセル空間への変換
AsymFlowのもう一つの重要な貢献として、既存の潜在空間フローモデルをピクセル空間のモデルへと変換する初の実用的な手法が挙げられます。FLUX.2 klein(9Bパラメータ)のような大規模な潜在空間モデルをピクセル空間に直接適用するには、通常はアーキテクチャの大幅な改変が必要でした。
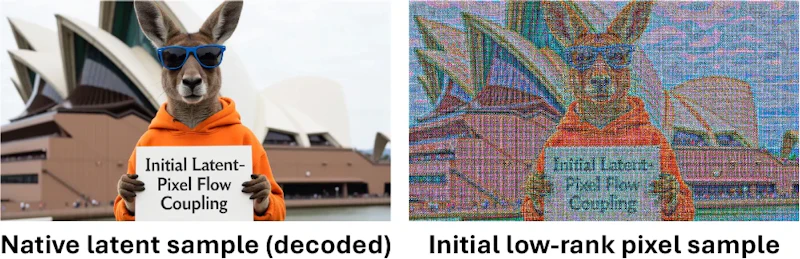
AsymFlowはProcrustes整合を用いた初期化によってこの障壁を取り除き、潜在モデルが持つ意味的・構造的な表現を継承したまま微調整を実施できます。
変換後のモデル(AsymFLUX.2 klein)には、分散削減損失(Variance Reduction Loss)も組み合わされています。これは制御変量法を応用したもので、微調整中の勾配の分散を抑えることで学習を安定させます。過剰なノイズが発生した際には、LPIPS知覚損失で補正を行い、細部の鮮明さを維持する仕組みです。
実験結果と性能比較
ImageNet 256×256の条件付き画像生成において、AsymFlowはFID 1.57という最高水準のスコアを達成しました。FID(Fréchet Inception Distance)は低いほど生成品質が高いことを示す指標で、これは従来の最良手法であるJiT-H/16を明確に上回る成果です。収束速度においても40%の高速化が確認されており、少ない学習ステップで同等以上の品質が得られます。
テキストから画像生成(1024×1024)の評価では、AsymFLUX.2 kleinが次の表のスコアを記録しました。
評価指標 | AsymFLUX.2 klein | FLUX.2 klein |
|---|---|---|
HPSv3 | 10.66 | 9.50 |
DPG-Bench | 86.8 | - |
GenEval | 0.82 | - |
ベースとなるFLUX.2 kleinのHPSv3スコアと比べると、視覚品質の向上が数値にも明確に表れています。
まとめと今後の展望
AsymFlowは、フロー整合の速度パラメータ化を非対称にするというシンプルなアイデアで、ImageNetのFID 1.57という現時点での最高性能を達成しました。アーキテクチャの変更を必要とせず既存の学習パイプラインにそのまま組み込める点は、実装面での大きな利点といえるでしょう。
潜在空間モデルをピクセル空間に変換する手法についても、今後のテキストから画像生成モデルの発展に向けた汎用的な枠組みとなり得ます。超高解像度への拡張や微調整コストのさらなる最適化など課題は残るものの、Stanford大学の研究チームによるこの成果は、フロー生成モデルの設計に新たな視点をもたらしました。
論文情報: "Asymmetric Flow Models"(Hansheng Chen et al., 2026) arXiv:2605.12964
本記事の図(図1〜図4)は解説のため上記論文より引用しています。


