 AI-Papers
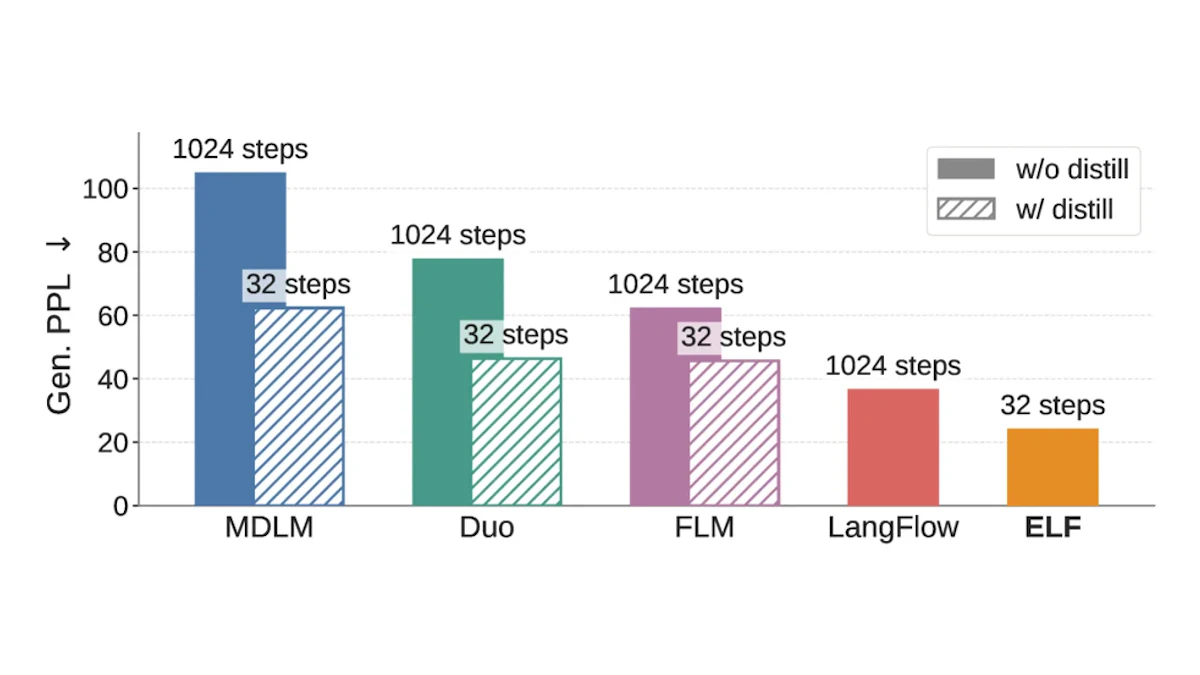
- 最終ステップまで連続埋め込み空間を維持するFlow Matchingベース拡散言語モデルで、CFGなど画像生成の制御技術をテキスト生成にそのまま転用可能にした
- 蒸留なしで既存の離散・連続拡散言語モデルを上回る生成品質を達成し、トレーニングトークン数は先行研究比で10分の1にとどまる
- ResNet提案者Kaiming HeらMITグループによる論文で、コードはGitHubで公開され再現性が担保されている
研究の背景
画像生成の分野では、Flow Matching(フローマッチング)がDiffusion Modelとともに急速に主流の手法となっています。Classifier-Free Guidance(CFG)をはじめとする制御技術も整備され、高品質な生成が幅広いタスクで実現されるようになりました。これらの手法は連続値を前提として設計されており、ピクセルや潜在ベクトルと相性がよいためです。
一方、テキスト生成は本質的に離散的なトークンの列を扱います。テキスト向けの拡散モデル(Diffusion Language Model、DLM)の多くは離散空間上でノイズ除去を行うか、連続空間を採用しても生成途中で強制的に離散化するため、画像生成の技術をそのまま転用できないという制約がありました。連続空間を活用する先行研究もいくつか存在しましたが、最終ステップ前に離散化を挟む設計では表現の自由度が損なわれ、品質改善には限界があったのです。
こうした課題に対し、MITのKaiming He(ResNetの提案者)らのグループは、連続埋め込み空間を最後のステップまで維持し続けるFlow Matchingベースの拡散言語モデル「ELF(Embedded Language Flows)」を発表しています。
ELFの設計と手法
ELFの核心は「最終タイムステップに至るまで連続埋め込み空間にとどまり続ける」という設計思想です。まずトークンを連続的な埋め込みベクトルに変換し、そのベクトル空間内でFlow Matchingを適用します。ガウスノイズから出発してイテレーティブに埋め込みを洗練させ、最終ステップにのみ共有重みネットワークを用いて離散トークンへ変換する仕組みです。
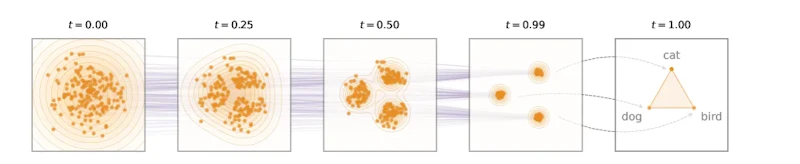
このアプローチにより、画像生成で確立されたCFGや自己条件付け(self-conditioning)などの技術を自然に転用できます。CFGの実装では訓練時CFGを採用しており、自己条件付けから得た条件信号を活用することで単一のネットワークパスでガイダンス付き推論を実現しました。通常のCFGで必要な2回分のフォワードパスをなくしたことは、推論コスト面でも利点があります。
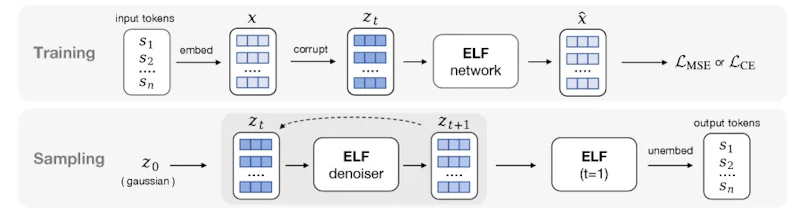
学習はデノイジングモードとデコーディングモードを単一ネットワークで共有する設計です。デノイジング時は予測した埋め込みと正解の埋め込みのずれを測るMSEロス、デコーディング時は正解トークンの予測確率を高めるトークン単位の交差エントロピーロスを使用します。
事前学習済みのT5エンコーダから取得した文脈的埋め込みの使用が品質向上に重要であり、瓶首次元(bottleneck dimension)を128に設定することで多様性と生成品質の最良のバランスが得られると報告されています。連続潜在拡散を活用するCola DLMなど先行する連続DLMとの比較も詳細に行われており、設計上の優位性が明確に確認できます。
実験結果
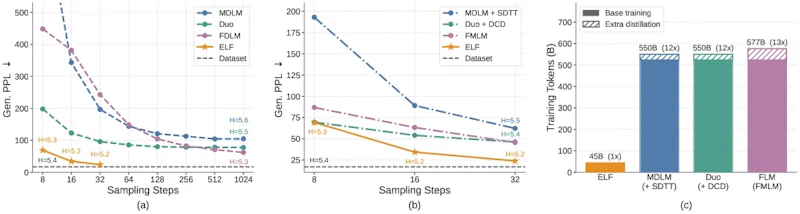
OpenWebText(OWT)データセットを用いた無条件テキスト生成の評価では、ELF-B(105Mパラメータ)は32サンプリングステップで生成パープレキシティ(Gen. PPL、生成文の自然さを測る指標で低いほどよい)24を達成しています。比較対象の170Mパラメータクラスの離散・連続DLMを少ないサンプリングステップで上回り、かつトレーニングに使ったトークン数は約45Bと先行研究(500B以上)の10分の1にとどまります。蒸留による追加トレーニングが必要な先行手法のバリアントとも比肩する性能を記録しました。
条件付き生成タスクでも良好な結果が示されています。WMT14 De-En翻訳ではBLEUスコア26.4を記録し、XSumニュース要約ではROUGEメトリクス全項目で比較ベースラインを上回りました。CFGスケールを2前後に設定するのが最適とのことで、過度に強いガイダンスは性能をわずかに低下させることも確認されています。
ELF-Bについて本文で触れた主な数値をまとめると、次の表のとおりです。
項目 | ELF-Bの結果 |
|---|---|
パラメータ数 | 105M |
サンプリングステップ | 32 |
生成パープレキシティ(OWT) | 24 |
トレーニングトークン数 | 約45B |
WMT14 De-En翻訳(BLEU) | 26.4 |
これらの数値は、無条件生成と条件付き生成の双方で小規模なトレーニング量のまま実用的な品質に届いていることを示しています。アブレーション実験では、確率的な軌跡をたどるSDEインスパイアードサンプラーが、決定的な軌跡をたどるODEサンプラーより少ないステップで低い生成パープレキシティを達成できることが示されました。モデルサイズのスケーリングに伴う性能改善も一貫して観察されています。
まとめと今後の展望
ELFは、Flow Matchingを言語生成に本格適用することで、連続埋め込み空間が拡散言語モデルの有効な基盤となり得ることを実証した研究です。CFGや自己条件付けなど画像生成で培われた技術群をそのまま取り込め、少ないトレーニングデータで既存DLMを上回る性能を実現した点は、今後の言語モデル研究に示唆をもたらします。
ただし、比較対象はGPT-4やLLaMA3などの大規模自己回帰モデルではなく、DLMカテゴリ内にとどまります。アーキテクチャや推論効率において大規模自己回帰モデルとのギャップを埋めるには、さらなる研究が必要でしょう。コードはGitHubで公開されており、再現性と拡張研究への利便性は高く評価できます。
論文情報: "ELF: Embedded Language Flows"(Keya Hu et al., 2026) arXiv:2605.10938, CC BY 4.0
本記事の図(図1〜図3)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


