 AI-Papers
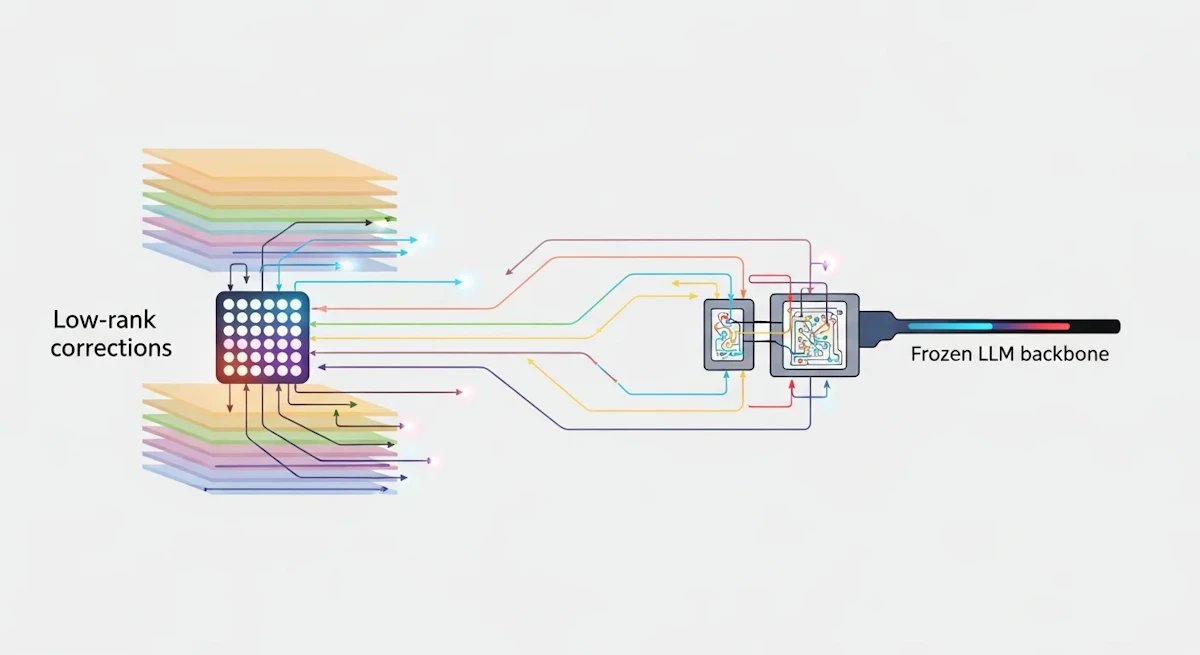
- LLMのバックボーンを凍結したまま8×8の連想記憶状態行列をDelta則で逐次更新する軽量メモリ機構「δ-mem」を提案し、フルファインチューニング不要で長期記憶能力を付与
- MemoryAgentBenchで凍結バックボーン比1.31倍、長期対話ベンチマークLoCoMoで1.20倍の性能向上を達成し、RAGやKVキャッシュ圧縮を上回る結果を確認
- HuggingFaceにdeclare-lab/delta-mem_qwen3_4b-instructとして即日公開。エージェントや長期対話システムへの実用的な適用が今すぐ可能
研究の背景
大規模言語モデル(LLM)は膨大な知識を持つ一方、長い会話や複数ターンにわたるタスクをこなす際に「記憶の欠如」という課題を抱えています。トークン数に上限があるコンテキストウィンドウをいくら拡張しても、推論コストは二乗で増加し、実運用での制約は解消されません。
さらに長大なコンテキストでは「Lost in the Middle(中間情報の見落とし)」問題も報告されており、単純にウィンドウを広げるだけでは情報の取りこぼしが生じます。
この問題へのアプローチは、大きく二つに分けられます。
- RAG(検索拡張生成): 外部データベースから関連情報を検索して補う
- KVキャッシュ圧縮: コンテキスト内に保持した情報を圧縮する
ただし前者は検索レイテンシやインデックス管理のコストが発生し、後者は情報の圧縮に伴う精度低下が避けられません。そこで登場したのが δ-mem です。LLMのバックボーンを一切変更せずに「連想記憶」という神経科学の知見をモデルに組み込み、外部リソースを使わずに長期記憶を実現するという着想から生まれました。
δ-memの仕組み
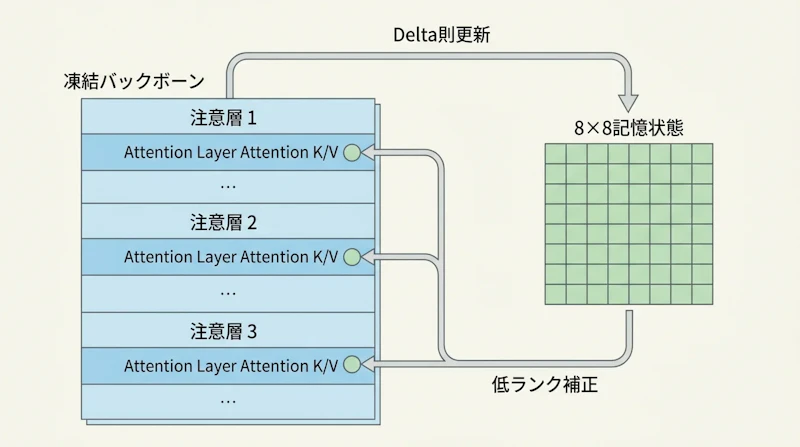
δ-memの核心は「固定サイズの連想記憶状態行列M(8×8)」です。この行列は各ターンの入力を受け取るたびにDelta則(Delta rule)によって更新されます。Delta則とは、ニューラルネットワークの学習則の一つで、現在の予測誤差だけを使って重みを更新するシンプルかつ生物学的にも妥当なルールです。バックプロパゲーション全体ではなく局所的な誤差信号だけで記憶を更新できるため、ストリーミング入力にも対応します。
記憶から情報を取り出す際は、8×8の状態行列から「低ランク補正(low-rank correction)」を生成し、バックボーンのAttention計算に注入します。具体的には、現在のクエリベクトルを用いて状態行列からキー成分とバリュー成分を生成し、既存のAttention演算に加算する形で動作します。
元のAttentionが「現在のコンテキスト内」の情報に注目するのに対し、δ-memの補正成分は「過去の会話履歴全体」から蒸留された記憶を補完的に提供します。
この設計で効いているのは、バックボーンのパラメータを一切更新しない点です。追加されるのは8×8の状態行列と、それを更新・読み出しするための軽量モジュールだけ。フルファインチューニングのようにGPUメモリを大量消費せず、既存のチェックポイントにアダプタとして後付けできます。コンテキスト長を伸ばすことなく記憶能力を拡張できるため、デプロイコストを抑えたまま長期対話システムへ組み込めます。
実験結果
δ-memはMemoryAgentBenchとLoCoMoという二つのベンチマークで性能を検証しました。MemoryAgentBenchはエージェントが長期タスクを遂行する能力を測る評価セット、LoCoMoは長期対話の記憶保持を評価するベンチマークです。結果は次の通りです。
評価軸 | δ-memの改善倍率 | 比較対象 |
|---|---|---|
MemoryAgentBench | 1.31倍 | 凍結バックボーン単体 |
LoCoMo | 1.20倍 | 凍結バックボーン単体 |
全ベンチマーク平均 | 1.15倍 | 他のメモリ手法 |
既存手法との比較では、RAGや各種KVキャッシュ圧縮手法を上回る結果が得られました。RAGは長期的なコンテキスト検索に有効ですが、検索失敗時の精度低下や検索レイテンシが課題です。KVキャッシュ圧縮はリアルタイム処理には向くものの、圧縮時に失われる情報が精度を制限します。δ-memはメモリ全体を8×8の行列に「学習しながら」圧縮するため、単純な圧縮より重要情報を保持しやすく、かつ外部データベースを必要としません。
また一般的な能力(数学推論やコード生成など)への影響が最小限である点も確認されており、長期記憶能力を付加しても既存の汎用性がほぼ損なわれないことが示されました。LLMエージェントの推論能力を高めるAutoTTSのようなアプローチと組み合わせることで、より複雑な長期タスクへの対応も期待されます。
まとめと今後の展望
δ-memは「凍結バックボーン」「固定サイズ行列」「Delta則」という三つのシンプルな設計原則によって、LLMの長期記憶問題を低コストで解決しようとする提案です。8×8という極めて小さなパラメータ追加で実用的な改善が得られる点は、実装コストを重視するプロダクト開発者にとって魅力的でしょう。
HuggingFaceへの即日公開(declare-lab/delta-mem_qwen3_4b-instruct)により再現性も高く、今後はさらに大きなモデルへの適用や、複数記憶モジュールの並列配置といった拡張が研究の焦点になりそうです。長期対話エージェントや継続学習システムへの応用が進めば、AIが「本当に記憶を持つ」時代に向けた一歩となる成果です。


