 AI-Papers
- 従来の加重和法では特定報酬に特化したサンプルが他報酬の学習シグナルを希薄化させる「スペシャリストサンプル問題」をMARBLEが解決
- 各報酬を独立したアドバンテージ推定で管理し、二次計画法による勾配ハーモナイゼーションで5つの報酬を同時に向上させる
- Stable Diffusion 3.5 Mediumで学習コスト0.97倍を維持しつつ全5報酬で改善達成、GitHubでコードが公開済み
研究の背景
テキストから画像を生成する拡散モデルの品質向上において、強化学習(RL)によるファインチューニングは近年広く研究されています。人間の好みを反映したスコアや、テキストとの整合性を測る指標などの「報酬モデル」からフィードバックを与えながらモデルを微調整する手法です。
FlowGRPOやDiffusion NFTといった先行研究では、単一の報酬を最大化することには成功しています。しかし実用的なシステムでは、美的品質・テキスト描画の精度・構図理解・安全性など複数の要件を同時に満たさなければなりません。この「マルチ報酬の同時最適化」という難題に正面から向き合ったのが、本論文で提案されるMARBLE(Multi-Aspect Reward BaLancE)です。
加重和法の根本的な問題
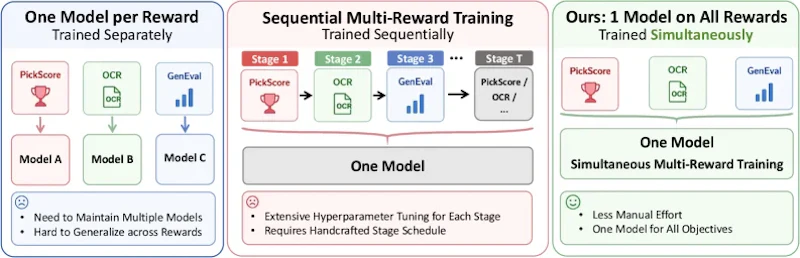
マルチ報酬を扱う最もシンプルな方法が「加重和スカラー化」です。各報酬 Rk に重み wk を掛けて合算した R(x) = Σk wk Rk(x) を最大化するように学習します。ハイパーパラメータ調整さえできれば手軽に実装できる一方、MARBLEの論文はこのアプローチに本質的な欠陥があると指摘します。
問題の核心は「スペシャリストサンプル」にあります。生成されたサンプルのほとんどは、特定の報酬では高評価を得ても他の報酬への関与はほぼゼロです。OCR(文字描画品質)が高いサンプルは文字を含むプロンプトから生成されるため、構図の複雑さを評価するGenEvalとは無関係になりがちです。
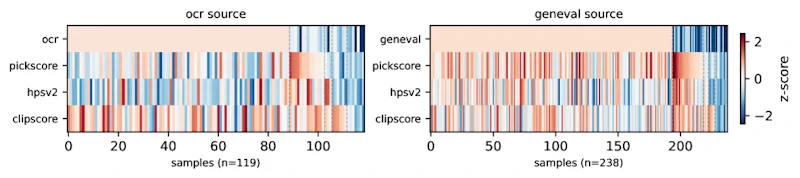
このようなスペシャリストサンプルを加重和で集約すると、高いOCRスコアを持つサンプルに対してGenEvalの学習シグナルはほぼゼロになり、互いの報酬が相手の学習を希薄化し合います。実験によると、加重和の勾配はミニバッチの80%で少なくとも1つの報酬と逆方向に向いており、一方を改善しようとすると他方が悪化するという競合が頻発していることが確認されています。
MARBLEの仕組み
MARBLEはこの問題を、報酬空間ではなく勾配空間で解決します。各報酬 k に対して独立したアドバンテージ(ベースライン補正された報酬)推定器を維持し、報酬ごとのポリシー勾配 gk を個別に計算します。その後、二次計画法(QP)を使い、全ての勾配ベクトルの凸包における最小ノルム点を求めます。これにより、全報酬と正の内積を持つ更新方向 d が導かれます。
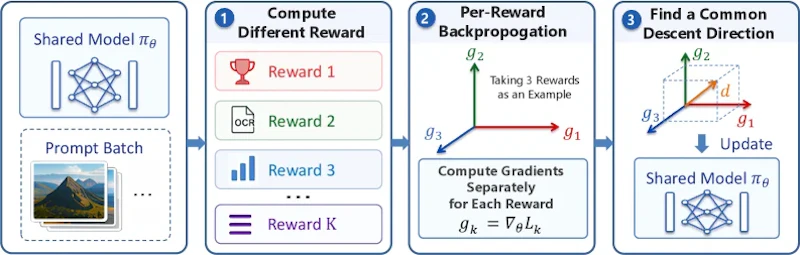
直感的には「全ての報酬に対して少なくとも悪化しない」更新方向を数学的に保証しながらモデルを改善する、という動作です。どれかの報酬を犠牲にしなければならない場合は、その損失が最小になるようにバランス係数 αk を自動調整します。
計算効率の面でも重要な工夫があります。ナイーブな実装では報酬の数 K に比例してバックワードパスが増えますが、MARBLEはDiffusion NFT損失のアフィン構造を利用した「償却(amortization)」により、計算量を事実上1回のバックワードパスと同等に削減しています。さらにEMA(指数移動平均、減衰係数 ρ=0.7)でバランス係数を平滑化することで、一時的に弱いミニバッチが特定の報酬を不当に抑制することを防いでいます。
類似の多目的最適化研究として、PRISMはMoEと対抗学習でマルチモーダルRLの分布ドリフトを解消しますが、MARBLEは複数報酬の勾配を直接調和させるという独自のアプローチをとります。
実験と結果
評価はStable Diffusion 3.5 Mediumをベースモデルとして行われました。HPSv2(人間の選好スコア)、GenEval(構図・属性理解)、OCR(テキスト描画品質)を含む5つの報酬を対象に、3種類のベースラインと比較されています。
手法 | 全報酬同時改善 | 手動チューニング | 学習コスト |
|---|---|---|---|
シングル報酬スペシャリスト(×5モデル) | 不可 | 少 | K倍 |
逐次学習(DiffusionNFT) | 可(手動スケジュール依存) | 大 | 大 |
加重和同時学習 | 一部不可 | 中 | 基準 |
MARBLE(提案手法) | 全5報酬で改善 | 最小 | 0.97倍 |
MARBLEは5つの報酬をすべて同時に向上させ、「総合スコア」で全ベースラインを上回りました。加重和法で80%のミニバッチに発生していた逆方向の勾配は、MARBLEでは一貫して正方向に保たれています。学習コストはベースライン比0.97倍とほぼ変わらず、手動のカリキュラム設計も不要です。
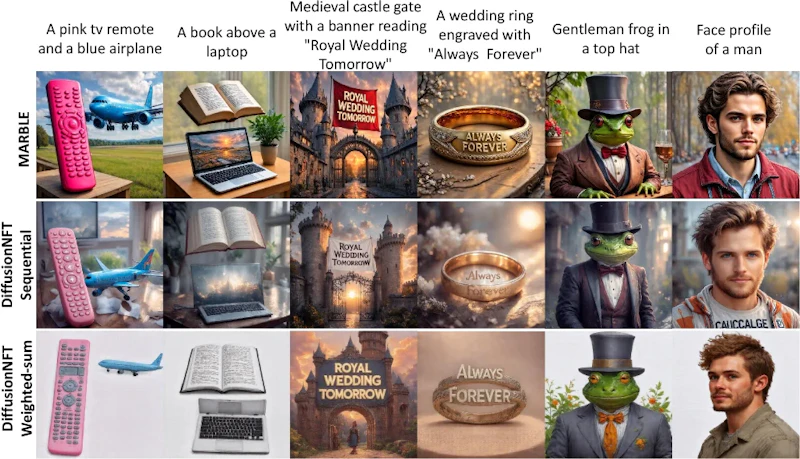
定性的な評価でも、MARBLEが生成した画像は「テキストが正確に描画され、かつ構図や属性の理解も正確」という複合的な品質を示しており、単一報酬モデルでは実現しにくい幅広い品質向上が確認されています。人間による選好評価においても、広範な報酬をカバーするMARBLEの出力が単一指標に特化したモデルより好まれる傾向が示されました。
まとめ
MARBLEは拡散モデルのRL微調整における「複数報酬の同時最適化」という実用上重要な課題に対し、勾配ハーモナイゼーションという明確な数理的解法を提示しました。スペシャリストサンプル問題の分析、二次計画法による勾配調和、償却によるコスト削減という3つの技術的貢献は、今後の多目的最適化研究に広く応用できる知見です。
課題として、報酬間の競合が非常に強い場合の挙動や、報酬モデル自体の品質・偏りへの依存性は引き続き検討が必要です。それでも、手動のスケジュール設計なしに全報酬を同時改善でき、学習コストをほぼ維持できる点は産業応用における実用的な価値を持ちます。コードはGitHubで公開されており、再現性も十分に確保されています。
論文情報: "MARBLE: Multi-Aspect Reward Balance for Diffusion RL"(Canyu Zhao et al., 2026) arXiv:2605.06507
本記事の図(図1〜図4)は解説のため上記論文より引用しています。


