 AI-Papers
- Transformer・Mamba等52のアーキテクチャを情報理論で解析し、長文脈モデルが効率性・コンパクト性・想起能力の3条件を同時に満たせないことを数学的に証明した
- 効率性とコンパクト性を両立するSSM・線形RNNは、系列長に比例した履歴想起が原理的に不可能であることがデータ処理不等式とファノの不等式から導かれる
- ハイブリッドアーキテクチャは三角形の内部に位置し、注意層の比率を増やすほど想起能力は高まるが効率性とコンパクト性は低下するトレードオフが定量的に示された
研究の背景
ChatGPTやClaudeをはじめとする大規模言語モデル(LLM)は、扱える文脈の長さを急速に拡大してきました。100万トークンを超える文脈窓を持つモデルも登場し、長文書の一括処理や長期的な対話が実用レベルに近づきつつあります。
こうした長文脈対応には2つの主流アプローチがあります。Transformerは過去すべてのトークンを「KVキャッシュ」として保持するため情報の正確な想起が得意ですが、系列が長くなるほど計算コストとメモリが線形に増大します。一方、Mamba等の状態空間モデル(SSM: State Space Model)や線形RNN(Recurrent Neural Network)は、過去の情報を固定サイズの内部状態に圧縮して保持することで計算効率を維持しますが、そのぶん情報の圧縮による損失が避けられません。
この直感的なトレードオフは長年「どのアーキテクチャを選ぶかの問題」として語られてきました。しかし、その限界が情報理論によって厳密に証明されたことはありませんでした。2026年5月に公開された本論文は、この根本的な問いに情報理論という強力な道具を使って正面から答えを出した研究です。
3つの条件と不可能性定理
論文は長文脈モデルが備えるべき性質として、以下の3つを定義しています。
- 効率性(Efficiency): 1ステップあたりの計算量が系列長に依存しないこと
- コンパクト性(Compactness): モデルの内部状態サイズが系列長に依存しないこと
- 想起能力(Recall): 系列長 T に比例する数の過去の情報を正確に取り出せること
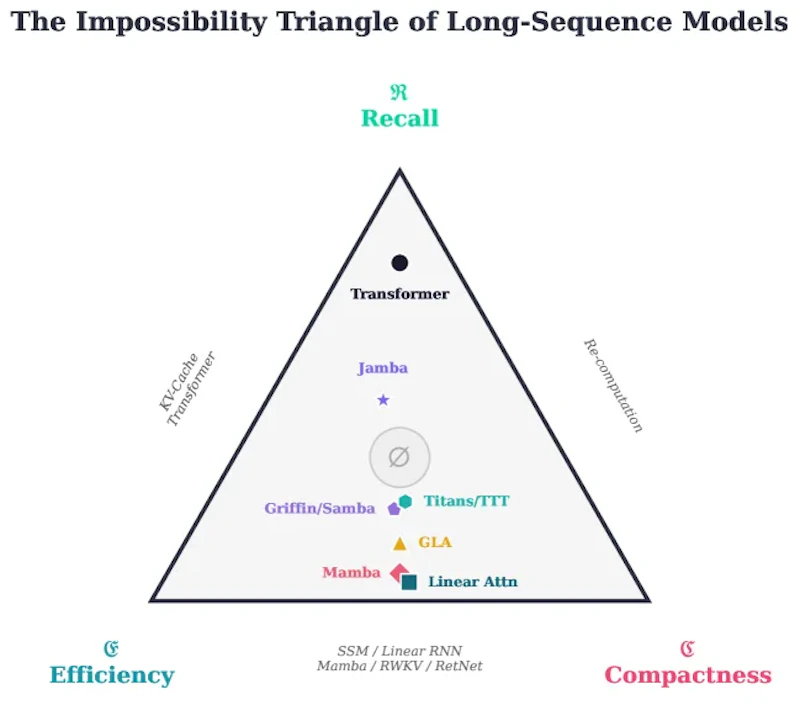
そして、この3つを同時に満たすアーキテクチャは原理的に存在しないことを証明します。これが「不可能性三角形(Impossibility Triangle)」と呼ばれるフレームワークの核心です。三角形の各頂点が1つの条件を表し、既存のあらゆるアーキテクチャはこの三角形の辺または内部にしか位置できないことが示されます。
情報理論的証明の仕組み
核心となる定理10は、「効率性とコンパクト性を同時に満たすモデルが想起できるキー・バリューペアの数は、モデル次元 d と語彙サイズ V に依存する定数で上界される」という内容です。系列長 T がいくら大きくなっても想起能力は T に依存せず一定の上限に張り付いてしまうため、想起能力の条件(T に比例すること)は決して満たせません。
証明には2つの道具が用いられます。まずデータ処理不等式(情報はデータを変換するたびに失われるか同じに留まるという原理)により、固定サイズの状態を通過した後に保持できる情報量の上限を定めます。次にファノの不等式(推定誤差と情報量の関係を結ぶ定理)を用いて、その情報量の上限から想起可能なキー・バリューペア数の上限を導出します。
この証明は特定のモデル実装に依存しない一般論です。いかに巧みな学習や工夫を施しても、効率性とコンパクト性の両方を保つ限りこの壁は越えられません。
52のアーキテクチャの分類
論文はこのフレームワークをTransformer、SSM、線形RNNを含む52のアーキテクチャに適用し、三角形上での位置を整理しています。
- KVキャッシュ型Transformer: 想起能力頂点に位置。状態が系列長に比例して増大するためコンパクト性を欠く
- SSM(Mamba等)・線形RNN: 効率性とコンパクト性の辺付近に集まる。固定状態で高速だが系列長比例の想起は不可能
- ハイブリッドアーキテクチャ(Attention層とSSM層の混合): 三角形の内部に位置し、Attention層の比率に応じて3頂点の間で連続的にトレードオフを変化させる
Attentionを線形時間で近似しようとする研究が注目を集めるなか、本論文はそのような手法が本質的に想起能力の低下というコストを支払っていることを理論的に裏付けています。効率性の向上は常に想起能力とのトレードオフであり、どちらかを得るにはもう一方を諦める必要があります。
実験による検証
理論予測を確かめるため、論文は合成的な連想想起タスク(Associative Recall)を用いた実験を行っています。このタスクはモデルに n 個のキー・バリューペアを与え、後からキーを提示してバリューを正確に答えさせるシンプルな設計で、想起能力を直接測定できます。
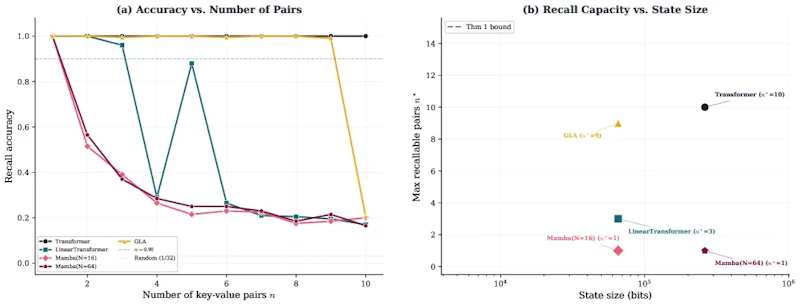
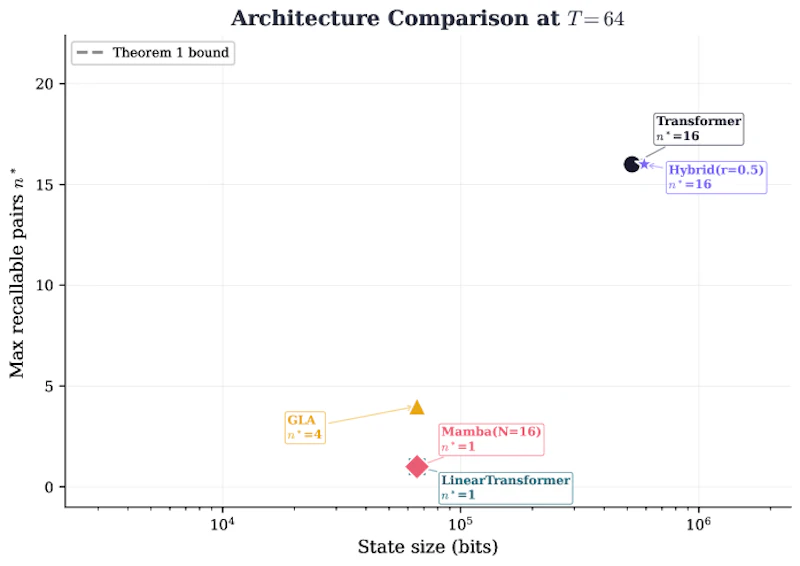
実験1では系列長を固定してキー・バリューペア数 n を増やしたとき、Transformerは全域で高い精度を保つ一方、Mamba・GLA・線形Transformerなどの固定状態モデルは n の増加とともに精度が低下しました。さらに、実証された最大想起数 n* は常に定理10の情報理論的上界を下回ることも確認されています。
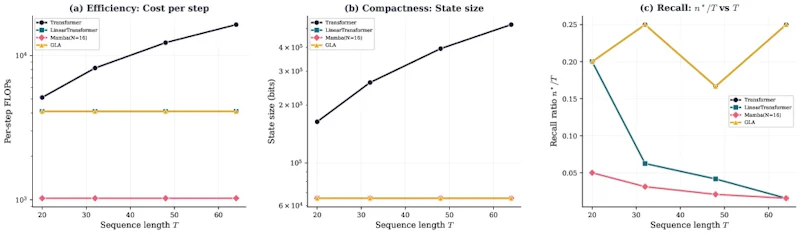
系列長 T を変化させた実験では、Transformerが安定した想起比率を維持する一方、固定状態モデルでは r = n*/T が 0 に収束していきます。これは定理10の予測と完全に整合する結果であり、系列が長くなるほど固定状態モデルの有効な想起能力が相対的に劣化することを示しています。また、ハイブリッドアーキテクチャについては注意層の比率(r_attn)が高いほど想起能力は向上するものの、FLOPsと状態サイズも比例して増大することが定量的に確認されました。
なお、実用モデルは理論的上界の0.1%未満しか活用できていないことも判明しています。これは現在のモデルがKVストレージ以外の目的でも状態を利用しているためであり、理論上界と実測値の間には大きな余白があることを示しています。
まとめと今後の展望
本研究は、長文脈モデルの設計に課される根本的な制約を情報理論によって初めて厳密に証明しました。効率性・コンパクト性・想起能力の3条件は同時に成立しえず、アーキテクチャの選択はこのトレードオフの中での最適点探索であることが明確になりました。
実用上の含意として、Mamba等のSSMを長文脈タスクに使う場合は想起能力の限界を念頭に置く必要があります。KVキャッシュ型Transformerは想起能力を最大化できますが、系列長に比例したコストは回避できません。ハイブリッドアーキテクチャはその中間に位置しており、Attention層の比率によって想起能力と効率性を連続的に調整できることが実験でも示されました。
今後の研究課題として、状態の利用効率の向上(現在は理論上界の0.1%未満)や、特定のタスク要件に応じた最適なハイブリッド構成の自動設計などが挙げられます。あらゆる長文脈LLMアーキテクチャに根本的な制約を課す基礎研究として、今後の設計指針に広く参照されることになるでしょう。
論文情報: "The Impossibility Triangle of Long-Context Modeling"(Yan Zhou, 2026) arXiv:2605.05066
本記事の図(図1、図2、図3、図6)は解説のため上記論文より引用しています。


