 AI-Papers
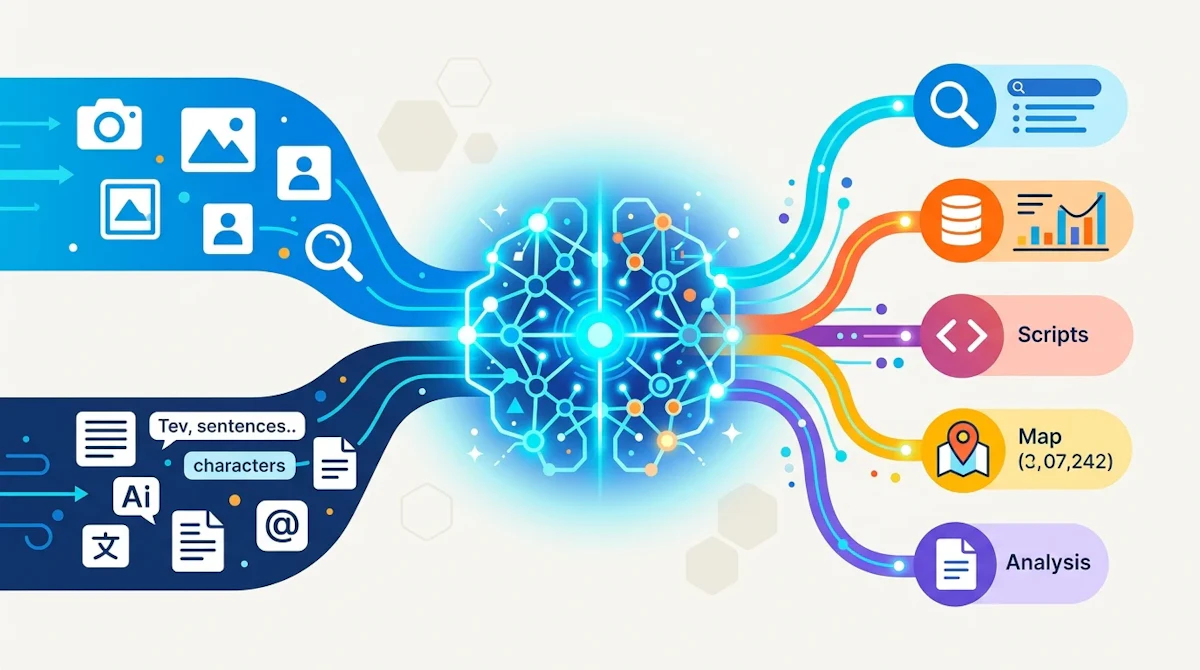
- WikipediaのハイパーリンクグラフからVQAを自動生成し、視覚グラウンディングと曖昧化書き換えで36,592件の訓練軌跡を構築
- テキスト検索・画像検索・OCR・クロッピングを含む7種類のツール実環境で、多ターン深層検索エージェントを訓練するアーキテクチャを設計
- 致命的意識GRPOにより7ベンチマーク平均10ポイント超の改善を達成し、複数タスクで商用モデルと同等性能を実現
研究の背景と課題
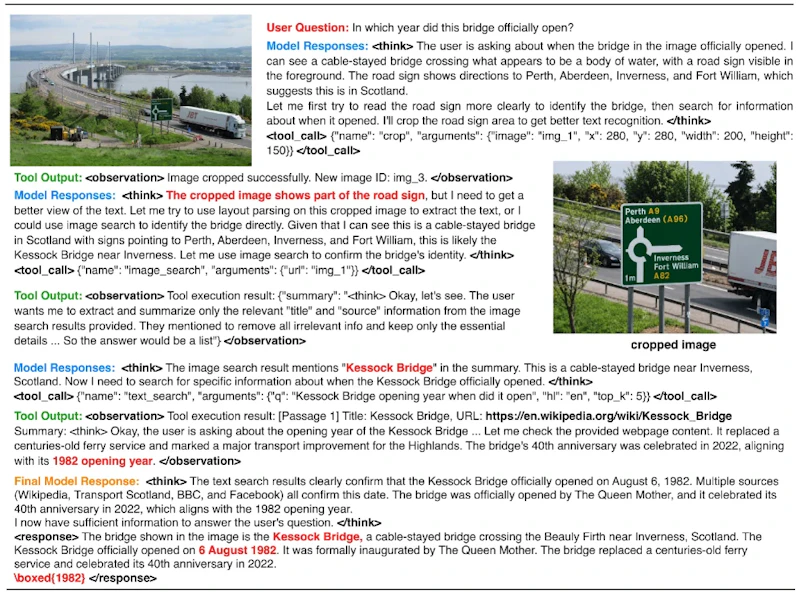
テキストと画像が絡み合う複雑な質問に答えるには、単純な検索では不十分です。「この橋が開通した年は?」という問いに対して、まず画像を目視し、道路標識を拡大し、画像検索で橋の名称を特定し、最後にテキスト検索で開通日を確認するような多段階の推論が求められます。こうした知識集約型のビジュアル質問応答(VQA)を処理するエージェント研究が近年活発化しています。
しかし、既存のマルチモーダル深層検索エージェントは商用クローズドモデルが中心で、訓練データや学習手法の詳細が公開されていませんでした。再現性の欠如が研究コミュニティの発展を妨げる状況が続いていたのです。Tencent Hunyuanチームが発表したOpenSearch-VLは、データパイプライン・ツール環境・訓練アルゴリズムのすべてを完全公開した初のオープンソース実装です。
7種のツールを統合した実環境
OpenSearch-VLの核心の一つは、多様な知覚と知識取得を可能にするツール環境の設計です。7種類のツールが一つの環境に統合されています。
- 検索ツール: テキスト検索・画像検索
- 画像強化ツール: シャープニング・超解像・遠近法補正
- 解析ツール: クロッピング・OCR(光学文字認識)
モデルはこれらのツールを自律的に組み合わせながら多ターンの推論を行います。単一のツール呼び出しで解決できない問題に対しても、視覚的な証拠を収集しながら段階的に答えへと迫ることが可能です。
データ構築パイプライン
高品質な訓練データの整備もOpenSearch-VLの重要な貢献です。パイプラインは3段階で構成されています。
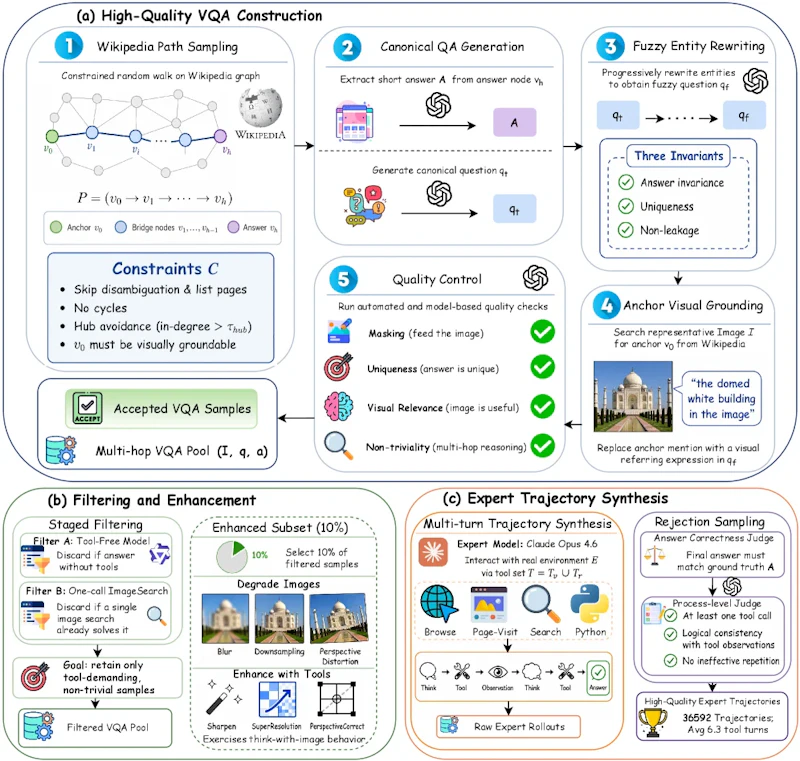
まず、英語WikipediaのハイパーリンクグラフからVQAを自動生成します。長さ2〜4の制約付きランダムウォークでパスをサンプリングし、パスの起点(アンカーエンティティ)に代表画像を付与する「視覚グラウンディング」を行います。これにより、画像を手がかりに複数のホップを経なければ答えられない質問が生成されます。
次に、エンティティ名を「画像内の人物」「この場所」のような説明的表現に書き換える「曖昧化処理」を適用します。エンティティ名を直接検索するだけで解ける単純な問題が排除され、モデルが真に多ツールを駆使しなければ解けないデータのみが残ります。アブレーション実験では、視覚グラウンディングを除くと-11.5ポイント、曖昧化書き換えを除くと-10.3ポイントの性能低下が確認されており、各工程の貢献の大きさが示されています。
最終的にSFT(教師あり微調整)用に36,592件、RL(強化学習)用に8,000件の高品質軌跡データセットが整備されました。平均ターン数はSFT軌跡で6.3ターンに及び、複雑な多ホップ推論の実態を反映しています。
致命的意識GRPO訓練
多ターンのツール使用には、ツール呼び出しが連続して失敗する「致命的エラー」という特有の問題があります。3回連続でツールが失敗すると、それ以降の推論はすべて無意味になります。従来のGRPO(Group Relative Policy Optimization、グループ相対方策最適化)では、こうした致命的エラー後の不良トークンにも勾配が流れ込み、訓練を不安定にしていました。
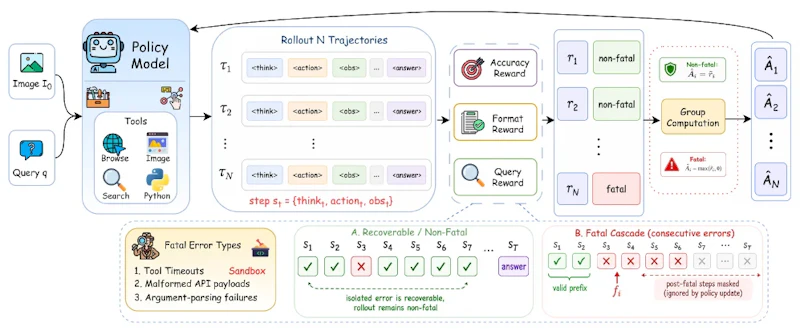
OpenSearch-VLが提案する致命的意識GRPO(Fatal-Aware GRPO)は、3回連続のツール失敗が発生した時点を「致命的ステップ」と定義し、その後のトークンをすべてマスクします。さらに「片側クランピング(One-Sided Clamping)」により、致命的エラーが発生する前の有益な推論ステップには正の勾配を維持しつつ、失敗後の不良ステップの影響を遮断します。
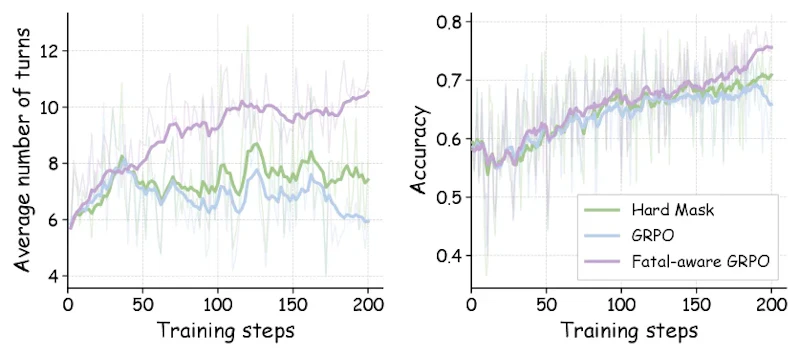
この手法の効果は定量的に示されています。ベースSFTモデルの64.6ポイントに対し、通常のVanilla GRPOでは67.6(+3.0)、ハードマスキングでは67.7(+3.1)にとどまる一方、致命的意識GRPOは71.8(+7.2)を達成しました。
実験結果
7つの知識集約型ベンチマーク(SimpleVQA、VDR、MMSearch、LiveVQA、BrowseComp-VL、FVQA、InfoSeek)での評価結果は、提案手法の有効性を明確に示しています。OpenSearch-VL-8Bはベースモデル比で大幅な性能向上を達成し、同規模の既存エージェントSenseNova-MARSを3.9ポイント上回りました。
OpenSearch-VL-32Bは平均63.7ポイントで、GPT-4oやGemini 1.5 Proといった商用モデルと同等の水準に達しています。特にMMSearchでは+24.5ポイント、InfoSeekでは+16.2ポイントという顕著な改善が確認されました。SFTのみで高い性能を実現したOpenSeeker-v2と比べても、RLによるさらなる改善幅の大きさが際立ちます。
まとめと今後の展望
OpenSearch-VLは、マルチモーダル深層検索エージェントの訓練に必要な要素をすべて公開した初の取り組みです。WikipediaグラフからのVQA自動生成、7ツール統合環境、致命的意識GRPOという三つの要素が有機的に連携し、商用モデルと競合する性能を実現しています。
致命的意識GRPOのアルゴリズム的な貢献は特に大きく、多ターンRL訓練における致命的エラーへの対処という課題に対して実効性の高い解決策を示しています。データ・コード・モデルウェイトの完全公開が予定されており、研究コミュニティがこの訓練レシピを基盤にさらなる発展を積み重ねることが期待されます。一方で、現在のツールセットは7種類に限定されており、より多様なツール統合や長期的な記憶管理への対応は今後の課題として残ります。
論文情報: "OpenSearch-VL: An Open Recipe for Frontier Multimodal Search Agents"(Shuang Chen et al., 2026) arXiv:2605.05185
本記事の図(図1、図2、図3、図9)は解説のため上記論文より引用しています。


