 AI-Papers
- メール送信先や送金先といった「行動の宛先」の出自を決定論的に検査し、読み取り専用ツールの型付きフィールド由来だけを許可する防御設計
- AgentDojo の12セル平均で定型インジェクションによる宛先改変を0件に抑え、強化学習型の攻撃者に対しても攻撃成功率0.005を記録
- 追加のモデル呼び出しは1エピソードあたり0.19〜0.39回で、既存防御の3.25〜9.91回より大幅に少ない
研究の背景
メールの送信、ファイルの共有、支払いの実行といった操作を任されたAIエージェントは、Webページや共有ドキュメントに仕込まれた指示文を読み込んだ瞬間に乗っ取られる危険があります。攻撃者の狙いは明確で、情報や金銭を自分の宛先へ向けさせることです。これが間接プロンプトインジェクション(外部データ経由で指示を注入する攻撃)と呼ばれる問題です。
既存の実行時防御には大きく2つの流派があります。1つは言語モデル自身に「この行動を許可してよいか」を判定させる方式ですが、判定するモデルが攻撃者のテキストを読んでしまうため、安全性の根拠がモデルの気まぐれに依存します。しかも判定のたびに追加のモデル呼び出しが発生し、拒否されるとバックボーンの再実行が必要になることもあります。
もう1つは出自(provenance)を追跡する方式で、モデル判定への依存を避けられる一方、タスクごとに計画やルーティングを立てるためのモデルが前提となっていました。SAINT Machines と KAIST、中央大学校の研究チームが提案した SPILLWAY は、どちらにも頼らない下限的な防御層を目指しています。arXiv に公開された論文は、NeurIPS 2026 のワークショップ「Agents in the Wild: Safety, Security, and Beyond」に採択された版を拡張したものです。
提案手法
SPILLWAY の出発点は、ツールの返り値の「型」に着目した観察です。メールの送信者アドレスや支払い先の口座番号は、ツールが型付きフィールドとして返します。対して注入された指示は、本文や説明文といった自由テキストの中に現れます。つまり宛先として正当な値は構造化された場所から来るはずで、自由テキストから湧いて出た宛先は疑わしいという切り分けが可能になります。Function Calling(ツール呼び出し)とは?仕組み・構造化出力・実装の落とし穴を解説で整理されているような構造化出力の枠組みが、そのまま防御の足場になるわけです。
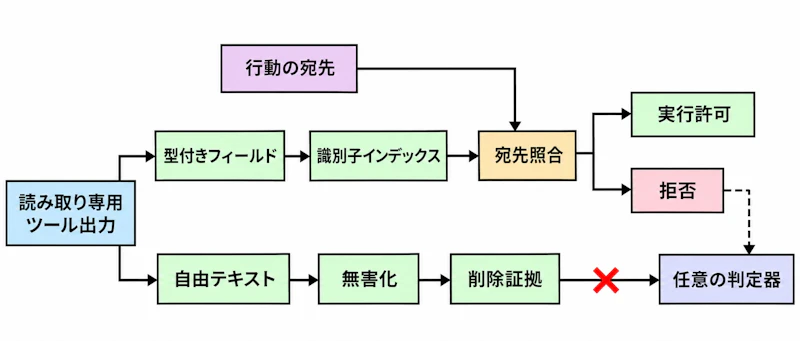
処理は4段階に分かれます。まず読み取り専用ツールの返り値のうち、メールアドレス、URI、受信者、チャンネルといった型付きフィールドだけを識別子インデックスに登録します。本文や説明文は決して登録されません。次に決定論的な無害化処理が、偽装されたチャット発話、既知のインジェクション定型文、エージェント宛てに書かれた文章、文中で指示されたツール呼び出しを固定ルールで削り落とし、削除した範囲を証拠として保持します。
そして実際の呼び出しごとに、宛先の照合を行います。ユーザーの指示に含まれずツール出力に現れた宛先値は、識別子インデックスに存在し、かつ自由テキスト側で繰り返されていない場合に限って許可されます。固定の委譲ルールが覆う場合も許可されますが、権限付与や削除にはより厳しい条件が課されます。この判定は集合の照合だけで済み、モデル呼び出しは不要です。
最後に、既定では無効化されている局所的な判定器が、拒否された呼び出しを復活させる余地を残しています。ただし宛先が無害化で削除された範囲に含まれていた場合は復活できず、権限付与の拒否は判定器に回されません。図1のように、型付きフィールドと自由テキストの経路を分離したうえで、削除証拠が判定器の救済を塞ぐ構造になっています。
実験結果
評価には AgentDojo v1.2.2 の4スイート(Banking、Slack、Travel、Workspace)が使われ、バックボーンには gpt-4o-mini、qwen3-coder:30b、qwen3:8b の3種が選ばれています。さらに AgentDyn の3スイート(GitHub、DailyLife、Shopping)と、ChatInject、AutoDojo、PISmith といった強い攻撃手法でも検証されました。比較対象は MELON、Progent、DRIFT、ROPE、Spotlighting、DeBERTa ベースの検出器、そして無防備なエージェントです。
定型インジェクション下の12セル平均が下表です。対象内ASR(攻撃成功率)と、漏洩が起きたセル数に注目してください。
手法 | 通常時の有用性 | 攻撃下の有用性 | 対象内ASR | ERS | 漏洩セル |
|---|---|---|---|---|---|
無防備 | .540 | .417 | .305 | .608 | 12/12 |
SPILLWAY | .539 | .489 | .000 | .700 | 0/12 |
DRIFT | .460 | .453 | .016 | .627 | 7/12 |
MELON | .526 | .314 | .094 | .666 | 10/12 |
Progent | .437 | .371 | .031 | .602 | 11/12 |
ROPE | .395 | .345 | .005 | .566 | 3/12 |
Spotlighting | .528 | .403 | .283 | .608 | 12/12 |
検出器 | .332 | .230 | .060 | .491 | 10/12 |
定型インジェクションによる宛先の改変は1件も成立せず、偽装チャットテンプレートによる攻撃(ChatInject)でも成功率は0でした。公開済みの強化学習型攻撃者に対しては平均0.005にとどまり、同条件で比較した防御の中で有用性と複合指標(NRP、ERS)がいずれも最高値となっています。無防備なエージェントと比べて通常時の有用性がほとんど落ちていない点も、過剰な拒否が起きていないことを示します。
実行コストの差も明確です。qwen3:8b の Workspace と Slack の正常系エピソードでは、追加のモデル呼び出しが0.19回と0.39回で済みました。MELON、Progent、DRIFT は3.25〜9.91回の追加が必要で、追加時間も SPILLWAY が0.5秒以内に対し1.6〜10.5秒と開いています。防御の発動によるバックボーンの再実行も発生しません。
まとめと今後の展望
SPILLWAY の価値は、モデルの判断力に頼らずに「宛先の出自」という一点を機械的に守る割り切りにあります。コードは GitHub で、SDK は PyPI の spillway-guard 1.0.0 として公開されており、observe_tool_return、check_call、observe_refusal という3つのメソッドで既存エージェントに組み込めます。拒否時にはユーザー指示側の値で再試行するよう促す設計で、導入障壁は低く抑えられています。
一方で限界もあります。この防御が守るのは行動の宛先であり、宛先が正しいまま送信内容に機微情報が混ざるような漏洩や、ツール自体の型設計が甘い環境には別の対策が必要です。無害化は固定ルールに依存するため、ルールの想定外の表現で指示を忍ばせる攻撃には原理的な余地が残ります。プロジェクトページも SPILLWAY の数値は 1.0.0 での実測で比較手法は論文掲載値だと注記しており、横並びの比較は慎重に読むのが妥当でしょう。
とはいえ、決定論的に守れる範囲を明示し、その上にモデルベースの防御を重ねるという層構造の考え方は、ツール使用エージェントの安全設計で現実的な指針になります。送金やメール送信を任せるシステムを作る開発者にとって、まず試す価値のある下限です。
論文情報: "SPILLWAY: Separating Target Admission from Sanitization to Defend Tool-Using Agents against Prompt Injection"(Woosang Lim, Yeseul Chang, Jaewoo Lee, 2026) arXiv:2611.07222


