AI-Papers
- Function Calling はモデルに関数を実行させる機能ではなく、「どの関数をどの引数で呼ぶか」という構造化された依頼を返す機能です
- strict モードは制約付きデコーディングで動くため、スキーマの書き方に required 全列挙や additionalProperties: false といった固有の制約があります
- 並列呼び出し、ツール定義のトークンコスト、拒否応答の扱いが実装でつまずきやすく、MCP はこの土台の上に乗る標準化層です
Function Callingとは
Function Calling(ツール呼び出し)とは、Large Language Model(LLM)に「使える関数の一覧」を渡しておき、必要になったときにモデル側から「この関数をこの引数で呼んでほしい」という依頼を構造化された形で返してもらう仕組みです。天気を聞かれたら get_weather({"location": "Tokyo"}) という呼び出しを返す、といった動きになります。
ここで最初に押さえておきたいのは、モデル自身は関数を実行しないという点です。モデルが返すのは関数名と引数の組だけで、実際に API を叩いたりデータベースを引いたりするのはアプリケーション側のコードです。OpenAI の Responses API でも Claude の Messages API でも、設計の前提はここが共通しています。
なぜこれが必要なのでしょうか。LLM は学習データの中にある知識しか持たず、今の在庫数も、ログイン中のユーザーの注文履歴も知りません。自然言語で「〜を調べて」と書かせるだけでは、アプリ側がその意図をパースできません。関数名と型付きの引数という形に落とし込むことで、言語モデルの出力をそのままプログラムの入力として扱えるようになります。
5ステップで動く仕組み
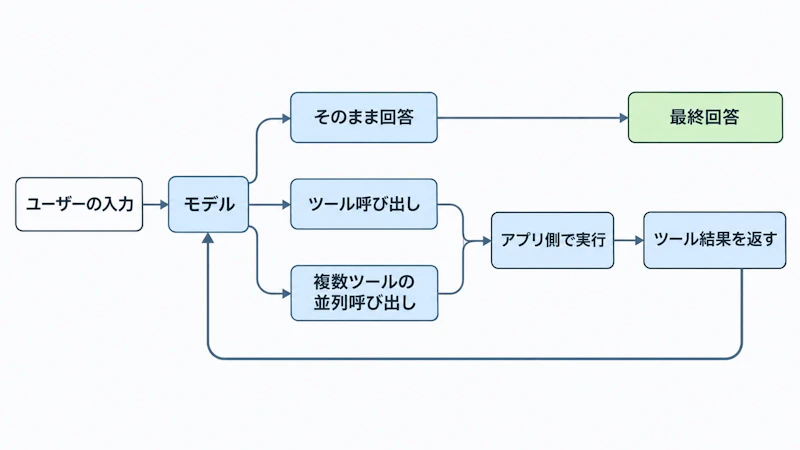
基本的な流れは5つのステップに分かれます。OpenAI のガイドもこの5段階で説明しています。
- 使えるツールの定義を添えてリクエストを送る
- モデルがツール呼び出し(関数名と引数)を返す
- アプリケーション側で実際の関数を実行する
- 実行結果を
call_idに紐付けて2回目のリクエストで送り返す - 最終的な回答、あるいは次のツール呼び出しを受け取る
重要なのは、この流れが1往復で終わる保証はないところです。モデルは結果を見てさらに別のツールを呼ぶことがあり、ループは何周でも回ります。図1のように、モデルの出力は「そのまま回答」「ツールを1つ呼ぶ」「複数を並列で呼ぶ」の3方向に分岐し、ツールを呼んだ場合だけモデルに戻ってくる構造になっています。
推論モデル(reasoning models)を使う場合は追加の作法があります。ツール呼び出しと一緒に返ってきた reasoning アイテムを、ツールの実行結果と並べてそのまま送り返す必要があります。ここを落とすと思考の連続性が切れ、精度が落ちます。
ツール定義の書き方
ツールの定義は、名前、説明、そして JSON Schema で書いた引数の形から成ります。OpenAI では parameters、Claude では input_schema というフィールド名になりますが、中身は同じ JSON Schema です。
{
  "type": "function",
  "name": "search_orders",
  "description": "顧客の注文履歴を検索する。在庫照会には使わないこと。",
  "strict": true,
  "parameters": {
    "type": "object",
    "properties": {
      "customer_id": { "type": "string" },
      "status": {
        "type": ["string", "null"],
        "enum": ["pending", "shipped", "cancelled", null]
      }
    },
    "required": ["customer_id", "status"],
    "additionalProperties": false
  }
}
説明文の書き方で精度が大きく変わります。OpenAI のガイドは「インターンテスト」という基準を挙げています。モデルに見えている情報だけで、新人が迷わずその関数を使えるか、という問いです。使うべき場面だけでなく使ってはいけない場面も書くのがコツで、上の例の「在庫照会には使わないこと」がそれに当たります。
もう一つの指針は、取り得ない状態をスキーマで排除することです。自由文の status を許すより enum にしてしまえば、存在しないステータスを渡される余地がなくなります。逆に、アプリ側が既に知っている値(ログイン中のユーザー ID など)をモデルに埋めさせるのは避けるべきです。推測で間違った ID を入れられるリスクしかありません。
strictモードの原理
strict: true を付けると、返ってくる引数がスキーマに必ず従うようになります。これはプロンプトでお願いしているのではなく、制約付きデコーディングという生成時の制御で実現されています。
仕組みはこうです。まず JSON Schema を文法(grammar)にコンパイルします。トークンを1つ生成するたびに、「ここまで出力した文字列の続きとして、文法上あり得るトークンはどれか」を計算し、あり得ないトークンの確率を潰します。モデルがどれだけ変な方向に行きたがっても、不正なトークンは選択肢から消えているので構文を外せません。
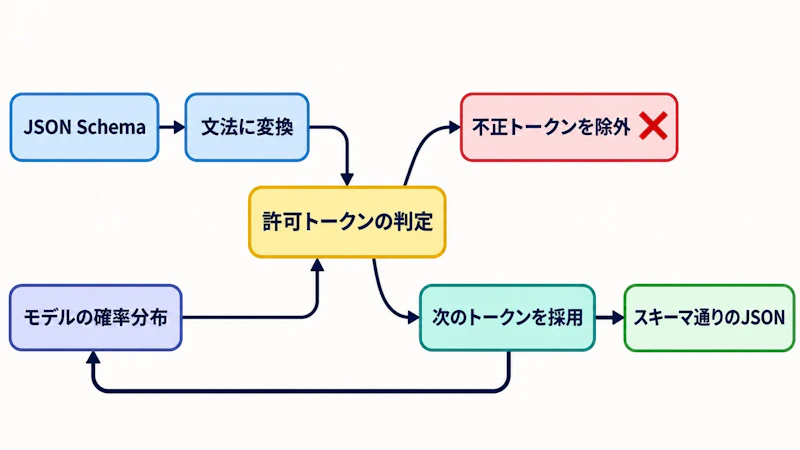
OpenAI は custom tool の文法制約に LLGuidance というライブラリを使っていることを公開しています。LLGuidance は語彙の prefix tree(トライ木)をたどって「今許されるトークンの集合」をマスクとして計算し、12.8万語彙のトークナイザでも1トークンあたり約50マイクロ秒のシングルコア時間で済むと報告しています。推論速度への影響をほぼ無視できる水準に抑えているわけです。なお、こうした制約付きデコーディングは LLM推論エンジン比較2026、vLLM・SGLang・TensorRT-LLMの違いと選び方で触れたオープンソースの推論エンジン側にも実装されており、自前ホスティングでも同じ発想が使えます。
原理が文法である以上、書けるスキーマには制限が付きます。strict モードで必ず守らなければならないのは次の2点です。
- すべてのオブジェクトに
additionalProperties: falseを指定する - すべてのプロパティを
requiredに列挙する
「必須ではない項目」をどう表すのか、と戸惑うところですが、答えは型に null を足すことです。"type": ["string", "null"] と書いて required に入れる、という書き方になります。JSON Schema の慣習とは逆なので、既存のスキーマを流用すると最初につまずきます。
構造化出力との違い
Function Calling と並んで語られるのが Structured Outputs(構造化出力)です。どちらも JSON Schema を使うので混同されやすいのですが、目的が違います。
項目 | Function Calling | Structured Outputs | JSON mode |
|---|---|---|---|
目的 | アプリの関数を呼ばせる | ユーザーへの返答を型付けする | JSON 形式で返させる |
指定場所 |
|
| レスポンス形式の指定 |
スキーマ準拠 | strict 有効時は保証 | strict 有効時は保証 | 構文のみ、スキーマは非保証 |
典型用途 | DB 検索、API 連携、エージェント | 抽出、分類、UI 向け JSON | 旧世代モデルでの代替手段 |
JSON mode は「JSON として壊れていないこと」しか保証しません。項目名が違っていても、必須フィールドが抜けていても通ってしまいます。対応モデルが広いという利点はありますが、公式ドキュメントも Structured Outputs を使えるなら必ずそちらを使うよう勧めています。
使い分けの線引きはシンプルです。モデルにこちらのツールを呼ばせたいなら Function Calling、モデルの返答そのものを決まった形で受け取りたいなら text.format です。
スキーマに掛かる上限
strict なスキーマには具体的な数値上限があります。大きめのスキーマを機械生成している場合は確認しておくとよいでしょう。
項目 | 上限 |
|---|---|
ネストの深さ | 10 階層 |
オブジェクトのプロパティ総数 | 5,000 個 |
プロパティ名・enum 値などの文字数合計 | 120,000 文字 |
enum 値の総数 | 1,000 個 |
キーワードの対応状況にも注意が必要です。allOf、not、if / then / else、dependentRequired は未対応で、strict と併用するとエラーになります。一方 anyOf は使えますが、ルート直下に置くことはできません。ルートは必ずオブジェクトである必要があり、Zod の discriminated union はルートが anyOf になるため、そのままでは通りません。$defs と $ref による再帰構造は使えるので、木構造の表現は問題なく書けます。
実装でつまずく落とし穴
呼び出しは常に複数を想定する
GPT-5 以降や Claude の各モデルは1ターンで複数のツールを並列に呼びます。出力配列には function_call アイテムが0個、1個、あるいは複数入ります。最初の1件だけを取り出す実装にすると、残りの呼び出しが宙に浮いて会話が壊れます。配列として処理するのが前提です。
並列を止めたい場合は OpenAI では parallel_tool_calls: false、Claude では tool_choice の disable_parallel_tool_use を使います。注意点として、ファインチューニング済みモデルでは1ターンに複数の関数が呼ばれると strict モードが無効になります。スキーマ厳守が要件なら、並列を切る判断が必要です。
拒否と打ち切りはスキーマ外
strict モードが保証するのは「完了した、拒否ではない出力」がスキーマに従うことだけです。モデルが安全上の理由で拒否した応答は refusal として別の形で返り、スキーマには従いません。max_output_tokens に達して途中で切れた応答も当然不正な JSON です。パースの前に、拒否と打ち切りを両方チェックするコードが必要になります。
そしてスキーマが保証するのは形だけで、中身の妥当性は別問題です。日付の形式が合っていても、存在しない顧客 ID が入ってくることはあり得ます。業務ルールの検証はアプリ側の責務として残ります。
for item in response.output:
    if item.type != "function_call":
        continue
    try:
        args = json.loads(item.arguments)  # arguments は JSON 文字列
    except json.JSONDecodeError:
        result = "error: 引数のパースに失敗しました"
    else:
        result = run_tool(item.name, args)  # 業務ルールの検証はここ
    outputs.append({
        "type": "function_call_output",
        "call_id": item.call_id,  # 対応付けを必ず維持する
        "output": result,
    })
引数の勝手な補完
ユーザーの発言に必要な情報が足りないとき、モデルは引数を推測で埋めることがあります。Anthropic のドキュメントは、場所を指定せず「天気は?」と聞いたときに Claude Sonnet が location: "New York, NY" のような値を勝手に入れる例を挙げています。Opus クラスのモデルは不足を認識して聞き返す傾向が強いとされますが、保証はありません。欠けていてはいけない引数は、説明文で明示するかアプリ側で検証するのが安全です。
戻り値がない関数も結果を返す
通知の送信のように返す値がない関数でも、成功か失敗かを示す文字列を返しておきます。何も返さないとモデルは実行されたかどうか判断できず、同じ呼び出しを繰り返すことがあります。
ツール定義のコスト管理
見落としがちなのが課金とコンテキストです。ツール定義はシステムコンテキストに挿入され、コンテキスト長を消費し、入力トークンとして課金されます。説明文を丁寧に書くほどコストが増える構造です。
Anthropic は tools を渡したときに自動で追加されるシステムプロンプトのトークン数を公開しており、Claude Opus 5.5 / Sonnet 5.5 / Haiku 5.5 ではいずれも 286 トークン、Claude Opus 4.7 では 675 トークンとされています。これはツール定義そのものとは別に掛かる固定費です。加えて、やり取りの中の tool_use ブロックと tool_result ブロックも毎ターン積み上がっていきます。
ツールの数自体も精度に効きます。OpenAI のガイドは、最初から使える関数は20個未満を目安に抑えることを勧め、そのうえで関数数を変えた精度評価を実施するよう助言しています。多数のツールを扱う方法としては、関連するツールを namespace でドメイン別にまとめ、使用頻度の低いものに defer_loading: true を付けて必要になってから読み込ませるツール検索(tool search、gpt-5.4 以降)が用意されています。
コスト削減でもう一つ効くのが allowed_tools です。呼べるツールを一部に絞りたいとき、tools の配列そのものを差し替えるとプロンプトキャッシュが効かなくなります。全体のリストは固定したまま allowed_tools で絞り込むほうが、キャッシュの観点で有利です。
MCPとの関係を整理
Model Context Protocol(MCP)は Function Calling を置き換えるものではなく、その上に乗る標準化レイヤーです。関係を押さえると両者の役割が見えてきます。
Function Calling は「モデルとアプリの間」の取り決めです。どの関数を呼ぶか、引数は何か、という部分をモデル API が規定します。一方 MCP は「アプリと外部ツール提供者の間」の取り決めで、JSON-RPC 2.0 の上に tools/list(ツールの一覧取得)と tools/call(実行)といったメソッドを定めています。
実際の動きは次のようになります。MCP クライアントが接続先のサーバーに tools/list を投げ、返ってきた name / description / inputSchema を集めてモデルに渡せるツール一覧を作ります。モデルがそのうちの1つを呼び出したら、クライアントが tools/call でサーバーに転送し、結果をツール出力としてモデルに戻します。つまり MCP サーバーの inputSchema は、そのまま Function Calling の parameters として使われます。
この構造の利点は、ツールの実装をアプリから切り離せることです。MCP は notifications/tools/list_changed による一覧変更の通知にも対応しているので、サーバー側でツールが増減したらクライアントが取り直せます。逆に言えば、MCP を使っていてもモデル側の制約(ツール数が増えると精度が落ちる、定義がトークンを食う)はそのまま残ります。多数の MCP サーバーを federate する場合に progressive tool discovery が推奨されるのは、このためです。
どう使い分けるか
最後に、プロバイダ間の用語の対応をまとめます。概念は共通なので、片方を理解すればもう片方にも移せます。
概念 | OpenAI Responses API | Claude Messages API |
|---|---|---|
引数のスキーマ |
|
|
モデルからの呼び出し |
|
|
結果の返却 |
|
|
スキーマ厳守 |
|
|
並列の無効化 |
|
|
設計の出発点としては、strict を有効にしてスキーマを厳しく書き、ツールは少数から始めるのが堅実です。精度が出ない場面では、ツールを増やす前に説明文を見直したほうが効くことが多いと公式ガイドも示しています。実際に手を動かすなら、ツール出力を返す往復と、拒否や打ち切りのハンドリングを先に書いてしまうのが近道になります。