 AI-Papers
- Transformerのブロックを並列に走らせる「分岐」を、幅と深さに続く第3の拡張軸として提案した研究です
- MoE構成0.8B〜2.1Bの事前学習で、同一パラメータ・同一計算予算の逐次Transformerを全スケールで上回りました
- 分岐間でKVキャッシュを共有するJoint-KVにより、キャッシュ量を最大34%削減し、H200単体でデコード速度が最大51.4%向上しています
研究の背景
Transformerを大きくするとき、これまで選べる方向はおおむね2つでした。1つは隠れ層の次元を増やす「幅」の拡張、もう1つはブロックを積み増す「深さ」の拡張です。どちらも性能は伸びますが、幅を広げれば計算量が二次的に増え、深さを伸ばせば1トークンを生成するまでに通過する段数が増えて推論が遅くなります。
イリノイ大学やCornell大学などの研究者らが発表した「Multi-Branch Transformer」(MBT)は、ここに3つ目の軸を持ち込みます。完全なTransformerブロックの列を複数本、横に並べて同時に走らせるという発想です。
並列化そのものは新しくありませんが、この論文は分岐を学習品質とデコード速度の両方を改善する設計軸として正面から扱い、パラメータ数と学習計算量を揃えた比較で検証している点に特徴があります。
分岐という第3の軸
MBTの構造は3つの部分からなります。入力側には全分岐で共有される初期ブロックが置かれ、中間部分が独立したパラメータを持つ複数の分岐に分かれ、各分岐の出力が融合層でまとめられてから共有の最終ブロックに渡されます。
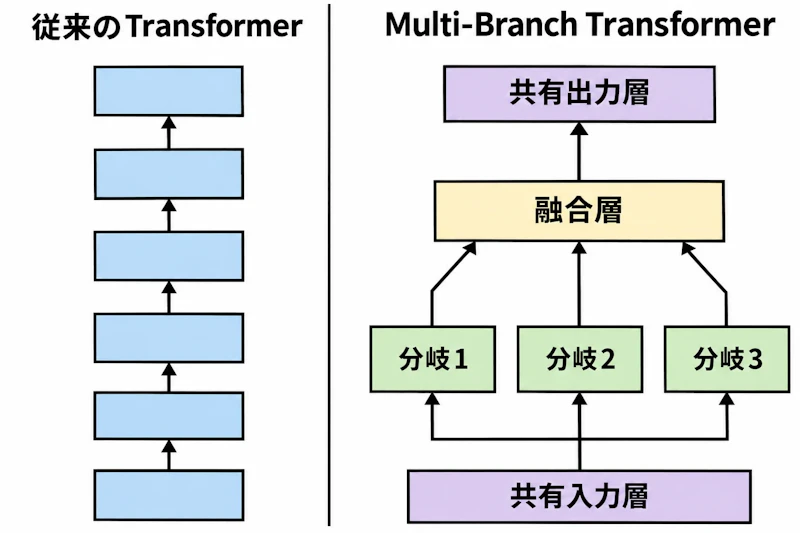
図1のように、ネットワークの中間だけを分岐させるのが基本形です。融合層は各分岐の出力をRMS正規化して結合し、線形変換で元の幅に戻すだけの単純な処理で、より複雑な学習型の融合を試しても効果は小さかったと報告されています。
同じ計算予算のなかで分岐を増やすには、幅か深さのどこかを削る必要があります。論文はその配分の違いで3つのバリアントを比較しました。
- Wide-Shallow: ブロックの幅を保ち、中間ブロックを分岐に振り分ける
- Narrow-Deep: 各分岐の段数を保ち、ブロックを細くする
- Balanced: 幅と深さを同時に調整し、両者の中間を取る
結果としてはBalancedが全スケール・全分岐数で最良でした。逆にNarrow-Deepのように深さを維持して分岐を細くする方針は、特に4分岐で品質が落ちています。計算予算が固定なら、分岐を増やしつつ細さを極端にしない配分が有利ということになります。
Joint-KVでキャッシュを共有
分岐を増やすと、推論時に困る点が1つあります。素朴に実装すれば各分岐の各ブロックが自前のKey/Valueを持つため、KVキャッシュ(過去のトークンの中間表現を保持して再計算を省くメモリ領域)が分岐数の分だけ膨らみ、長文の生成でメモリを圧迫してしまいます。
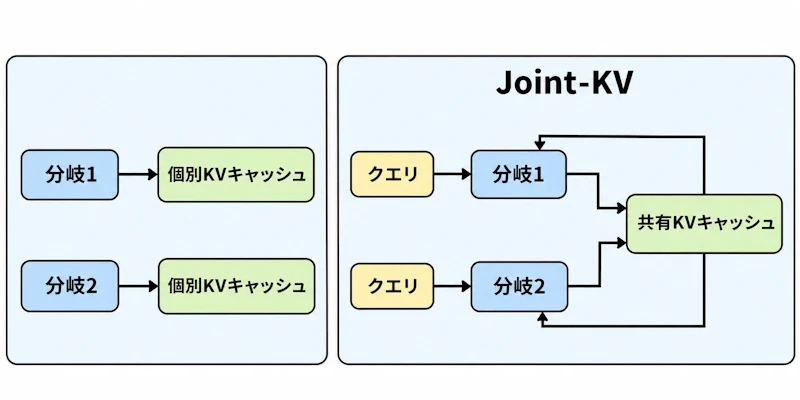
そこで提案されたのがJoint-KVです。図2の右側のように、同じ深さにある分岐の入力を結合して1組のKey/Valueを作り、全分岐で共有します。クエリは分岐ごとに独立したままなので、各分岐は共有キャッシュを自分の視点で参照できます。
分岐数がK本なら分岐領域のキャッシュは1/Kになり、射影のパラメータ数と計算量は変わりません。キャッシュ容量を同じに揃えた2分岐の比較でも、分岐ごとに個別キャッシュを持たせる場合より検証損失が0.011〜0.012低くなっており、単なる節約手段ではなく品質面でも有利に働いています。
Joint-KVは学習時から使われるためモデル自体の設計変更ですが、推論側はnano-vLLMをベースにした実行エンジンで対応します。同じ深さのブロックをまとめて計算するブランチグルーピングと、共有キャッシュに対する注意計算を1回のカーネル呼び出しに畳み込むヘッドフォールディングが中心です。推論の高速化手法としては投機的デコーディングのような外付けの工夫もありますが、MBTはアーキテクチャ側で段数そのものを減らす方向を取っています。
実験結果
評価はFineWeb-Eduを用いた事前学習で行われました。各ブロックに64エキスパートのMoE(入力ごとに一部の専門家だけを使う仕組み)を置いたW1からW4の4スケールで、総パラメータは約0.80Bから2.07B、学習トークンは27.8Bから78.8Bです。
2分岐のWide-Shallowでは、全ブロックのうち約3分の1を分岐に割り当てたときに検証損失が最も低く、逐次型より0.025〜0.031下回りました。9タスクのゼロショット平均精度は54.23%から56.03%へ改善しています。分岐を3本、4本に増やしても平均の検証損失の変化は0.006未満で、いずれも逐次型を下回りました。
Balanced構成にJoint-KVを組み合わせた最終モデル12本は、すべて同スケールの逐次型より検証損失が低くなりました。主な数値は次の通りです。
指標 | 逐次Transformer | Balanced MBT + Joint-KV |
|---|---|---|
9タスク平均ゼロショット精度 | 54.23% | 55.92%(2分岐) |
検証損失2.5に必要な計算量 | 1.26倍 | 1.00倍(2分岐基準) |
KVキャッシュ量 | 基準 | 19〜34%削減 |
デコードスループット | 基準 | 最大1.514倍 |
速度の利得は、分岐によって逐次的に通過する段数が減ることから来ています。たとえば4分岐のW3モデルは合計24ブロックを持ちますが、順番に通る必要がある段数は12で、逐次型の16より少なくなります。4分岐での実測は、スケールを平均して1.12倍から1.50倍の高速化でした。
課題と今後の展望
比較条件には偏りも残ります。逐次型のベースラインはスケールごとに学習率を調整しているのに対し、MBT側は1つの構成で調整した値を他へ流用しており、MBTにとって不利な側面はあるものの厳密な同条件とは言えません。速度の計測もH200単体、生成長1Kトークンという設定で、学習時の4Kコンテキストより短い範囲の結果です。
検証規模も2B程度までで、より大きなモデルでも同じ傾向が続くかは分かっていません。著者らは分岐数・分岐の深さ・隠れ次元を同時に扱うスケーリング則の定式化や、YOCOやCross-Layer Attentionと組み合わせて層方向にもキャッシュを共有する方向、さらにモダリティごとに分岐を割り当てるマルチモーダル版への拡張を挙げています。
コードはGitHub、学習済み重みはHugging Faceで公開されており、分岐という設計軸を自分の環境で確かめられる状態になっています。推論コストが運用の主要な制約になりつつある現状では、品質と速度を同じ変更で動かせる設計軸は検討に値するでしょう。
論文情報: "Multi-Branch Transformer"(Gaotang Li et al., 2026) arXiv:2611.19800, CC BY 4.0


