 AI-Papers
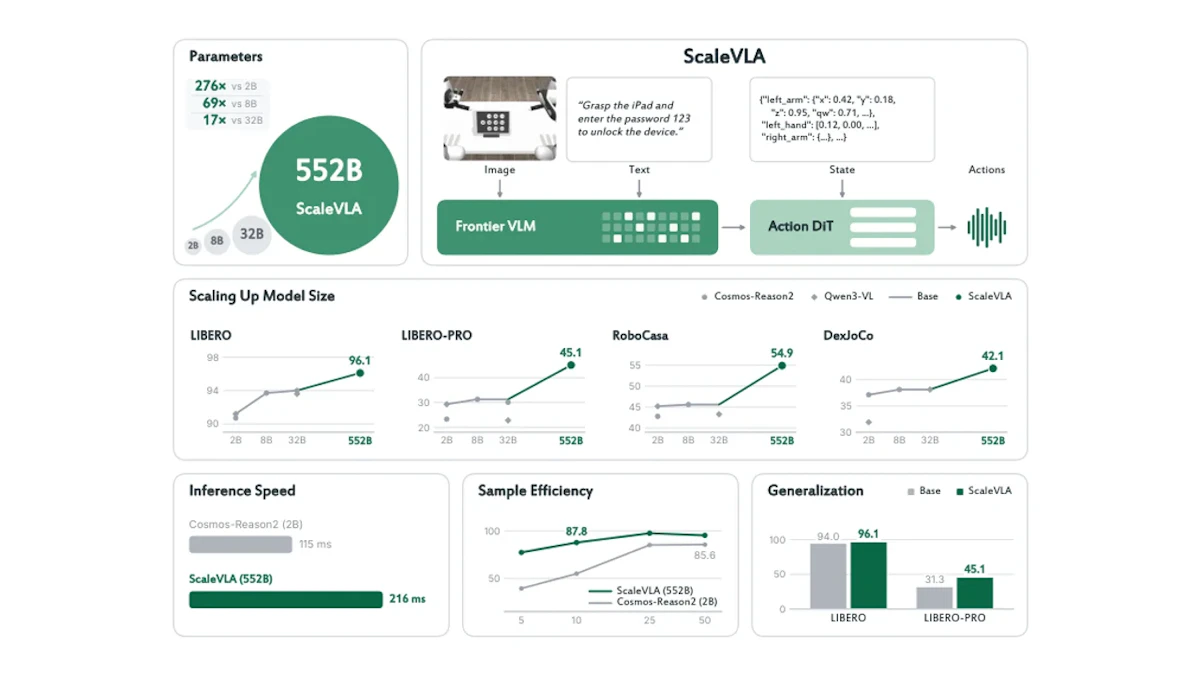
- ロボット操作向けのVision-Language-Actionモデルのバックボーンを2Bから552Bまで統一条件で比較し、スケールの効果を検証した技術報告です
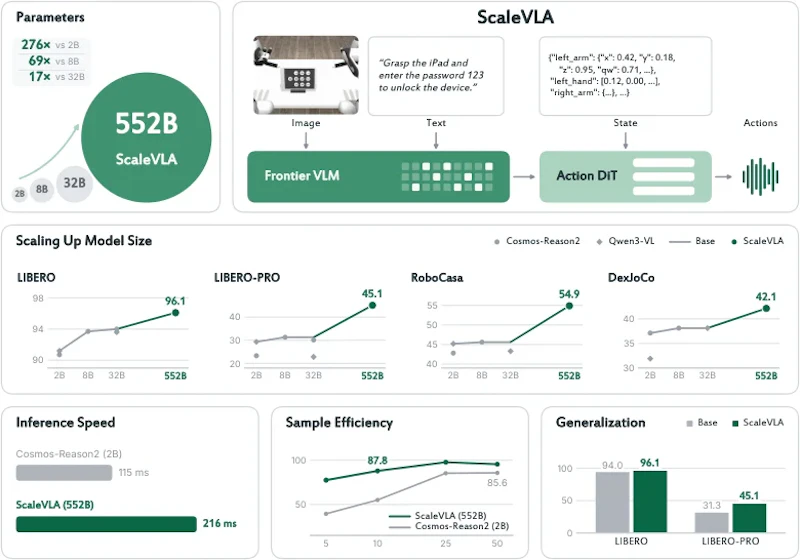
- LIBERO Goalでは10デモ学習で成功率87.8%に達し、2Bバックボーンが50デモで得た85.6%を上回りました
- 行動チャンクあたりの推論遅延は中央値215.8msで、パラメータ数276倍に対し遅延は約1.9倍に収まっています
研究の背景
ロボットに「引き出しを開けて」といった指示を与え、カメラ画像と言語指示から直接動作を出力するモデルは、Vision-Language-Action(VLA)モデルと呼ばれます。画像と言語を理解するVision-Language Model(VLM)を土台にして、そこに行動を生成する部分を接続する構成が一般的です。
ところが、言語モデル側では数百Bパラメータ級が当たり前になっている一方で、VLAの土台に使われるVLMは2Bから8B程度の小型モデルが主流でした。ロボットは実時間で動く必要があり、推論の遅さが致命的になりやすいためです。
清華大学などの研究チームによる ScaleVLA は、この前提を正面から問い直した技術報告です。フロンティア級のVLMが持つ世界の知識は、ロボット学習の土台としてどこまで有利になるのか。それを確かめるために、2Bから552BまでのバックボーンをすべてScaleVLAと同じ行動ヘッド、同じデータ、同じ学習予算で比較しています。
提案手法
ScaleVLAは、552BパラメータのMixture-of-Experts型VLMであるDeepSeek-V4.1-Flashに、学習可能な行動DiT(Diffusion Transformer)を接続した構成です。図1が全体像を示しています。
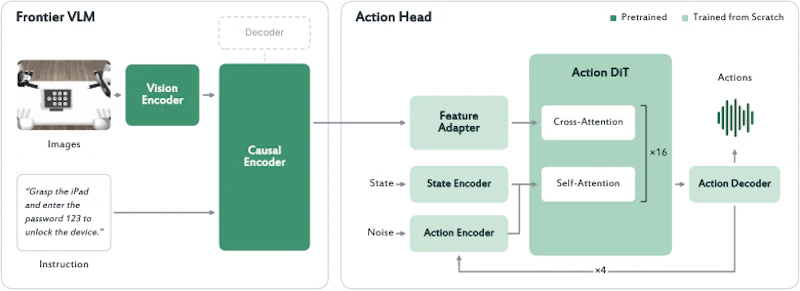
重要なのは、巨大なバックボーンを学習させていない点です。VLMの重みは凍結したまま、画像と指示をcausalエンコーダに1回通して5120次元の特徴を取り出し、デコーダは使いません。つまりテキストを生成しないため、トークンを1つずつ出す必要がなく、行動チャンク(数ステップ分の動作をまとめた単位)1つにつきエンコーダ1回で済みます。
取り出した特徴はGR00T N1.7の設計に沿った行動ヘッドへ渡されます。32層のDiTがself-attentionとcross-attentionを交互に重ね、flow matchingという生成手法で学習され、推論時はわずか4ステップで行動チャンクを出力します。学習対象は行動側だけで、バックボーン特徴は事前計算されます。図2がこの接続部分の詳細です。
この設計のおかげで、552Bという規模でも遅延の増加は抑えられています。RoboCasa環境での計測では、ScaleVLAの行動チャンクあたりの遅延は中央値215.8ms(H200 GPU 4基)で、2Bバックボーンの114.7ms(1基)に対して約1.9倍にとどまりました。パラメータ数の差が約276倍であることを考えると、エンコーダ1回という設計が効いていると言えます。行動ヘッド自体の処理時間はバックボーンの大きさに関係なく約70msで一定です。
実験結果
評価は4つのシミュレーション環境で行われました。LIBEROは卓上操作、LIBERO-PROはLIBEROの物体や背景に摂動を加えた汎化テスト、RoboCasaは学習分布外のキッチン環境、DexJoCoは2つの多指ハンドの協調を要するタスク群です。
ベンチマーク | ScaleVLA(552B) | 最良の小型バックボーン |
|---|---|---|
LIBERO 4スイート平均 | 96.1% | 94.0%(Cosmos-Reason2-32B) |
LIBERO-PRO 平均 | 45.1% | 31.3% |
RoboCasa(30デモ) | 30.7% | 25.6% |
RoboCasa(100デモ) | 54.9% | 45.6% |
DexJoCo(物体ランダム化) | 42.1% | 38.1% |
差が最も大きく出たのはLIBERO-PROで、45.1%対31.3%と14ポイント以上開きました。素のLIBEROでは96.1%対94.0%と差が2ポイント程度なので、スケールの恩恵は「条件が変わったとき」に集中して現れていることがわかります。
サンプル効率でも傾向は明確です。LIBERO Goalで1タスク5デモの場合、2Bバックボーンは39.4%にとどまる一方、ScaleVLAは77.4%を記録しました。10デモでは87.8%で、2Bが50デモ使って到達した85.6%を上回っています。ただしデモ数が増えるほど差は縮まり、長尺タスクのLongを除けば優位は小さくなります。
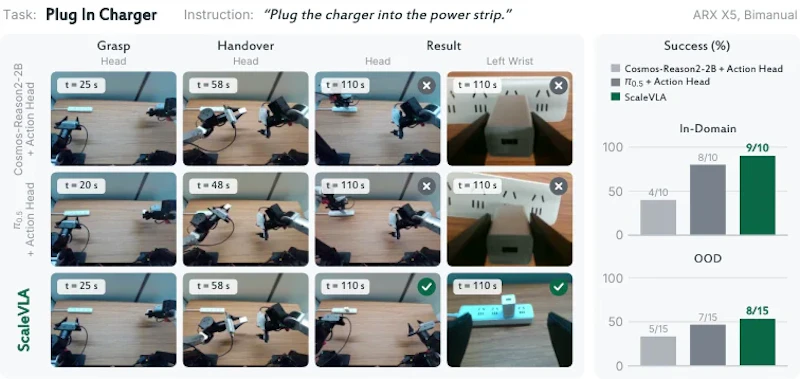
実機実験は双腕ロボットによる充電器のコンセント挿入で行われました。図5のとおり、3つの方策はいずれも充電器を把持して持ち替えるところまでは成功しますが、プラグをソケットに正しく位置合わせして差し込めたのはScaleVLAだけでした。学習分布内では10試行中9回成功(2Bバックボーンは4回、π0.5は8回)、分布外でも15試行中8回成功しています。挿入完了までの時間の中央値も58.1秒と最短で、1チャンクあたりの遅延が384msと最も大きいにもかかわらず、接触を伴う位置合わせが速く決まる分だけ全体では速くなりました。
まとめと今後の展望
ScaleVLAが示したのは、フロンティア級のVLM特徴が効くのは「データが少ないとき」「条件が変わったとき」「接触の精度が要るとき」に限られる、という比較的はっきりした線引きです。素のLIBEROのように飽和した課題では差はわずかで、規模の恩恵は均等には現れません。
一方で、結果の読み方には注意が必要です。著者自身が触れているとおり、各方策の学習はシード1つのみで、実機評価も1タスク・10試行と15試行という小さな標本に基づいています。サンプル効率の比較も学習予算を固定した条件下のもので、2Bモデルは更新回数を増やせばまだ伸びる余地があるため、収束後の性能差を表しているとは言えません。
運用面のコストも無視できません。ScaleVLAはGPU 4基を必要とし、追加の入力トークンが遅延にどれだけ寄与しているかは切り分けられていません。また完全ランダム化条件での組み立てタスクは、どの方策もほぼ0%のままです。推論効率の改善という観点では、MMFlashのような投機的デコーディングによるVLM高速化と組み合わせる方向も考えられますが、ScaleVLAはデコーダを使わない設計のため、適用できる余地は限定的でしょう。巨大バックボーンを凍結して特徴抽出器として使うという割り切りが、実機で動くVLAの現実的な落としどころを示した報告と見るのが妥当です。
論文情報: "ScaleVLA: Scaling Vision-Language-Action Models to 552 Billion Parameters"(Ruixi Yu et al., 2026) arXiv:2611.21607, CC BY 4.0
本記事の図(図1、図2、図5)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


