 AI-Papers
- トークンごとの「視覚依存度」をKLダイバージェンスで測ると、ドラフトの受理率が46%から22%へ落ちる偏りが見つかった
- MMFlashは視覚依存が強く、かつドラフトが外しやすいトークンに学習の重みを寄せる損失設計を採用
- 出力を変えないロスレス高速化で最大3.58倍、EAGLE-3比で最大195.4%、DFlash比で最大17.1%の改善
研究の背景
大規模な視覚言語モデル(Vision-Language Model、VLM)は、画像や動画を理解して文章を生成できますが、生成は1トークンずつ順番に進むため待ち時間が長くなりがちです。この待ち時間を削る代表的な技術が投機的デコーディングです。軽量な「ドラフトモデル」が先に複数トークンを予測し、本体のモデルがそれらをまとめて検証して、合っていた分だけ一気に採用します。
検証は本体モデル自身が行うため、最終的な出力は投機的デコーディングを使わない場合と完全に一致します。品質を落とさずに速くできる、いわゆるロスレスな高速化という点が、この手法が広く使われる理由です。LLM推論エンジン比較2026、vLLM・SGLang・TensorRT-LLMの違いと選び方で触れたような推論基盤にも、すでに標準的な機能として組み込まれています。
ただし既存の高速ドラフト手法は、ほとんどがテキストのみのタスクを想定して設計されてきました。1回の順伝播でトークンブロック全体を提案する拡散型ドラフタのDFlashもその一つで、画像や動画が入力に加わったときに何が起きるかは十分に検証されていませんでした。シンガポール国立大学の研究チームが公開したMMFlashは、この空白を埋める研究です。
視覚依存度という指標
著者らはまず、ドラフトモデルがどこで失敗しているのかを特定しようとしました。そこで導入したのが、トークン単位の視覚依存度スコアです。測り方は単純で、同じ文脈に対して本体モデルを2回動かします。1回は画像を与え、もう1回は画像を取り除き、次トークンの確率分布がどれだけ変化したかをKLダイバージェンスで数値化します。
この値が大きいトークンは、画像を見ていなければ当てられないトークンだということになります。グラフの数値や物体の色など、文脈だけでは補完できない情報が典型例です。
Qwen3.5-4Bでの分析結果は明確でした。視覚依存度が最も低い四分位のトークンは46%が受理されるのに対し、最も高い四分位では22%しか受理されません。約2.1倍の差です。さらに、ブロックの中で最初に却下されるトークンの44%が最高四分位に集中しており、最低四分位はわずか7%でした。マルチモーダルなデータで追加学習しても、この偏りは解消しなかったと報告されています。つまり、学習データを増やすだけでは届かない構造的な弱点だということです。
MMFlashの損失設計
MMFlashはこの分析をそのまま設計に反映します。ドラフタの学習時、ブロック内の各位置にかける重みを、基礎重みと視覚ボーナスの掛け算で決めます。
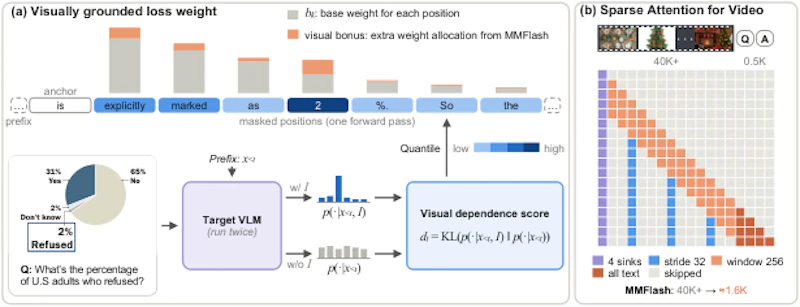
図2(a)が示すように、視覚依存度は画像を入れた場合と外した場合の2つの出力分布の差として求められます。基礎重みは、その位置より前のドラフトトークンがすべて検証を通過する確率の見積もりで、前半の位置を重視する働きをします。これに視覚依存度の分位に応じたボーナスが加算されますが、ボーナスには「ドラフタがまだそのトークンを当てられていない度合い」が掛けられています。
この仕組みによって、ドラフタが学習して当てられるようになったトークンの重みは自然に下がり、学習の労力は依然として外しやすい視覚依存トークンへ集まり続けます。難しい場所に重みを固定するのではなく、学習の進み具合に合わせて配分が動くところが設計の勘所です。
長尺動画へのスパース注意
動画になると別の問題が生じます。画像入力の平均文脈長は約477トークンですが、動画では約41,000トークンにまで膨らみます。軽量なドラフタにこれを毎回全部読ませると、ドラフト自体が重くなり高速化の意味が薄れてしまいます。
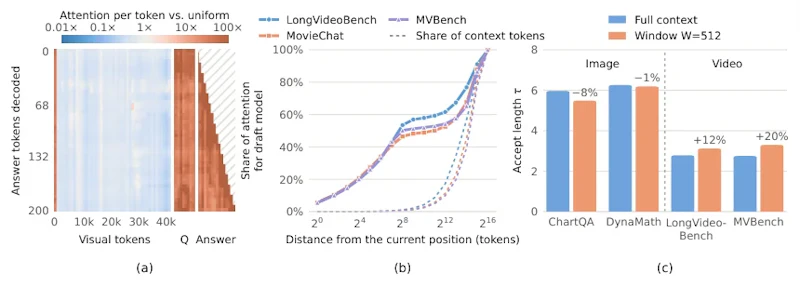
図4の分析によると、直近256位置は文脈全体のわずか0.8%しか占めていないのに、ドラフタの注意の50.1%を受け取っていました。ドラフタは遠い過去をほとんど見ていないということです。そこでMMFlashは、先頭の4トークン、32トークンおきに間引いた視覚トークン、すべてのテキストトークン、直近256トークンの局所窓だけを残すパターンを採用しました。4万トークン超の文脈が約1,600トークンに縮みます。
実験結果
評価はQwen3.5-4Bと9Bを本体モデルとし、画像系7ベンチマーク(ChartQA、CharXiv、MMStar、MMBench、DynaMath、MathVista、MathVerse)と動画系3ベンチマーク(LongVideoBench、MVBench、Video-MME)で行われました。貪欲デコーディング時の平均値は次の通りです。
本体モデル | 手法 | 平均速度向上 | 平均受理長 |
|---|---|---|---|
Qwen3.5-4B | MMFlash | 3.00倍 | 5.70 |
Qwen3.5-4B | DFlash | 2.72倍 | 5.12 |
Qwen3.5-4B | EAGLE-3 | 1.58倍 | 3.86 |
Qwen3.5-9B | MMFlash | 3.05倍 | 5.60 |
Qwen3.5-9B | DFlash | 2.75倍 | 4.95 |
最大値はQwen3.5-9BのChartQAで記録した3.58倍です。動画側では、Qwen3.5-9Bで LongVideoBench 3.07倍、MVBench 2.66倍、Video-MME 2.39倍となり、DFlashを11.2%から23.2%上回りました。Gemma4-E4B-itやQwen3.8-27Bでも効果が確認されており、特定モデル向けの調整ではないことが示されています。
限界と今後の展望
課題も率直に記されています。対象は画像または動画からテキストへの生成に限られ、音声を含むオムニモーダルなモデルは今後の課題です。動画対応は専用ドラフタではなく単純なスパースパターンと軽い追加学習に頼っており、長尺動画のドラフトは依然として難しいとされています。
実運用の観点では、同時リクエスト数が多い状況では処理がメモリ帯域ではなく演算に律速されるため、速度向上の幅が縮むという指摘が重要です。また、評価は各ベンチマークから200サンプルを無作為抽出して行われており、比較対象のDFlash-zは公式の学習レシピが非公開で完全な再現ができていません。報告値の幅はある程度見込んで読むべきでしょう。
とはいえ、「どのトークンでドラフタが失敗しているのか」を測る指標を定義し、その分析を直接損失関数へ落とし込むという流れは分かりやすく、他のマルチモーダル高速化にも応用が利きそうです。論文は執筆中(work in process)と明記されており、今後の版で追加の検証が加わる可能性があります。
論文情報: "MMFlash: Faster Speculative Decoding for Vision-Language Models"(Sicheng Feng et al., 2026) arXiv:2611.18482, CC BY 4.0
本記事の図(図2、図4)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


