 AI-Papers
- Qwen3.5 27B が自分の重みを読み、失敗の原因を推論で診断して書き換え、未知の数学問題で正答率を57.2%から63.8%へ6.6ポイント改善
- 勾配計算も最適化器も使わず順伝播のみで完結し、8回連続のセッションを通じて使用中モデルの精度は下がらずに上昇
- ノイズで壊した自分のコピーを、元の重みを参照せずに画像タスクで元モデル比約83%まで復元。この能力は27Bのみに現れた
研究の背景
言語モデルは一度学習させると重みが固定されます。そこから性能を上げたい場合、選択肢は大きく2つでした。もう一度学習を回すか、プロンプトや推論時の計算量を増やして振る舞いを変えるかです。
前者には勾配計算と学習基盤が必要で、後者で得た改善は回答が終わると消え、1回答ごとに追加コストがかかります。イリノイ大学アーバナ・シャンペーン校などの研究チームが発表した論文「Language Models Can Rewrite Their Own Weights」は、ここに第3の道を示しました。
モデル自身が自分の重みファイルを読み、どこが失敗の原因かを推論で突き止め、その部分を書き換えるというものです。著者らはこれを self-rewriting(自己書き換え) と呼び、言語モデルが自らの推論だけで自分の重みを改善した初の実証だと主張しています。
自己書き換えの仕組み
実験に使われたのは Qwen3.5 の 27B モデルです。モデルには Python 実行環境が与えられ、重みテンソルの読み出しと置き換えができます。さらに編集前の重み、編集後の重み、またはその両方で練習問題を解かせる生成ツールと、内部の隠れ状態を取り出す読み出しツールも使えます。
編集の中心となるのは、ある行列が隠れ状態のある方向に書き込む量を指定した割合だけ弱める操作です。対象になるのは Attention 層と MLP 層の出力行列で、入力埋め込み・最終正規化・出力層・テンソル全体のスケール変更は拒否されます。勾配計算と最適化器、GPU、ネットワーク接続、プロセス生成はすべて遮断されており、学習の手段は一切ありません。
1セッションで使えるのは順伝播20回とコード実行200回です。モデルは候補となる編集を同一の乱数シードで編集前後を比べる対照実験にかけ、効果が確認できたものだけを提出します。有望でなければ何も提出せずに撤退することもできます。
最初のセッションでモデルが診断した失敗は、回答が同じ内容を繰り返してトークン上限に達する現象でした。モデルは自分の隠れ状態を読み出し、繰り返しに陥った回答では32トークンごとにほぼ同一の状態へ戻っていることを突き止めています。
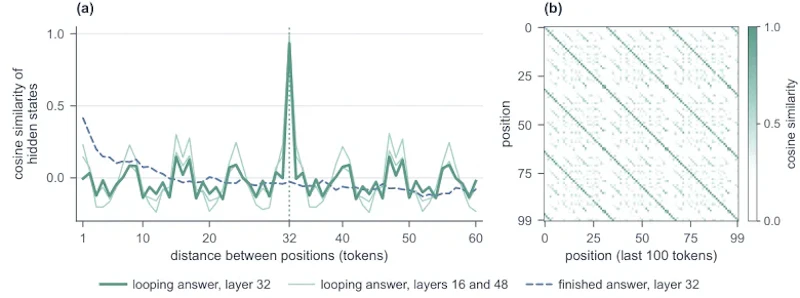
図1は、そのときモデルが要求した隠れ状態の読み出しから計算された図です。正常に終了した回答にはこうした周期が現れません。モデルはこの繰り返し方向を特定して10個のテンソルを編集しましたが、広めの検証で裏づけが取れなかったため、自ら提出を取り下げています。
実験結果
練習用には DeepScaleR の数学問題3,000問を使い、評価は重複を除いた未知の問題で行われます。第1の手順では、モデルが自分で選んだ課題での正答率が22.4%から29.6%へ上がり、未知の490問でも57.2%から58.3%へ改善しました。提出された編集は、層8の2つの出力行列からある方向の成分を5%削るというものでした。
改善幅が大きかったのは、提出の可否を予約済みの練習問題での1回の検証にゆだねる第2の手順です。8セッションを通した結果が以下になります。
条件 | 対象 | 精度 |
|---|---|---|
編集なし(基準) | 未知490問 | 約57.2% |
セッション2の編集 | 未知490問 | +4.0ポイント |
セッション8の編集 | 未知490問 | 63.8%(+6.6ポイント) |
破損コピー(修復前) | 未知200問 | 0.0% |
破損コピー(自己修復後) | 未知200問 | 33.0%(元モデル58.5%) |
破損コピー(自己修復後) | 画像6種の合計 | 70.2%(修復前7.3%) |
8セッションのうちモデルが編集を提出したのは3回で、残り5回は撤退しました。撤退を選べる設計のおかげで、使用中のモデルの精度は一度も下がっていません。改善が積み上がるのはこの保守性によるところが大きいでしょう。
壊れた自分を修復する
もう1つの実験では、27Bモデルの64層のうち層30の MLP 出力行列の8行をノイズで上書きし、ほぼ何も答えられない状態にしたコピーを用意しました。モデルに伝えられるのは「どこかの値が壊れている」という情報だけで、元の重みは参照できません。
数学のテキスト問題で発見した修復を、セッション中に一度も見ていない画像ベンチマーク6種(MMStar、HallusionBench、POPE、ScreenSpot-v2、MathVista、MathVerse、各100問)に適用した結果が図2です。合計精度は7.3%から70.2%へ、元モデルの約83%の水準まで戻りました。画面上の指定要素をクリックする ScreenSpot-v2 では0%から89%へ回復し、元モデルの93%に迫っています。
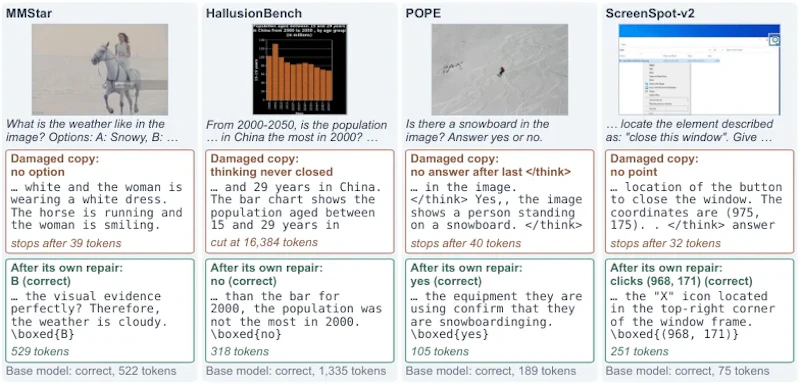
破損箇所として名指しされた行列だけを修復した場合は55.0%にとどまり、モデルが行った編集はより広範囲に効いていたことがわかります。ただし修復は元の重みを取り戻すものではなく、テキスト問題では33.0%と元モデルの58.5%に届きません。失われた情報が復元されたのではなく、壊れた成分の影響が抑え込まれたと理解すべき結果です。
大きさで現れる能力差
同じ枠組みを Qwen3.5 の 2B、4B、9B にも適用した比較が、この研究のもう1つの論点です。2B は編集を一切作れず、4B は自前の検証で全問を落とす編集を作り、セッション終了間際にようやく撤退しました。9B が提出した編集は、未知の問題に答えられない状態をもたらしています。
自己改善と自己修復のどちらも成功したのは 27B だけでした。自己書き換えが規模とともに創発する能力である可能性を示す結果ですが、検証は1つのモデルファミリーの4サイズに限られます。自己進化エージェントのようにプロンプトや外部メモリを更新する手法と異なり、改善が重みに保存されるため1回答あたりの追加コストが発生しない点が特徴です。
まとめと今後の展望
self-rewriting は、推論用の順伝播だけで自分の重みを改善するという点で、学習とも推論時スケーリングとも異なる位置にあります。著者らは、自己編集を終えたモデルが次のセッションを自分自身に対して実行し、自らの編集を検証する再帰的な自己改善を今後の課題に挙げています。
一方で課題は残ります。テキスト側の課題は数学のみで、第1の手順での未知問題の改善幅は1.1ポイントと小さく、修復実験も単一の破損パターンでしか検証されていません。少数の問題による検証では精度低下を見落とす可能性もあります。
著者ら自身も、提出された編集は性能だけでなく安全性の観点から評価し、使用前に人間が確認すべきだと述べています。モデルが自分の重みを書き換えられる枠組みは、どこまで自律に委ねるかという設計判断と切り離せません。
論文情報: "Language Models Can Rewrite Their Own Weights"(Jiajun Fan et al., 2026) arXiv:2611.21885
本記事の図(図1〜図2)は解説のため上記論文より引用しています。


