 AI-Papers
- 画像・動画の拡散Transformerに対する強化学習(RL)事後学習の効果が、プロンプトやトークンに依存しない「固定の足し算」でほぼ説明できることを示した分析研究です
- SD3.5-Mでは188本・計0.29Mパラメータのステアリングベクトルだけで、18.8MのRL学習済みLoRAによる報酬向上の90.8〜95.9%を再現しました
- ゼロから初期化したベクトルをオンラインRLで直接学習すると、PickScoreで103.6%、OCRで104.6%と重み更新型のRLを上回りました
研究の背景
画像生成や動画生成の拡散モデルは、事前学習のあとに強化学習(RL)で追加調整されることが増えています。人間の好みを予測するスコアや、文字が正しく描けているかを判定するOCR、プロンプトの要素が揃っているかを見るGenEvalなどを報酬として、Flow-GRPOやDanceGRPOといった方策勾配法でモデルの重みを更新する手法です。見た目の質、文字の描画、構図の正確さがいずれも改善することが報告されてきました。
では、その改善の中身は何なのでしょうか。重みが変わると、入力されたトークンごとに違う方向へ出力がずれます。つまりRL事後学習は本来「入力依存の変化」をもたらすはずです。
この論文「RL Post-Training in Diffusion Transformers Is Activation Steering」は、その変化のうちどれだけが入力に依存しない定数のずれで説明できるのかを測りました。著者はVirginia Techなどの研究チームで、2026年11月に公開されています。
固定ベクトルという仮説
提案されているのは驚くほど単純な仕掛けです。事前学習済みのモデルは凍結したまま、各ブロックの出力に固定のベクトルを1本足します。このベクトルはプロンプトが何であっても、トークンの位置がどこであっても、サンプリングのシードが何であっても同じ値です。
変わるのは4つの軸だけで、ブロック番号、分類器フリーガイダンスの条件付き側か無条件側か、サンプリング時刻の区間(t=0.75で2分割)、そしてテキスト側か画像側のストリームかです。SD3.5-Mの場合これで188本になり、合計0.29Mパラメータに収まります。比較対象となるRL学習済みのrank-32 LoRAは18.8Mなので、約65分の1の規模です。
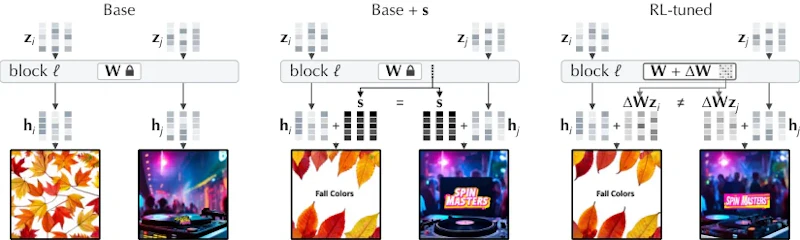
図2が両者の違いを表しています。RL後のモデルでは入力ベクトルごとにずれ方が変わりますが、ステアリングのほうは黒い矢印が示すように全トークンに同じ量を足します。この粗い介入で性能差がどこまで埋まるかが問いです。
速度を合わせて学習
ベクトルの求め方には報酬を一切使いません。まずRL学習済みモデルに画像を生成させ、その最終結果にノイズを戻してから、凍結したベースモデルの予測速度がRL学習済みモデルの速度に一致するよう、ベクトルだけを回帰で学習します。初期値には、RL後のモデルで観測された活性化の変化を平均した値を使います。
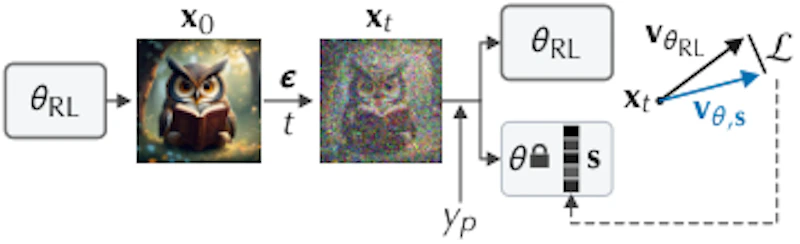
図4のとおり、勾配はベクトルにしか流れません。報酬最大化ではなく「RL後のモデルの振る舞いを定数で模倣できるか」を測る蒸留に近い設計で、だからこそ回復率がそのまま仮説の検証になります。
実験結果
評価は画像6モデルと動画2モデルで行われました。SD3.5-MのFlow-GRPO(PickScore、OCR、GenEval)、FLUX.1-devのFlow-GRPOとDanceGRPO、Wan2.1-1.3BのGenRL GRPO、Wan2.2-5BのVBVR-Proという構成で、LoRAと全パラメータ微調整の両方を含みます。下表は、RL学習済みモデルが得た報酬向上をどれだけ再現できたかの割合です。
モデル / 報酬 | ステアリングベクトル | 平均差分ベースライン |
|---|---|---|
SD3.5-M PickScore | 90.8% | 61.0% |
SD3.5-M PickScore(KLなし) | 95.2% | 70.8% |
SD3.5-M OCR | 94.4% | 21.5% |
SD3.5-M GenEval | 95.9% | 12.2% |
FLUX.1-dev PickScore | 90.0% | 64.7% |
FLUX.1-dev HPSv2.1 | 96.3% | 79.0% |
Wan2.1-1.3B HPSv3 | 111.9% | 59.3% |
Wan2.2-5B ルールスコア | 89.8% | 60.8% |
画像では90.0〜96.3%、動画では89.8%と111.9%です。活性化の変化を単に平均しただけのベースラインはOCRで21.5%、GenEvalで12.2%しか回復しないため、速度を合わせる学習が効いていることがわかります。
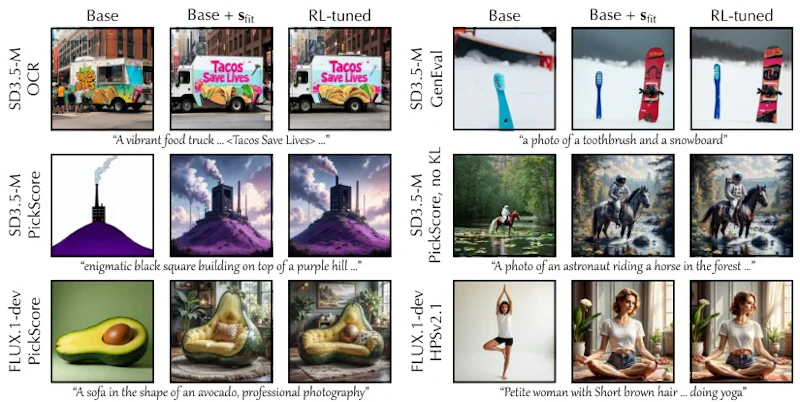
図5のように、同じ初期ノイズから出発したときの絵柄もRL後のモデルに近づきます。GenEvalではRL後のモデルが正解にできたプロンプト対の91.4%を、OCRでは75.3%をステアリング版も解けています。50プロンプト・25名の人手評価ではベースモデルに対する勝率が60〜65%、RL学習済みモデルに対しては約50〜52%で、統計的な差は検出されませんでした。
512pxで求めたベクトルは768pxや1024pxでも機能し、サンプリングステップ数20と28、CFGスケール3〜7でも向上の90〜96%を保ちました。DWDのようにデコーダ構成を変える研究と比べても、既存の重みに手を触れない点で導入コストは軽いといえます。
RLで直接学習すると
さらに踏み込んだ実験として、ベクトルをゼロ初期化し、凍結したSD3.5-M上でFlow-GRPOによって直接学習しています。結果はPickScoreで103.6%、OCRで104.6%となり、重みを更新する通常のRLの向上幅を上回りました。0.29M分の自由度しか持たない介入が、18.8Mの更新と同等以上の報酬を得たことになります。
効果の伝わり方にも偏りが見られました。条件付き側のベクトルだけで全体の向上に届く一方、無条件側だけでは報酬が下がります(PickScoreで−1.335ポイント)。最後の8ブロックを外してもOCRの向上は99%残り、初期ステップとテキストストリームへの寄与が大きいという分析も示されています。画像トークンがテキストから読み取るキーと値をベースモデルのものに差し替えると向上の大半が消えるため、正規化と注意機構が共通のずれをプロンプト固有の変化に変換していると著者は解釈しています。
限界とまとめ
著者自身が慎重に線を引いている点も押さえておきたいところです。
- RL後のモデルがステアリングベクトルを必要とする、という必然性の主張はしていない
- RL事後学習が低ランクであるとも主張していない(全パラメータ微調整でも再現できたため)
- 対象の8モデルはすべて方策勾配法で、選好最適化や報酬逆伝播は未検証
- 教師あり微調整では再現が難しく、DreamBoothの被写体で73〜95%、架空の人物で68〜83%にとどまる
- 同サイズのLoRAと比べて優位が確認できない行も多く、Wan2.1のみ差が大きい
- 動画RL事後学習全般ではなく、2つの基盤モデル上の2手法のみを扱っている
人物や特定の被写体を覚えさせるタスクでは、ベクトルは大まかな見た目を再現できても細部や同一性を取りこぼします。つまり「定数シフトで足りる」のは報酬を上げる方向の調整に限った話で、新しい概念を教え込む学習とは性質が違うわけです。
それでも、方策勾配によるRL事後学習の大部分がモデルが既に計算できる領域への誘導にすぎないという示唆は、計算コストの観点でも解釈の観点でも扱いやすい発見です。0.29Mのベクトルを配布するだけで品質改善を再現できるなら、生成モデルの軽量なチューニング手段として検討する価値があります。
論文情報: "RL Post-Training in Diffusion Transformers Is Activation Steering"(Tuna Han Salih Meral et al., 2026) arXiv:2611.26627, CC BY 4.0
本記事の図(図2、図4、図5)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


