 AI-Papers
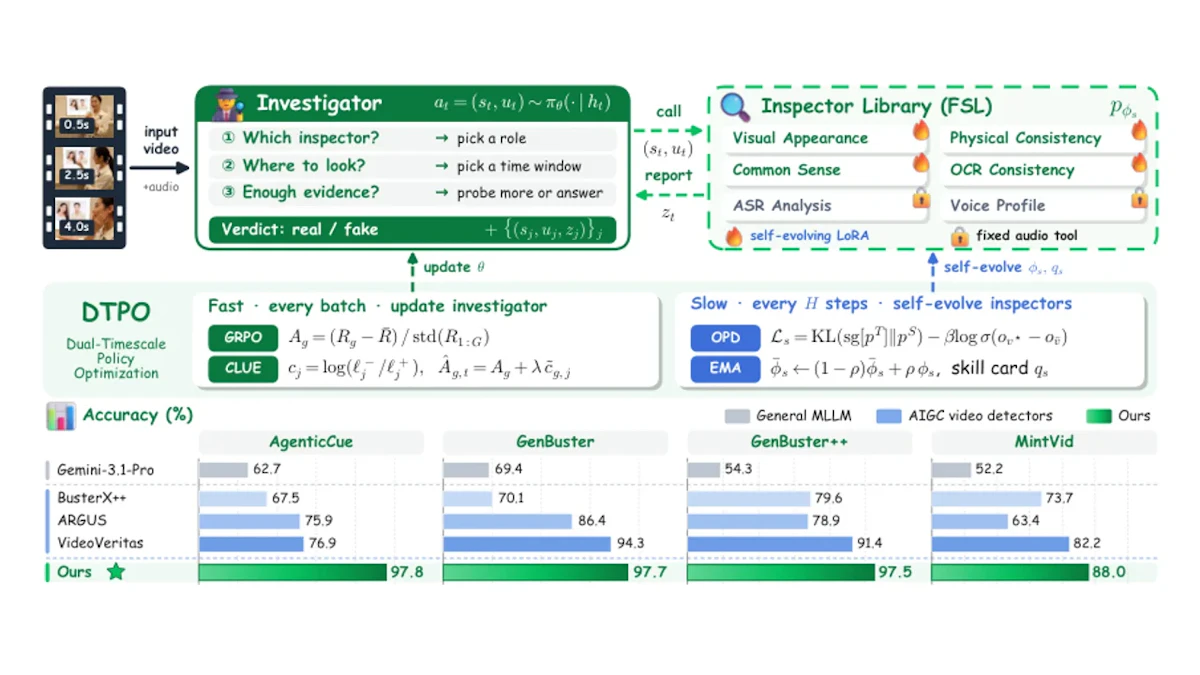
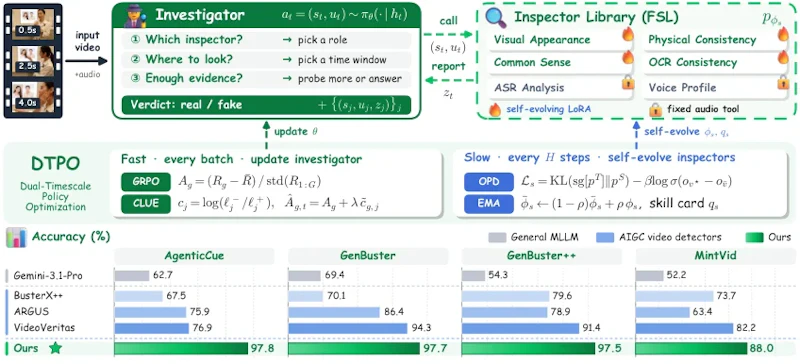
- 主任調査エージェントが視覚・音声の検査サブエージェントを呼び分ける階層型のAI生成動画検出フレームワーク「WeVisForensics」が公開されました
- 調査官を毎バッチ更新し検査器をゆっくり自己進化させる二段時間スケール学習「DTPO」により、4ベンチマーク平均で95.2%の精度を達成しています
- 学習用データセットForenCue-30Kと、検査器の呼び分けの妥当性まで測るベンチマークAgenticCueも同時に整備されました
研究の背景
動画生成モデルの品質向上に伴い、「この動画は生成物か」を根拠付きで判定する技術の必要性が高まっています。単に真偽ラベルを出すだけでは説明責任を果たせず、どのフレームのどの要素が不自然なのかを示す必要があります。
既存手法は大きく2系統に分かれます。1つはChain-of-Thought(思考の連鎖、推論過程を言語で書き出す方式)による一括推論で、動画全体を1回眺めて理由を述べるため、短時間だけ現れる痕跡や画面の一部に限られた破綻を見落としやすいという弱点があります。もう1つは複数エージェントの固定ワークフローで、テクスチャ・照明・動きなど決まった観測を毎回同じ順に実行するため、動画ごとに必要な検査が違っても柔軟に切り替えられません。
調査の進め方(どの痕跡をいつ調べるか)を学習させる発想は以前からありますが、呼び出される専門家側が固定のままでは、検査そのものの精度は上がりません。本研究はこの両方を同時に鍛えることを狙っています。
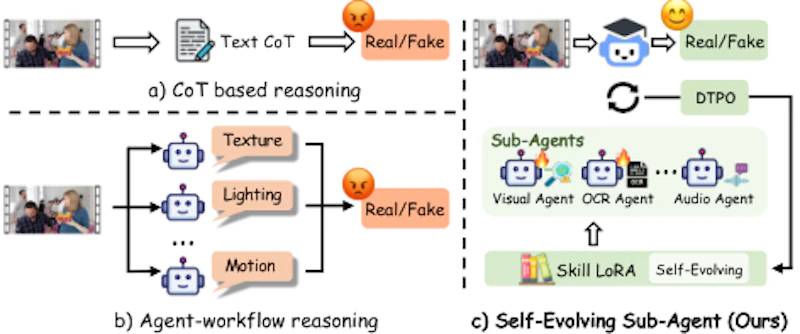
図1は3つの方式の違いを整理したものです。WeVisForensicsはサブエージェントの呼び出しを適応的に決め、さらに本体の方針とサブエージェント自体を一緒に成長させる点が異なります。
調査官と検査器の二層構成
WeVisForensicsは、全体を取り仕切る主任調査エージェント(investigator)と、専門検査を担うサブエージェント群(inspector)の2層で構成されます。調査官は最大16フレームを概観したうえで、どの役割の検査器を、どの時間区間に対して呼ぶかを選び、返ってきた報告を読んで次の手を決め、十分と判断した時点で証拠の連鎖とともに判定を出します。
検査器ライブラリは次の役割で構成されています。
- 視覚的外観(質感の安定性、髪や指先などの細部、残像、照明と影の整合)
- 物理的整合性(人体や物体の運動、物体の永続性、接触、流体の挙動)
- 常識整合性(因果関係、物体の役割、アフォーダンス、出来事の順序)
- 文字整合性(PaddleOCRで文字領域を検出し、歪みや生成由来の劣化を判定)
- 音声(話者属性のプロファイルと、文字起こしのタイミング異常)
各検査器は issue / no_issue / inconclusive の判定、確信度、タイムスタンプ付きの説明を返します。視覚系の4役割は学習対象ですが、音声系の2つとOCRの検出器部分は固定です。モデル本体は Qwen3.5-4B を共有バックボーンとし、調査官と視覚サブエージェントをランク64のLoRAアダプタとして実装しています。
DTPOによる二段学習
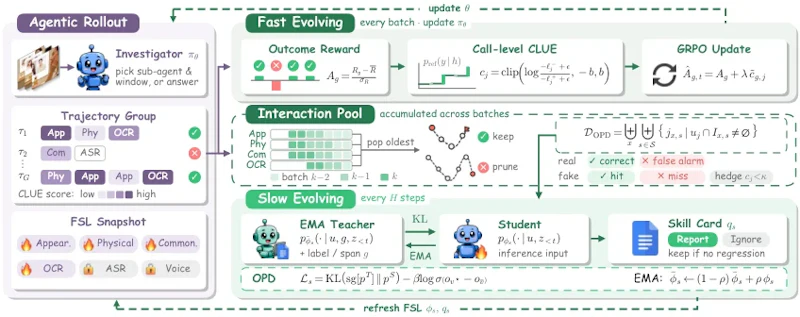
学習戦略のDTPO(Dual-Timescale Policy Optimization)は、更新の速さが異なる2つのプロセスを組み合わせます。速い側ではGRPOで調査官だけを毎バッチ更新し、最終的な正誤に基づく報酬を与えます。無効な軌跡は報酬ゼロとして扱われます。
ここに2つの補助報酬が加わります。CLUE(Call-Level Utility Estimation)は、凍結した参照モデルを使って「その検査呼び出しが正解側の確信をどれだけ押し上げたか」を呼び出し単位で採点する仕組みです。もう1つはツール網羅性の報酬で、その動画が本来必要とする役割の集合と、実際に呼んだ役割の集合とのF1を見ます。
遅い側では、注釈された痕跡区間と重なった呼び出しを役割ごとに蓄積し、ラベルや区間を見られる特権教師(EMAで更新)から生徒へ知識を蒸留します。さらに反省役のLLMが各検査器の指示文に追記する「スキルカード」(Report/Ignoreの短い規則集)を提案し、既存の正解を失わずに新たな正解を増やす場合のみ採用します。検査器の更新は調査官20ステップごとに反映され、毎ステップ更新や段階式より良い結果になりました。
学習データと新ベンチマーク
学習基盤となるForenCue-30Kは、3万本の動画に役割別の痕跡注釈を付け、検査器単体の記録117,552件と調査軌跡33,896件、さらに強化学習用の7,500行のプールを備えています。役割別の注釈数は常識40,246件、物理32,348件、外観26,378件、OCR 18,580件です。元データはGenBuster-200K、VBench-2.0、OpenVid-1M、Koala-36Mなどから集められています。注釈はVLMが付与し、人手監査では340件のうち99.1%が視覚的に裏付けられ、軌跡100件のうち96.0%が適切なツールを使っていたと報告されています。
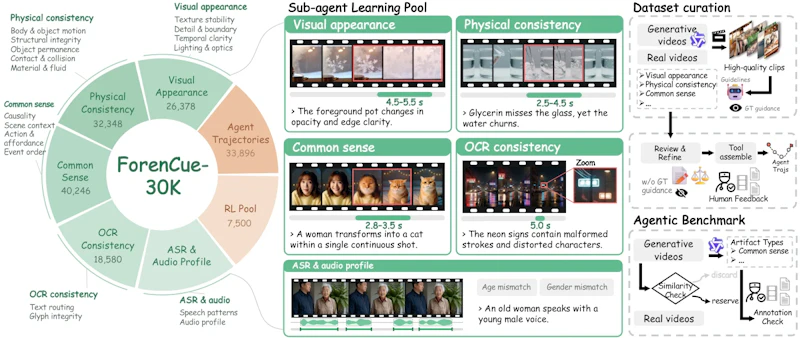
評価側ではAgenticCueを新たに用意しています。視覚・物理・OCR・常識・音声の5カテゴリそれぞれに生成動画500本と実動画500本を揃え、新しい商用生成モデルの出力に加え、学習に使っていないデジタルヒューマンや顔入れ替え、音声不一致の偽造も含みます。評価指標は二値判定の精度と、呼び出しが本当に必要な役割に一致していた割合(invocation precision)の2つです。どの動画にも常に同じツールを呼ぶ素朴な戦略の一致率は、視覚91.1%から音声21.5%まで大きく開くため、呼び分けの質が測れる設計になっています。
実験結果
主要な比較結果は以下の通りです。MintVidとAgenticCueの列は各カテゴリ・各生成モデルの報告値の平均です。
手法 | GenBuster | GB++ | MintVid平均 | AgenticCue平均 | 全体平均 |
|---|---|---|---|---|---|
VideoVeritas | 94.3 | 91.4 | 82.2 | 76.9 | 86.2 |
ARGUS | 86.4 | 78.9 | 63.4 | 75.9 | 76.2 |
WeVisForensics(DTPO) | 97.7 | 97.5 | 88.0 | 97.8 | 95.2 |
全体平均95.2%は、最も強い既存手法のVideoVeritasを9.0ポイント上回る値です。差が最も大きかったのは音声カテゴリで27.7ポイントの開きがありました。BusterX++は72.7、DeepTraceRewardは62.9、汎用の大規模モデルQwen3.5-397Bは65.7にとどまり、専用の二値分類器2種は48.7と57.0という結果でした。動画生成AI比較2026、Gemini Omni・Kling 4.0・Runwayを用途別に解説で触れた最新世代の生成モデルの出力に対しても、Seedance 98.6、Kling 89.6のように高い精度を保っています。一方でSora2では82.4と相対的に低く、生成モデルによって難易度の差が残ることも示されました。
構成要素ごとの寄与も報告されています。教師あり学習のみでは91.3、検査器を凍結したままGRPOを行うと93.2、CLUEを足して93.7、CLUEなしのDTPOで94.8、完全なDTPOで95.2という順に改善しました。調査官と検査器のどちらか一方だけを進化させた場合は92.0と93.2にとどまり、両方を同時に鍛える意味があったことが裏付けられています。サブエージェント単体の証拠F1も、物理役割ではライブラリ進化により66.5から97.8へ上がりました。
限界と今後の展望
有効性は示されたものの、制約もいくつか残ります。音声ツールとOCRの検出器部分は固定のままで、偽造音声のラベルが乏しいことが理由として挙げられており、これらの誤りは学習で補正できません。注釈の大部分はVLMが生成し、人手検証は340件と100件の抜き取りに限られています。
また検査器の更新間隔を20ステップにする設定が結果に影響しており、別の規模や領域で同じ値が最適とは限りません。AgenticCueは著者らが構築した分割で評価されているため、第三者による追試が今後の判断材料になるでしょう。推論コストの報告がない点も実運用を考える際には気になるところです。学習時には1軌跡あたり最大4回の検査呼び出しを許し、監査した100軌跡では平均2.1回が使われていました。
とはいえ、判定を局所的な証拠に結び付けながら、調査の方針と検査の腕前を同時に鍛えるという設計は、生成動画の検出だけでなくマルチモーダルなエージェント設計にも応用の余地があります。コードやデータの公開範囲が広がれば、検証と改良が進むはずです。
論文情報: "WeVisForensics: Self-Evolving Agent for Omni AI-Generated Video Detection"(Yipeng Du et al., 2026) arXiv:2611.21373, CC BY 4.0
本記事の図(図1〜図4)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


