 AI-Papers
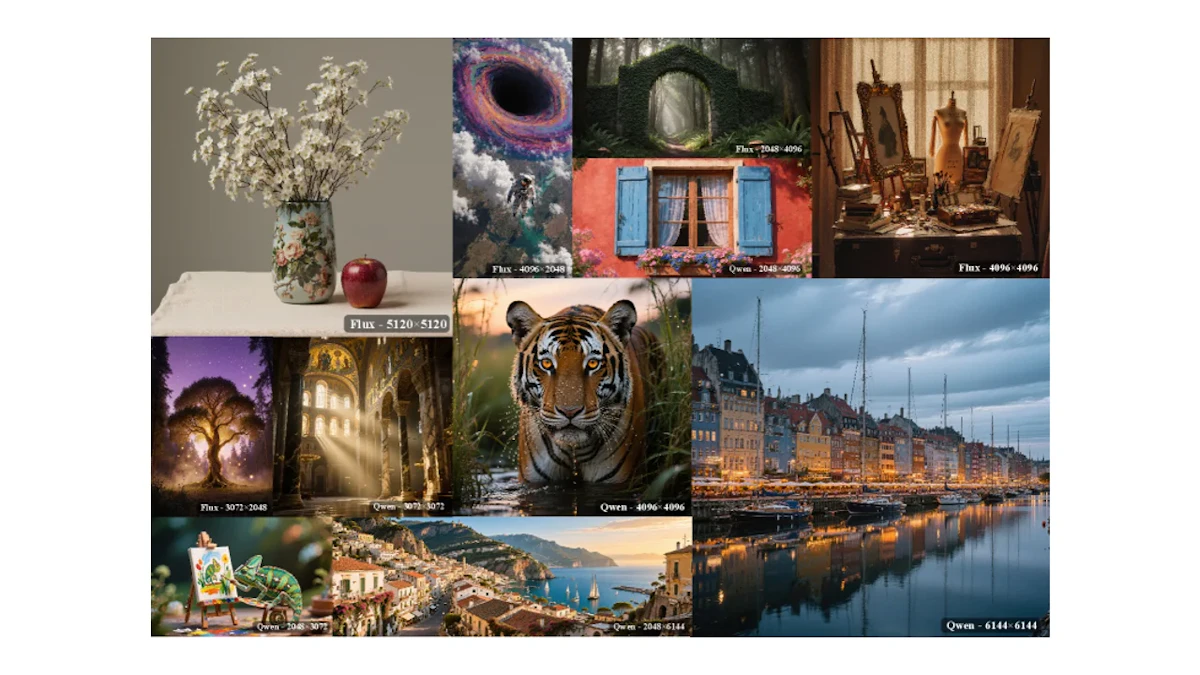
- 潜在空間のスペクトルエネルギーを解析し、RoPEを動的にスケーリングすることで大域構造の崩壊と細部の劣化を同時に解決
- 追加学習なしでFlux・Qwenモデルに即座に適用でき、4096²解像度でImageRewardが既存手法比約2倍の1.26を達成
- 6144²までの極高解像度や非正方形アスペクト比にも対応し、既存手法が破綻する条件でも安定した生成が可能
研究の背景
FluxやStable Diffusion 3(SD3)に代表されるDiT(Diffusion Transformer、拡散トランスフォーマー)ベースの画像生成モデルは、近年急速に品質が向上しています。これらのモデルは学習時に使った解像度(通常1024²程度)では高品質な画像を生成できますが、それを超える解像度での生成を試みると、画像全体の構造が崩れたり、細部のテクスチャが失われたりといった問題が生じます。
この原因は、モデルが利用する位置情報の符号化方式にあります。DiTで広く採用されているRoPE(Rotary Position Embedding、回転位置エンコード)は、学習時の解像度を前提に設計されているため、より大きな解像度の位置インデックスが入力されると、未知の範囲を処理することになり品質が劣化します。
近年の研究では、推論時にRoPEのスケーリングを調整することで追加学習なしに解像度外挿を試みる手法が登場しました。しかし、いずれも固定された係数を全成分に一律に適用するため、構造保持と細部再現のトレードオフを十分に制御できていません。
固定スケーリングの限界
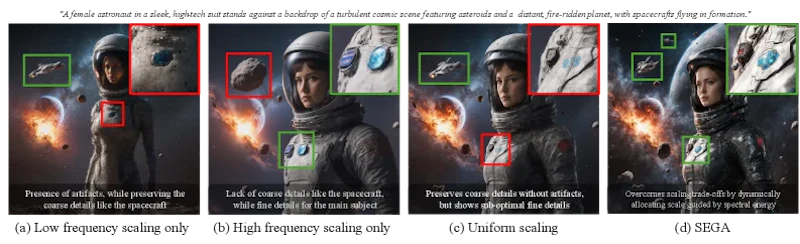
問題の核心は、RoPEの各成分が担う役割の違いにあります。低周波成分は画像全体のレイアウトや物体の配置といった大域的な構造を支え、高周波成分は輪郭やテクスチャといった細部を支えます。この二種類の成分に対して単一のスケーリング係数を適用すると、次のような二律背反が生じます。
スケーリングを大きくすると大域構造は安定しますが、高周波成分が過剰に引き伸ばされ細部が失われます。逆に小さくすると細部は残るものの、大域構造が崩壊して意味のある画像にならなくなります。この根本的なトレードオフを一つの固定値では解決できないことが、既存手法の共通した限界です。
SEGAの仕組み
SEGA(Spectral-Energy Guided Attention)は、この問題をノイズ除去の各ステップで潜在表現の空間周波数構造をリアルタイムに分析し、RoPEの各成分に対するスケーリングを動的に割り当てることで解決します。追加学習は一切不要で、既存モデルの推論時に差し込むだけで機能します。
仕組みは次の3つの要素から構成されます。
- 基準スケール(mref): 目標解像度と学習解像度の比から、スケーリング全体の基準値を算出する
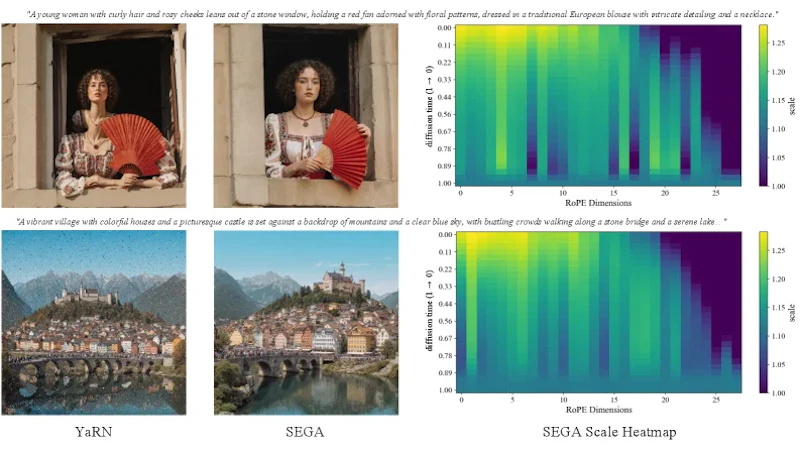
- 次元別補正(sd): 潜在空間に2次元高速フーリエ変換を適用し、各RoPE次元が担う周波数帯のエネルギーに応じて係数を個別に調整する
- グローバル振幅係数(σ): スペクトル平坦性(Wiener entropy、周波数成分の散らばり具合を表す指標)から、スケーリング強度全体を画像の内容に合わせて制御する
この組み合わせにより、低周波成分には大域構造の安定に必要な高いスケーリングを、高周波成分には細部再現に適した低いスケーリングをそれぞれ動的に割り当てられます。さらにノイズ除去の進行に伴い潜在表現のスペクトル分布も変化するため、SEGAは各ステップで独立してスケーリングを更新します。
実験結果
Fluxモデルを用いた4096²解像度での定量評価では、SEGAは3つの指標すべてで比較対象を上回りました。なお、比較対象として挙げた手法は指標ごとに異なり、それぞれの指標で代表的な既存手法の値を並べています。
指標 | SEGA | 比較対象 | 比較対象の手法 |
|---|---|---|---|
ImageReward | 1.26 | 0.66 | NTK+固定スケーリング |
FID | 150.05 | 183.33 | ベースライン |
CLIP Score | 29.22 | 28.79 | DyPE |
ImageRewardは人間の主観的評価に近い指標で、SEGAは約2倍の改善を示しました。FIDは生成画像の分布の品質を測る指標で、値が小さいほど良好です。CLIP Scoreはテキストとの整合性を示し、いずれの指標でも一貫した優位性が確認できます。
定性的な比較でも、YaRN・DyPE・UltraImage・HiFlowなどの先行手法と比べ、SEGAは大域構造の一貫性と細部の忠実度を両立した出力を生成できています。PixVerveのような高解像度生成アプローチとは異なり、SEGAは既存のアーキテクチャに変更を加えず推論時の処理のみで高解像度化を実現している点が特徴です。
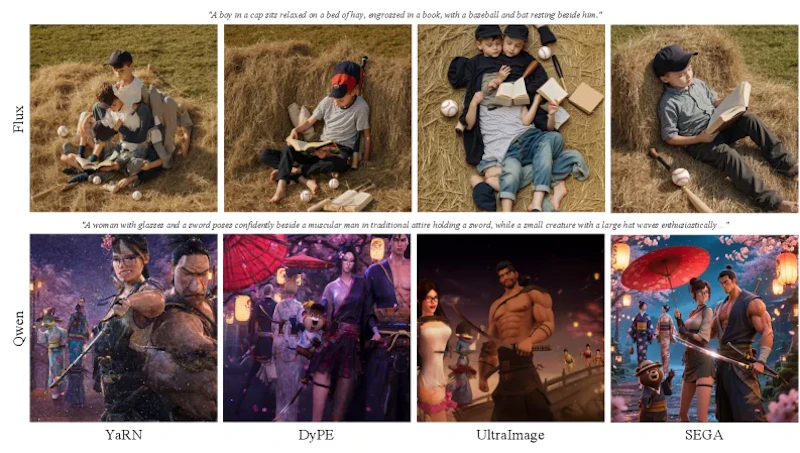
また4096²だけでなく5120²・6144²という極高解像度でも有効に機能し、他手法がノイズや構造崩壊に陥る条件でも安定した生成が確認されています。非正方形のアスペクト比(2048×4096、4096×2048)においても物体の形状を適切に保持しており、実用的なシナリオへの対応力も示されました。
まとめ
SEGAは、周波数解析という信号処理の観点をアテンションスケーリングに組み込み、固定スケーリングでは解決できなかった構造保持と細部再現のトレードオフを動的に制御します。追加学習なしに既存のDiTモデルへ即座に適用できる実用性と、コンテンツに応じた適応的なスケーリングという技術的な独自性を併せ持つ手法です。
現時点ではFluxとQwenモデルでの検証に限られますが、同様のRoPEベースアーキテクチャを持つ他のモデルへの応用可能性も高く、高解像度生成を既存モデルで手軽に実現したい場面での有力な選択肢になり得ます。スペクトル分析の計算コストが推論全体にどの程度影響するかといった実運用上の詳細は、今後の検証に委ねられています。
論文情報: "SEGA: Spectral-Energy Guided Attention for Resolution Extrapolation in Diffusion Transformers"(Javad Rajabi et al., 2026) arXiv:2605.22668, CC BY 4.0
本記事の図(図1〜図3)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。

