 AI-Papers
- CLIPやSigLIPの対比学習エンコーダを廃し、テキスト専用LLMを初期化源とするPenguin-Encoderで、従来手法の目的不一致問題を根本から解消
- DocVQA(94.1点)やChartQA(86.6点)など文書・OCR系ベンチマークでQwen3-VL-2Bを上回り、EgoSchema(57.6点)など動画理解でも優位
- 2Bおよび8Bの軽量モデルとしてスマートフォン・エッジデバイスへの展開を想定、Tencent AILabがGitHubとHugging Faceでコードを公開
研究の背景
視覚言語モデル(VLM)の多くは、CLIPやSigLIPと呼ばれる対比学習(Contrastive Learning)で事前学習されたビジョンエンコーダを採用しています。対比学習とは、類似した画像とテキストのペアを近づけ、異なるペアを遠ざけることで視覚表現を獲得する手法です。GPT-4oやQwen-VLをはじめとする主要VLMはほぼ例外なくこの設計を踏襲しており、事実上の標準となっています。
しかしTencent AILabの研究チームは、この慣行に根本的な問題を見出しました。対比学習は「識別」を目的として最適化されるため、カテゴリレベルの粗い不変性を学習します。たとえば「同じ犬は異なる背景でも同じ表現になるべきだ」という方向性です。
この性質が、OCR・文書解析・密集したキャプション生成・複雑な多段階推論といったタスクに必要な細粒度の視覚情報を抑制してしまいます。
さらに問題となるのは、現在のVLM研究がモデルの巨大化という解決策に傾きがちな点です。数十億から数百億パラメータへのスケールアップは性能向上に効果的ですが、スマートフォンやロボットといった計算資源が限られたエッジデバイスへの展開を著しく困難にします。本研究では「ビジョンエンコーダ自体を再設計することで、2Bや8Bのコンパクトな規模のまま性能限界を押し上げられるか」という問いに正面から取り組んでいます。
提案手法の核心
Penguin-VLの中心となるアイデアは、ビジョンエンコーダをCLIPのような対比学習から始めるのではなく、テキスト専用のLLM(Qwen3-0.6B)から初期化するという逆転の発想です。このエンコーダを「Penguin-Encoder」と呼びます。LLMはすでに豊かな言語表現空間を持っており、VLMの言語バックボーンと同じ表現空間から出発することで、視覚情報と言語情報の整合が自然に取りやすくなります。
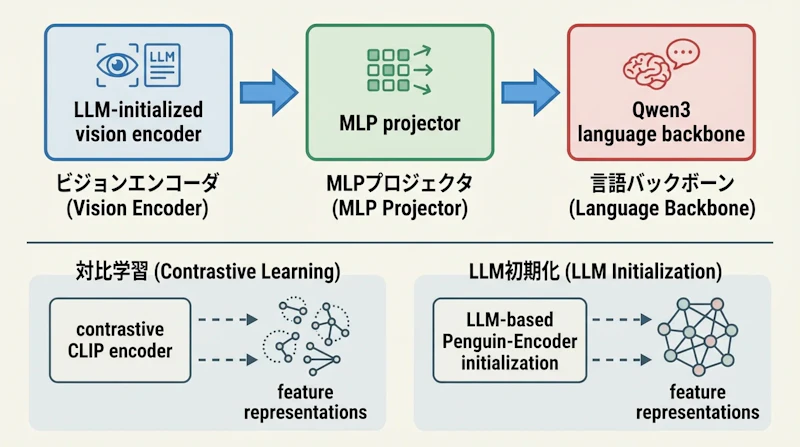
テキスト専用LLMをビジョンエンコーダとして機能させるために、構造的な改変を施します。まず、LLMが持つ因果的注意機構(Causal Attention)を双方向注意機構(Bidirectional Attention)に変換します。テキスト生成では未来のトークンを参照できないよう因果マスクを使いますが、画像特徴の抽出では全ピクセルを相互参照できる双方向構造が適しています。次に、位置エンコーディングとして2D-RoPEを追加し、可変解像度の視覚トークンに対応できるようにしました。
構造改変後の訓練プロセスは段階的に設計されています。まず「混合監督事前学習」として、再構成・蒸留目的の損失関数(振幅損失・方向損失・関係損失の3種)を用いてエンコーダに視覚知識を安定的に注入します。この段階では大規模な画像キャプションデータを使って視覚情報を言語表現空間へと適応させます。
続いて高解像度画像との整合フェーズへ移行し、その後「低解像度から高解像度へ」のカリキュラム学習と指示チューニングを組み合わせた統一レシピで画像と動画の両能力をバランスよく獲得させます。
動画に対しては「Temporal Redundancy-Aware(TRA)トークン圧縮」を導入しています。動画の連続フレームには類似した情報が大量に含まれるため、キーフレームと中間フレームに対してトークン割り当て量を動的に調整し、グローバルなトークン予算内で長時間動画を効率的に処理できます。
実験結果
Penguin-VL-2BをQwen3-VL-2BやInternVL3.5-2Bなど同規模の競合モデルと比較した結果、文書理解・OCR・動画理解の各分野で明確な優位性が確認されました。Qwen3-VL-2Bとの主なスコア比較は次の表のとおりです。
ベンチマーク | Penguin-VL-2B | Qwen3-VL-2B |
|---|---|---|
DocVQA | 94.1点 | 93.3点 |
ChartQA | 86.6点 | 76.9点 |
InfoVQA | 77.8点 | 72.4点 |
EgoSchema | 57.6点 | 55.7点 |
LongVideoBench | 59.5点 | 52.1点 |
Perception Test | 70.4点 | 64.5点 |
NextQA | 79.9点 | 76.9点 |
AI2D | 80.7点 | 76.9点 |
RealWorldQA | 70.2点 | 63.9点 |
OCRBench | 810点 | 858点 |
MathVerse | 35.9点 | 52.1点 |
文書理解とチャート理解、動画理解の各項目ではPenguin-VL-2Bが上回り、一般知識・推論系のAI2DやRealWorldQAでも差をつけました。一方でOCRBenchやMathVerseではQwen3-VLが高スコアを記録しており、タスクによって得手不得手が存在することも論文は率直に報告しています。
アブレーション実験では、Penguin-Encoderが一貫して対比学習ベースのエンコーダを上回り、細粒度の空間・時間的手がかりをより豊かに保持することが確認されています。この結果は「性能向上の主因はモデルサイズではなく視覚表現の質にある」という論文の主張を裏付けるものです。
まとめと今後の展望
Penguin-VLは、VLM設計の「常識」だったCLIP系エンコーダを廃し、LLM初期化という異なる出発点を選んだ意欲的な研究です。文書・OCR・動画理解において2Bの軽量規模でQwen3-VLと同等以上の性能を達成したことは、エンコーダ設計の再考がもたらす効果の大きさを示しています。
類似したマルチモーダル推論の課題に取り組む研究として、ThinkOmniは訓練不要でオムニモーダルLLMの推論能力を強化するアプローチを提案しており、エンコーダ再設計とは異なる角度からVLMの可能性を広げています。
今後の課題としては、訓練コードと訓練データの公開(現時点ではTODO状態)、さらなる大規模モデルへの適用検証が挙げられます。また、対比学習エンコーダが得意としていたOCRBench等での追いつきも研究的な関心となるでしょう。Penguin-Encoderがドロップイン代替として既存VLMパイプラインに広く採用されるかどうかが、この手法の長期的な影響を測る指標になりそうです。


