 AI-Papers
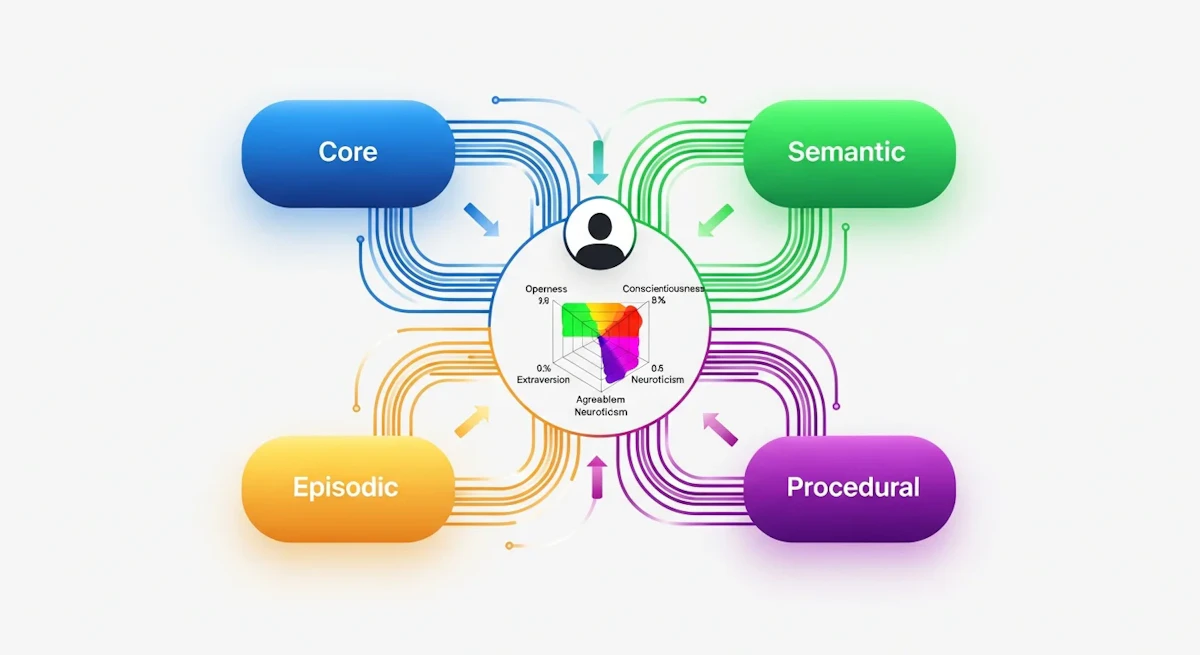
- 4種類のメモリとBig Five性格モデルで時間とともに進化するユーザープロファイルを構築し、Persona-MMEベンチマークで既存手法比22.4%向上を達成
- FAISS類似検索・CLIP視覚検索・時間フィルタリングを組み合わせた複合メモリ検索と、SFT+GRPOの2段階学習でパーソナライズ応答を実現
- CVPR 2026採択。GPT-4oを5.2%上回り、7側面・14タスクの新ベンチマークPersona-MMEで再現性の高い実装を公開
研究の背景と課題
ChatGPTやGeminiのようなマルチモーダルLLM(Large Language Model)は、画像とテキストを統合処理する能力において急速に進歩しています。しかし既存の手法には根本的な限界がありました。ユーザーへの応答が「その会話セッション限りのカスタマイズ」に留まり、会話を重ねるほど相手への理解が深まるという人間同士のコミュニケーションの本質を再現できていなかったのです。
具体的には、既存のパーソナライズ手法は単一ターンの好み反映か、限られたプロファイル情報の埋め込みにとどまっています。ユーザーの趣味が変化した、過去に話した出来事を踏まえて返答してほしい、といった長期的かつ動的なパーソナライゼーションには対応できていませんでした。
南京大学らの研究チームはこの課題に正面から取り組み、PersonaVLMとして解決策を提案しました。CVPR 2026に採択された本研究は、記憶・推論・応答整合の3機構を統合したフレームワークです。
PersonaVLMの全体アーキテクチャ
PersonaVLMは応答ステージ(Response Stage)と更新ステージ(Update Stage)の2段階で動作します。応答ステージでは、ユーザーのクエリと過去の対話コンテキストをもとにメモリデータベースを検索し、パーソナライズされた回答を生成します。更新ステージでは、会話終了後にその内容を分析して記憶を更新し、ユーザープロファイルを洗練させます。
ベースモデルにはQwen2.5-VL-7Bを採用しており、128kトークンの長大なコンテキストウィンドウを活用することで、過去の長期的なやり取りを処理できます。このオープンソースモデルをベースにした点が、研究の再現性を高めています。
4種類のメモリとBig Five性格モデル
PersonaVLMが独自に設計したのが、人間の記憶研究に基づく4種類のメモリ分類です。それぞれ格納する情報の性質が異なります。
- コアメモリ: ユーザーの基本属性(年齢・性別・好み)
- セマンティックメモリ: 特定のイベントに依存しない抽象的な知識や概念
- エピソディックメモリ: タイムスタンプ付きの具体的な対話イベント
- 手続きメモリ: ユーザーの目標や日常的な習慣
この4層に情報を振り分けることで、単発の好み反映にとどまらないユーザー像を保持できます。
加えて、LLMの強化学習における記憶活用に通じる概念として、PersonaVLMはBig Five性格特性(開放性・誠実性・外向性・同意性・神経症性)を5次元ベクトルで表現します。このパーソナリティプロファイルは指数移動平均(EMA)を使って動的に更新されます。
「ユーザーが最近よりリスク志向になった」「好みが変化した」といった変化を、数値として継続的に追跡できる仕組みです。記憶の追加・更新・削除にはCRUD操作を用い、セッション終了後に自動的に処理されます。
複合メモリ検索の仕組み
蓄積した記憶を正確に引き出すため、PersonaVLMは複数の検索戦略を組み合わせています。テキスト記憶の検索では、All-MiniLM-L6-v2エンコーダで記憶をベクトル化し、FAISSによる高速近傍探索を実施します。視覚的な情報に対しては、Grounding DINOで対象物体を抽出したうえでCLIP埋め込みを用いて関連する視覚記憶を検索します。
さらに、ユーザーが時間範囲を指定したクエリ(「先月話していたこと」など)に対応するタイムフィルタリング機能も備えました。この複合検索により、「先週見た映画の感想を踏まえておすすめを教えて」といった、テキストと視覚情報と時系列を統合した複雑なパーソナライズ要求に応えられます。
モデルは構造化出力形式で推論プロセス・記憶内容・キーワードを生成し、どの記憶を参照したかを透明性をもって示す設計になっています。
2段階学習:SFTとGRPO強化学習
PersonaVLMの学習は2段階で構成されています。第1段階では7万8千件のサンプルを用いた教師あり微調整(SFT)により、パーソナライズ応答の基礎能力を習得させます。第2段階ではGRPO(Group Relative Policy Optimization)という強化学習手法を採用し、応答品質をさらに磨き上げます。
GRPOの報酬関数は「精度・一貫性・フォーマット準拠」を組み合わせた複合スコアで、評価にはQwen3-30B-A3Bがジャッジモデルとして機能します。DPOやRLHFとは異なり、GRPOはグループ内の相対的な優劣を学習シグナルとして利用することで、安定した訓練を実現しました。
この2段階アプローチにより、単なる記憶の引き出しにとどまらず「そのユーザーらしい応答」を生成する整合能力が獲得されます。
Persona-MMEベンチマークの設計
従来のベンチマークは静的なパーソナライゼーション能力の評価にとどまっており、長期的な記憶や時間的変化への対応を測れませんでした。そこで本研究では、7つの評価観点・14のタスク・2,034件の対話ケースから構成される新ベンチマークPersona-MMEを構築しました。
7つの評価観点は「メモリ(視覚詳細・セマンティック情報の想起)」「インテント(明示的・暗黙的意図推論)」「嗜好(最新嗜好認識・興味進化・推薦)」「行動(パターン認識・長期目標追跡)」「関係(関係認識・動態理解)」「成長(説明の段階化・新シナリオへの一般化)」「整合(パーソナリティ整合性)」です。200通りのペルソナを設定し、32kおよび128kの2種類のコンテキスト設定で評価しています。
実験結果
Persona-MMEにおいて、PersonaVLMは既存手法の平均を上回り、商用モデルのGPT-4oに対しても優位性を示しました。PersonaMemという既存ベンチマークでも向上を達成しています。主な差は次の表のとおりです。
ベンチマーク | 比較対象 | PersonaVLMの優位性 |
|---|---|---|
Persona-MME | 既存手法の平均 | +22.4% |
Persona-MME | GPT-4o | +5.2% |
PersonaMem | 既存手法 | +9.8% |
比較対象にはGPT-4o・GPT-5・Gemini-2.5-Flash・Claude-3.7といった商用モデルに加え、Qwen2.5-VL-7B・InternVL3-8B/38B・OneVision-1.5-8Bなどのオープンソースモデルが含まれます。7Bクラスのオープンソースモデルが38Bの大規模モデルや最新商用LLMを凌駕したという結果は、パーソナライズ能力においては単純なモデルスケールより設計の工夫が効くことを示しています。
まとめと今後の展望
PersonaVLMは、4種類のメモリ構造・Big Five性格ベクトル・複合検索・2段階学習という要素を組み合わせることで、長期的に進化するパーソナライズドAIアシスタントの実用的な設計指針を示しました。Qwen2.5-VL-7Bをベースとした実装と、詳細が公開されたPersona-MMEベンチマークにより、研究の再現・発展がしやすい点も評価されています。
一方で課題も残ります。記憶の蓄積量が増えるにつれてメモリ管理のコストが高まる問題、プライバシー保護の観点からどこまでユーザー情報を記憶すべきかという倫理的検討、さらには複数のユーザーが同一システムを共有する場合の記憶分離が今後の研究テーマとなるでしょう。パーソナライズドAIの実用展開において、本研究は土台となる成果です。


