 AI-Papers
- 文書をページ画像としてレンダリングし、凍結したビジョンエンコーダで約100個の視覚トークンに符号化するRAG手法「OpticalRAG」が提案されました
- クエリ条件付きのcross-attentionで検索結果を16トークンまで蒸留し、LongBench-v2でバックボーンを5.17ポイント上回りました
- 対比学習なしでテキストクエリから視覚トークンを引けるEncoder-Bridged Retrievalを採用し、NeurIPS 2026に採択されています
研究の背景
Retrieval-Augmented Generation(RAG、検索拡張生成)は、外部文書を検索して大規模言語モデル(LLM)の入力に加える手法です。精度は上がりますが、長い文書をそのまま文脈に詰め込むと計算コストが跳ね上がります。
そこで従来は、テキストを間引いたり要約したりして短くする方法が使われてきました。Selective ContextやLLMLingua-2のようなトークン枝刈り系の手法は、圧縮率を上げるほど細かい情報が永久に失われます。逆にxRAGのように文書1つを1個の密ベクトルへ押し込む手法は、文書内の細部が潰れてしまいます。
中国人民大学の研究チームによる論文「OpticalRAG: Pixel-Space Compression for Token-Efficient Retrieval-Augmented Generation」は、この制約の正体を情報密度ではなく圧縮のモダリティにあると捉え直しました。1次元のテキスト列を縮める代わりに、2次元の画素空間で圧縮するという発想です。
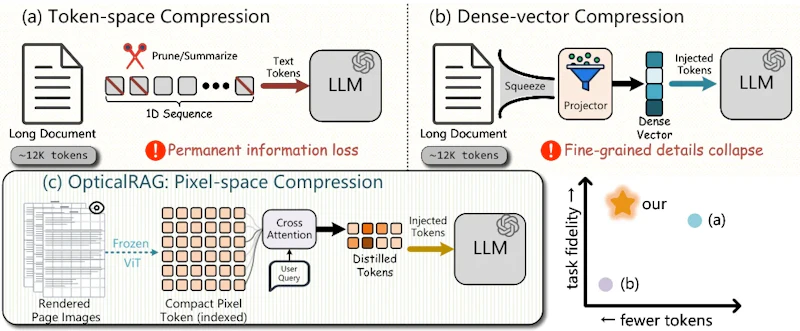
図1は3つのアプローチの違いを並べたものです。(a)と(b)がいずれも情報の損失を伴うのに対し、(c)のOpticalRAGはページを画像として保持したうえで、クエリに応じて必要な部分だけを少数のトークンに絞り込みます。
提案手法
OpticalRAGは3つの段階で構成されます。図2がその全体像です。
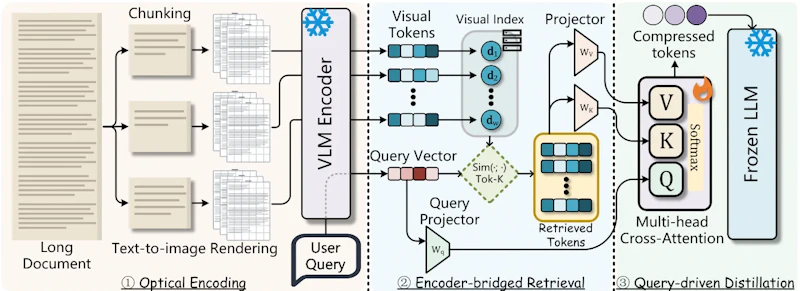
第1段階の光学符号化(Optical Encoding)では、文書を一定の窓に区切り、固定解像度のページ画像としてレンダリングします。フォントサイズや余白、行間を調整することで、1枚あたりの情報密度を制御できる点が特徴です。画像はSAMとCLIPの特徴を組み合わせたDeepEncoder系のアーキテクチャで符号化され、1ページがおよそ100個の視覚トークンになります。各視覚トークンは個別に索引化されます。
第2段階のEncoder-Bridged Retrievalでは、凍結したLLMから取り出したクエリの隠れ状態を、学習した射影行列によって視覚特徴の空間へ写します。その後は内積で索引を検索し、上位K個の視覚トークンを取り出すだけです。テキストと画像を揃えるための対比学習(contrastive learning)を別途行う必要がなく、しかもこの射影行列は後段の圧縮器と共有されます。実装の負荷が軽いのは実用上の利点でしょう。
第3段階のクエリ駆動蒸留(Query-Driven Distillation)では、学習可能な圧縮クエリをcross-attention層に通し、検索された視覚トークン群を少数のトークンへまとめます。出力はMLPでLLMの埋め込み空間に写され、ソフトプレフィックスとして与えられます。注目したいのは、ここで最終的に注入されるトークン数がわずか16個という点です。
学習は2段階です。まずWikipediaとC4で再構成を学ばせ、次にSQuAD v2、DROP、CoQAでタスク適応の微調整を行います。ビジョンエンコーダとLLMは終始凍結されており、学習対象は検索の射影と圧縮モジュールだけです。視覚トークンを情報の単位として扱うという考え方は、dNaViTとは?離散視覚トークンで理解・生成・編集を統一する新手法とも通じるところがあります。
論文は理論面でも裏付けを示しています。必要な圧縮トークン数は候補トークンの総量ではなく、クエリ条件付きで見た回答分布の内在次元に依存するという主張です。つまり検索対象が増えても、注入トークンを比例して増やす必要はないということになります。
実験結果
評価にはLongBench-v2(503問)、BAMBOO、LooGLE-v2の選択式問題が使われ、バックボーンはQwen2.5-7B-Instructです。評価指標には精度と注入トークン数を組み合わせたCAP(compression-aware accuracy)が導入されました。これは閉じた本の状態(文書なし)のスコアを上回った場合にのみ、トークン数の少なさに応じた補正をかける指標です。
手法 | LongBench-v2 | 注入トークン数 | 平均CAP |
|---|---|---|---|
バックボーンのみ | 30.62 | 0 | 36.04 |
Standard RAG | 31.41 | 1622.68 | 46.63 |
Selective Context | 32.40 | 5511.73 | 43.99 |
LLMLingua-2 | 28.23 | 2669.19 | 44.58 |
xRAG | 26.24 | 1 | 36.59 |
RECOMP | 32.01 | 6953.93 | 45.96 |
OpticalRAG | 35.79 | 16 | 55.67 |
OpticalRAGは3つのベンチマークすべてでCAPが最良となり、平均CAPは55.67に達しました。LongBench-v2では素のスコアでもバックボーンを5.17ポイント上回り、数千トークンを注入する既存手法を16トークンで超えています。LooGLE-v2でも素のスコアが最高でした。
一方でBAMBOOでは、RECOMP(75.50)やLLMLingua-2(73.50)がOpticalRAG(61.00)より高い素のスコアを出しています。論文は精度と効率の両立という観点で優位性を主張していますが、素の精度だけを求める場面では既存手法が勝つケースがあるという点は押さえておくべきでしょう。xRAGのLooGLE-v2のCAPが高く見えるのも、1トークンという極端な予算による補正の影響で、素のスコアはバックボーン近辺にとどまっています。
注入トークン数のアブレーションでは、16個が最も良く、32個にすると大きく落ち込み、64個で部分的に回復するという非単調な傾向が報告されました。また圧縮方法の比較では、クエリ駆動が35.57、平均プーリングが32.16、ランダム射影が31.67となり、クエリに条件付けることの寄与が確認されています。
まとめと今後の展望
OpticalRAGは、テキストを縮めるのではなくページ画像として符号化するという切り口で、RAGのトークン予算の問題に答えを出しました。対比学習を必要としない検索機構と、凍結モデルを前提とした軽量な学習構成は、既存システムへの組み込みも比較的容易と考えられます。
限界として著者自身が挙げているのは、固定サイズのプレフィックスでは、文書の離れた複数箇所から証拠を集める必要のある質問に対応しきれない可能性です。評価も選択式QAに限られており、自由記述の生成や、クエリに応じてプレフィックス長を変える仕組みは今後の課題として残されています。コードはGitHubで公開されています。
論文情報: "OpticalRAG: Pixel-Space Compression for Token-Efficient Retrieval-Augmented Generation"(Senhao Liu et al., 2026) arXiv:2611.13675, CC BY 4.0
本記事の図(図1〜図2)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


