 AI-Papers
- Meituan LongCat チームが、任意解像度の画像を離散トークン列に変換する視覚トークナイザー dNaViT を公開しました
- 凍結した Qwen3-VL ViT の上に軽量な ResMod とグループ化 Product Quantization を載せ、系列長を伸ばさずに表現容量を拡張します
- 1024×1024 の再構成で PSNR 32.90dB、線形プローブ 79.47%、OCRBench 885 など再構成・理解・生成・編集を同じ語彙でカバーします
研究の背景
言語モデルは、文章を有限個の離散トークンに分解し、次のトークンを予測するという単純な枠組みだけで幅広いタスクをこなしています。一方で画像の扱いは分かれたままです。画像理解には連続値の特徴ベクトルを使うエンコーダが用いられ、画像生成には別の離散トークナイザーや拡散モデルが使われるのが一般的でした。
この分断には実務的な代償があります。理解と生成を1つのモデルにまとめようとすると、入力用の表現と出力用の表現を別々に持つ必要があり、学習も推論も複雑になります。そこで本研究は「有限の離散語彙だけで視覚情報を汎用的に表せるのか」という問いを立てました。
著者らが提案する dNaViT(Discrete Native-resolution Vision Transformer) は、任意の解像度・アスペクト比の画像を離散的な視覚プリミティブの列に変換し、その同じコードから再構成・理解・生成・編集の4領域をまとめて扱うトークナイザーです。arXiv に技術報告が公開され、コードと重みは GitHub と Hugging Face で入手できます。
dNaViTの仕組み
設計の出発点は「ゼロから学習し直さない」という判断です。約400Mパラメータの Qwen3-VL ViT を事前学習済みのまま凍結し、その上に約100Mパラメータの ResMod(Residual Modulator) だけを追加して学習させます。ResMod は浅い層と深い層の中間特徴を軽量な self-attention と feed-forward で融合し、最終的な意味特徴に対してトークンごとのスケールとシフトを予測します。
この affine ヘッドはゼロ初期化されているため、学習開始時点では事前学習特徴をそのまま通す恒等写像として振る舞います。意味情報を壊さずに、再構成に必要な低レベルの手がかりを少しずつ注入していく形です。図3がトークナイザー全体の構成を示しています。
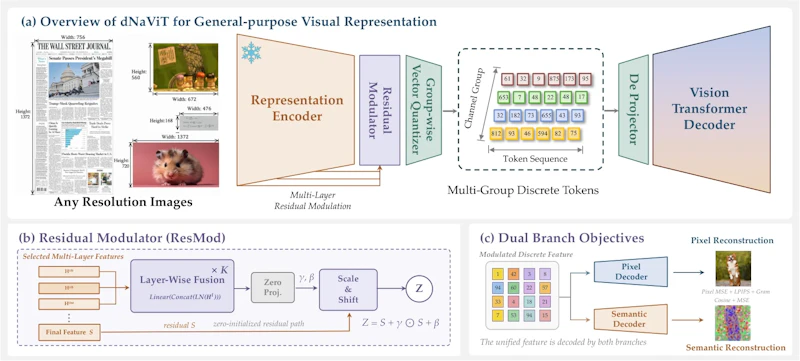
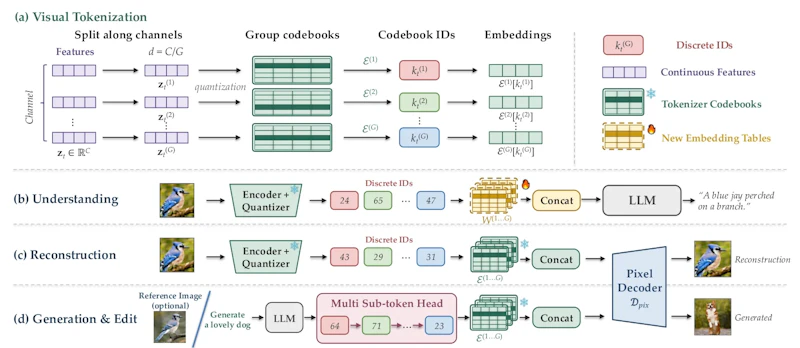
量子化には グループ化 Product Quantization を採用しました。変調後の特徴をチャネル方向に G 個のグループへ分割し、グループごとに専用のコードブックから最も近いエントリを選びます。1つの空間位置は G 個のインデックスの組で表されるため、コード空間はグループ数に対して指数的に広がる一方、空間グリッドの大きさは変わらず系列長は一定に保たれます。論文では G=16 と G=64 を検証し、空間方向のダウンサンプリング係数は 32 としています。
図4は、同じコードが下流タスクごとにどう使われるかを整理したものです。理解タスクではインデックスのみを言語モデルに渡し、グループごとの埋め込みテーブルを言語モデルと一緒に学習します。再構成では凍結したコードブックの埋め込みを連結してピクセルデコーダに入力し、生成と編集では言語モデルの上に多段サブトークン予測ヘッドを置いて各位置のインデックスを予測し、同じコードブックとデコーダで画像に戻します。
学習目標は二枝構成です。意味枝は量子化後の特徴を ResMod の特徴空間に戻すデコーダを置き、コサイン類似度と MSE で元の特徴に揃えます。ピクセル枝は ViT ベースのデコーダで画像を復元し、L1・MSE・LPIPS・ConvNeXt-S による知覚損失・Gram 行列損失を組み合わせます。この2つを同時に最適化することで、高レベルの意味と低レベルの画素情報を1つの離散表現に共存させる狙いです。
さらに、コードを条件とする Refiner も用意されています。事前学習済みの画像生成モデルを土台にした flow matching デコーダで、テキストを使わず離散コードだけを条件にして細部を補います。多ステップの教師モデルを、潜在回帰と stop-gradient 補正、hinge 敵対損失を使って1ステップの生徒モデルへ蒸留する構成です。ただし Refiner の効果は主に定性的な比較で示されており、表形式の定量指標は報告されていません。
3段階の学習手順
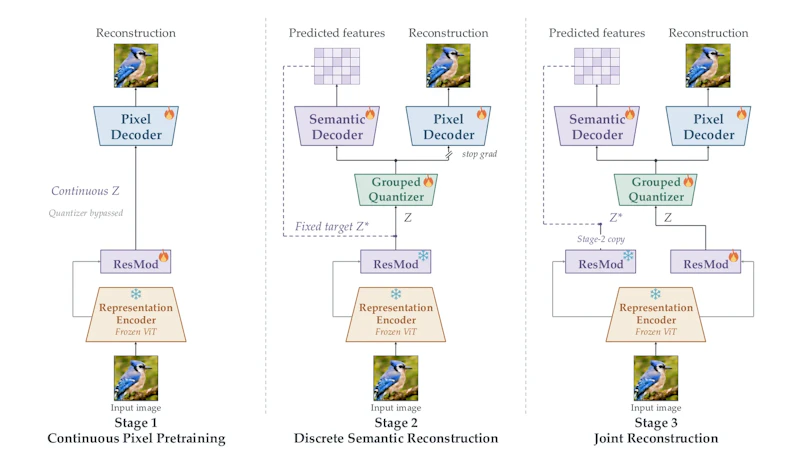
学習は図7のように3段階で進みます。第1段階では量子化を挟まず、ResMod とピクセルデコーダをピクセル損失だけで学習します。第2段階では ResMod を凍結して量子化器と意味デコーダを学習し、ピクセル側には勾配を流さないよう量子化埋め込みで切り離します。
第3段階でこの勾配経路を開き、第2段階の ResMod を凍結したコピーが意味の教師信号を供給しながら、生徒側の ResMod と量子化器をピクセル損失でも更新します。段階を分けることで、意味表現の崩壊と画素再現の不足のどちらにも偏らせない意図が読み取れます。学習データは一般画像・文字の多い文書・細部や美的品質の高い画像を含み、256×256 から始めて最大 2K のネイティブ解像度へ移行し、合計で数千億トークン規模を使ったと報告されています。
実験結果
再構成品質は、グループ数を増やすほど明確に向上しました。ImageNet での PSNR は G64 設定の 1024×1024 で 32.90dB、SSIM は 0.91 に達しています。図9の定性比較では、同じ入力解像度でも量子化後のコードから細部がどこまで戻るかが手法間で大きく異なることが分かります。
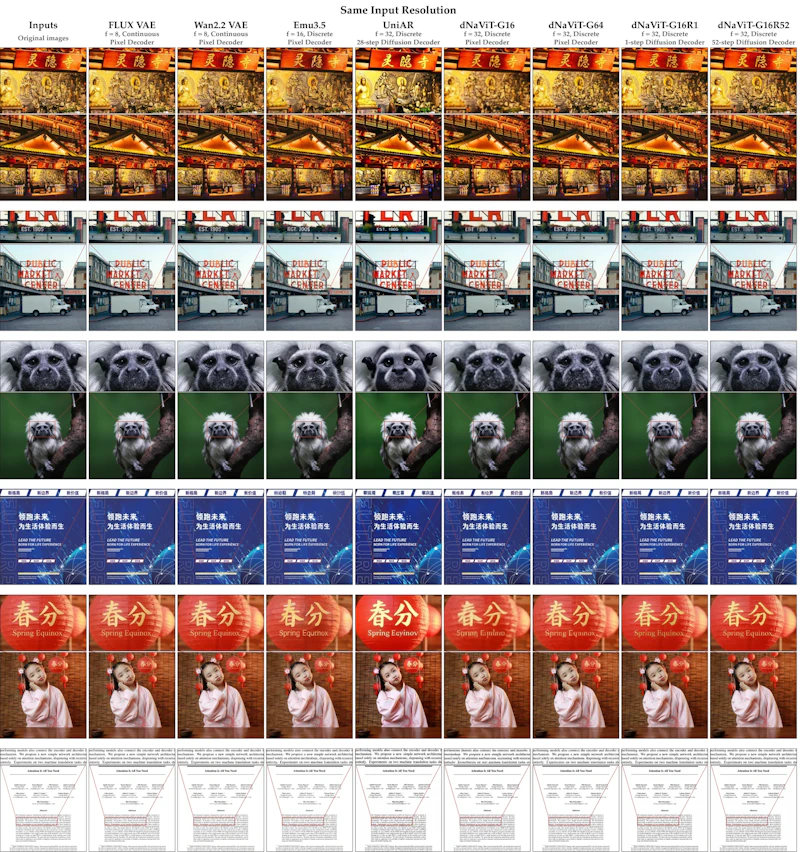
主要な定量結果を整理すると次のようになります。理解タスクは Qwen3-8B を言語モデルに用いた dNaViT-8B の数値です。
領域 | 指標 | dNaViT の結果 |
|---|---|---|
再構成 | PSNR / SSIM(1024²、G64) | 32.90dB / 0.91 |
再構成 | TokBench T-ACC / T-NED | 63.08% / 78.27% |
表現学習 | ImageNet-1K 線形プローブ | 79.47%(連続版 80.40%) |
理解 | OCRBench / DocVQA | 885 / 96.2 |
理解 | MMMU / MathVista | 70.7 / 79.0 |
生成 | GenEval2 GM / QwenImageBench | 49.5 / 52.17 |
編集 | GEdit-Bench(英語)Overall | 7.30 |
注目したいのは線形プローブの差です。離散化によって失われた精度は連続表現比で 0.93 ポイントにとどまり、量子化が意味情報をほとんど壊していないことを示しています。理解系のスコアも Qwen3-VL-8B と同等水準で、著者らが比較した離散トークナイザー系モデルの中では先頭に立っています。
画像生成と編集でも実用的な水準に届いていますが、編集の総合スコア 7.30 は Qwen-Image-Edit の 7.56 や Emu3.5 の 7.59 を下回ります。複数のモダリティを1つの語彙に押し込む設計の代償がここに現れている、と読むのが妥当でしょう。統合型モデルの設計方針としては、WeLM-Image のようにモダリティごとにパラメータを分ける方向もあり、どちらが有利かは今後の比較を待つ必要があります。
残る課題
論文自身が挙げている限界は率直です。比較対象のベースラインは公開報告からの引用であり、学習データや設定、評価手順が揃っていないため、厳密に統制された比較ではありません。G16 と G64 の比較も学習設定と学習期間が異なるため、グループ数だけの効果とは言い切れないと明記されています。
技術面でも課題が残ります。小さな文字の再現は依然として難しく、FLUX.1 のような強力な再構成モデルとの差は埋まっていません。また、離散埋め込みはゼロから学習されるため、連続表現との差を詰めるにはより多くのデータが必要だと、著者らが引用する LongCat-Next のスケーリング分析は示唆しています。ビット予算が増えれば忠実度が上がるとは限らず、グループのインデックスどうしが統計的に独立でない点も指摘されています。
まとめと今後の展望
dNaViT の貢献は、新しい巨大モデルを作ったことではなく、既存の事前学習エンコーダを凍結したまま薄い層と量子化器を足すだけで、離散コードが汎用的な視覚表現として機能することを4領域の実験で示した点にあります。意味理解の精度を 1 ポイント弱の損失で保ちつつ、同じコードから高解像度の画像を復元できるという結果は、理解と生成を分けて設計してきた従来の前提を見直す材料になります。
重みが公開されているため、統合マルチモーダルモデルの基盤部品として検証を始めやすいのも実務上の利点です。編集性能の差や小さな文字の扱いといった弱点がどこまで学習規模と設計の改良で埋まるのかが、この路線の評価を決めることになります。
論文情報: "dNaViT: Discrete Codes are General-Purpose Visual Representations"(Xiaotong Li et al., 2026) arXiv:2611.12426
本記事の図(図3、図4、図7、図9)は解説のため上記論文より引用しています。


