 AI-Papers
- LLMの「推論ループ」修復を、BF16重みの符号反転と指数シフトだけを許す疎な離散最適化として定式化した研究です
- 目的関数を出力行ごとの独立したQUBO(Ising)問題へ分解し、GPU上の焼きなまし系ソルバーで解きます
- Qwen3.5-0.8BのMATH-500精度を7.9%から54.6%へ引き上げ、順伝播4回・約0.9ドルのGPU費用で既存のエージェント編集(51.7%)を上回りました
研究の背景
小規模な推論モデルを数学問題に使うと、同じ計算や言い回しを延々と繰り返して結論に辿り着けない「推論ループ」に陥ることがあります。Qwen3.5-0.8BのMATH-500(高校数学コンテストレベルの問題500問)での正答率はわずか7.9%で、その多くはこの反復によって解答が完結しないまま打ち切られたものでした。
この問題に対し、Takehiらは「weight-space programming」という方針を示しています。最先端のLLMエージェントがモデルの重みを直接読み、勾配を使わずに修復コードを書くというアプローチです。実際にループは緩和されましたが、その代償として158ターンの対話、8970万トークン、50回の順伝播リクエストを要しました。
本研究のTree-Isingは、この修復作業を言語モデルの判断に委ねるのではなく、最適化問題として明示的に書き下すことを狙います。著者はHadi SalloumとAmmar Aliの2名で、2026年11月にarXivで公開されました。
提案手法
Tree-Isingの出発点は、重みを連続値として微調整するのではなく、BF16(16ビットの浮動小数点形式)のビットパターンに対する限られた操作だけを許すという制約です。許容される編集は符号ビットの反転と指数部のシフトに限られ、グループで共有される指数や仮数部はそのまま保たれます。この制約のおかげで、編集は0か1の離散変数で表現でき、元のBF16格納形式を壊さずに済みます。
修復の目標は3つの要素から成り立っています。ループを誘発する方向の寄与を弱め、結論へ向かう方向の寄与を強め、同時に本来うまく処理できていたトークンでの出力を変えないように保つという設計です。この3要素を重み付きの目的関数としてまとめると、各ビットの選択が互いに影響しあう組み合わせ最適化になります。
ここで鍵になるのが分解です。著者らは目的関数が出力行ごとに厳密に独立したQUBO(二次制約なし二値最適化、Ising模型と等価な形式)へ分割できることを示しました。行ごとの問題は互いに干渉しないため、GPU上で並列に解けます。ソルバーには古典的な焼きなまし法と、量子着想型の simulated bifurcation の2種類が使われています。
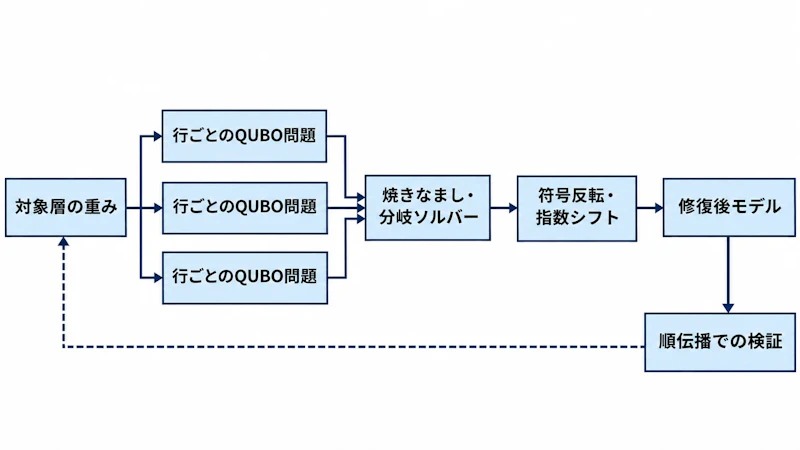
図1のように、処理の流れは重みの取得、行単位の分割、ソルバーによる解探索、ビット編集の適用という順に進みます。編集の強さ(dose)と対象層の選択を確認するために順伝播を数回走らせるだけで、LLMへの問い合わせは一度も必要ありません。勾配を使わずにモデル内部へ介入する研究としては、専門家同士の相互作用を見て枝刈りするHOPEのようなMoE枝刈り手法とも発想の近さがあります。
実験結果
比較対象は、エージェントが編集したものと同じ2層に介入した場合の結果です。MATH-500では焼きなまし版が54.6%、simulated bifurcation版が55.1%に達し、エージェント編集の51.7%を上回りました。5つの数学ベンチマーク全体でも両ソルバーがエージェント編集を超え、MATH-500とGSM8Kでは多重比較補正を行ったうえで統計的に有意な差が確認されています。
手法 | MATH-500 |
|---|---|
Qwen3.5-0.8B(元のモデル) | 7.9% |
エージェント編集(Takehiら) | 51.7% |
Tree-Ising(焼きなまし) | 54.6% |
Tree-Ising(simulated bifurcation) | 55.1% |
編集の「軽さ」でも差が出ています。Tree-Isingが書き換える重みの数はエージェント編集より13〜17%少なく、BF16のビット反転数は2.2〜2.3倍少なく抑えられました。精度を上げるために大量の重みを動かしているわけではない、という点を裏づける結果です。
コスト面の差はさらに大きく、必要な順伝播リクエストは4回、LLMトークンの消費はゼロで、焼きなましの実行にかかったGPU費用は約0.9ドルでした。エージェント編集側は8970万トークンを消費しており、論文の試算では数百ドル規模の費用に相当します。
汎化の確認として、Qwen3.5-2Bに対しても適用されています。対象層と編集の強さを元のモデルだけを見て決めるという条件で、GSM8Kの貪欲デコード精度が21.6%から69.4%へ上昇しました。加えて、8変数に縮小した修復部分問題をQAOA(量子近似最適化アルゴリズム)でIBM Heronプロセッサ上で解く実証も行われています。
限界と課題
一方で、この結果をそのまま一般的なモデル改善手法として読むのは早計です。注意すべき点を整理すると次のようになります。
- 介入対象の2層は先行研究のエージェントが特定したもので、層選択自体の自動化は別の問題として残る
- 検証されたのは0.8Bと2Bという小規模モデルで、大規模モデルでの挙動は未確認
- 評価は数学系ベンチマーク中心で、一般的な言語能力への副作用の検証は限定的
- IBM Heronでの実験は8変数の概念実証にとどまり、精度の数値は示されていない
特に1点目は重要で、Tree-Isingが解いているのは「どこを直すか」が与えられた後の「どう直すか」の部分です。元のモデルだけから層と強さを選んだQwen3.5-2Bの実験はこの懸念に答えようとする試みですが、より広い条件での再現が必要でしょう。
まとめと今後の展望
Tree-Isingの意義は、モデル修復という曖昧な作業を、解が検証できる離散最適化問題として書き直したところにあります。LLMエージェントに重みの編集を任せる方式と比べ、何を最適化しているかが明示され、費用も3桁近く下がりました。
QUBOへの分解が成立するという性質は、焼きなまし、simulated bifurcation、量子アニーリング、ゲート型量子計算といった既存のIsingソルバー群をそのまま持ち込めることを意味します。小規模モデルであれば数ドル以下で追試できるため、手元のGPUで検証したい研究者にとっても現実的な選択肢になりそうです。層選択まで含めた自動化と、大規模モデルへの拡張が次の焦点になります。
論文情報: "Tree-Ising: Repairing Language Models with Bit-Level Ising Edits"(Hadi Salloum, Ammar Ali, 2026) arXiv:2611.14210


