 AI-Papers
- 量子化したLLMエージェントは、タスク要件や環境条件を見落として行動が全精度モデルの軌跡から逸脱することを分析で特定
- 全精度の教師が生徒の失敗応答を実行フィードバックで反復修正する閉ループ蒸留により、W4A16でBF16との平均差を1ポイント以内に抑制
- τ²-Benchでは学習GPU時間を67%削減しつつQeRLを上回り、成功軌跡の出力トークン数も短縮
研究の背景
Large Language Model(LLM)をエージェントとして動かすとき、推論コストは運用上の大きな制約になります。重みを4ビット、活性値を16ビットに落とす W4A16 のような低ビット量子化はメモリと計算量を大きく削れるため、ローカル環境やエッジでの運用を現実的にする手段として広く使われてきました。
ところが単純な量子化では、対話的なエージェントタスクの成功率が目に見えて落ちます。清華大学などの研究チームによる論文「SteerDistill: Quantizing LLM Agents via Closed-Loop Teacher Steering」(arXiv:2611.13410)は、この劣化がどこで起きているのかを特定し、それを埋めるための蒸留手法を提案しています。
単発の質問応答と違い、エージェントは複数ターンにわたってツールを呼び、環境の状態を書き換えながら進みます。1ターンの小さな判断ミスがそのまま後続の状態に残るため、わずかな精度低下が最終的な成功率に大きく響く構造になっています。
量子化エージェントの失敗
研究チームはまず、量子化モデルの失敗軌跡を全精度モデルの成功軌跡と環境状態で突き合わせ、何が起きているかを調べました。見えてきたのは、推論能力そのものが壊れるのではなくタスク要件や環境条件の見落としが中心だという傾向です。
論文が挙げる例は具体的です。必要なディレクトリに移動する前にファイルを読もうとする、ファイルを作りはするが一部を空のまま残す、欠けている情報を取得する前に存在しない経路名や会社名を勝手に前提にして動き出すといった振る舞いです。いずれも手順の一部が抜け落ち、環境遷移が成功軌跡から外れていきます。
問題は、この失敗を直す学習データが手に入りにくい点にあります。既存のオフラインデータには生徒モデルが実際につまずいた文脈が含まれていません。かといって生徒自身にやり直させても、逸脱したターンで正しい行動を出せる確率は低いままです。BFCL V4 の多ターン診断では、誘導なしの再試行で正解に辿り着けたのは逸脱ターンのうち9.6%(Pass@4)にとどまりました。
SteerDistillの仕組み
提案手法は、この穴を教師モデルによる介入で埋めます。学習は1サイクルが2段構えになっており、図2がその流れを示しています。
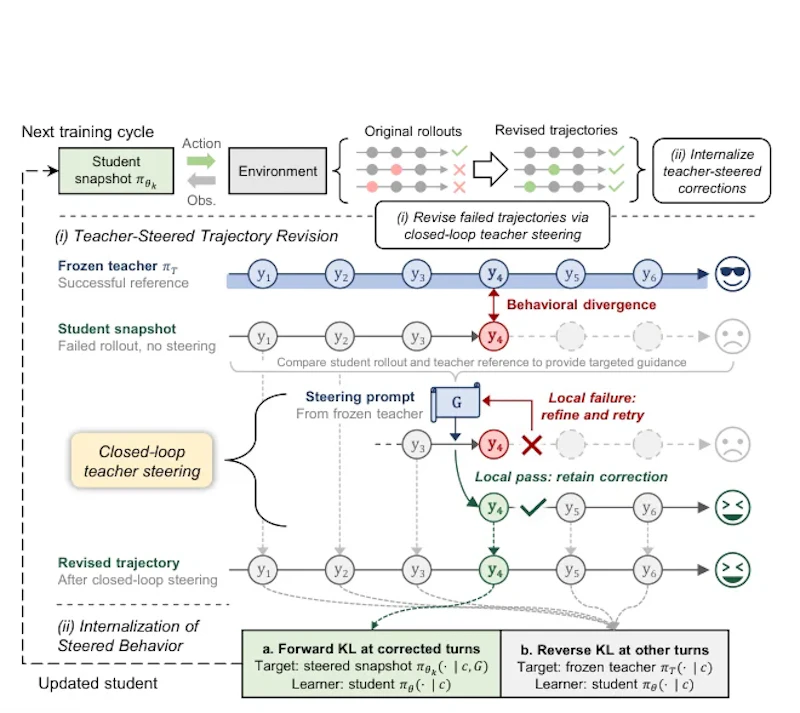
前半は修正データの生成です。失敗した生徒の軌跡を教師の成功軌跡と環境状態で対応づけ、最初に行動が分岐した地点を介入点とします。そこで教師が、どこがどう食い違っているか、どの条件で適用されるか、どう直すべきかを含む構造化された誘導プロンプトを書きます。生徒(重みは固定)はエラー直前の履歴と環境状態を復元した状態から応答を書き直します。
書き直した応答は局所検証にかけられます。その行動によって生じた環境遷移が教師の成功軌跡の遷移と一致するかを確認する仕組みです。一致しなければ教師が実行フィードバックを踏まえて誘導を練り直し、同じ地点から最大4回まで再挑戦します。検証を通った修正だけが残され、その先は誘導なしでロールアウトを続けます。この閉ループ誘導によって、逸脱ターンで正しい行動が得られる割合は9.6%から82.3%へ上がりました。
後半は、得られた修正を生徒に埋め込む学習です。ここでの学習器には誘導プロンプトを一切与えません。修正されたターンでは誘導を受けた生徒(steered snapshot)の予測を、それ以外のターンでは全精度教師の予測を目標にします。前者には順方向KL、後者には逆方向KLを使い分けており、この割り当てを逆にすると BFCL V4 のスコアは46.84から44.28へ下がりました。推論時には誘導なしで動くため、運用時に教師モデルを並走させる必要はありません。
実験結果
評価は BFCL V4、τ²-Bench、WebShop、ALFWorld、Search QA の5つのエージェントベンチマークと、Qwen3-8B、Qwen3.5-4B、Gemma 4 12B-it の3モデルで行われました。いずれも W4A16 量子化です。
モデル | 手法 | BFCL V4 | τ²-Bench | WebShop | ALFWorld | Search QA | 平均 |
|---|---|---|---|---|---|---|---|
Qwen3-8B | BF16 | 46.89 | 32.64 | 68.58 | 79.92 | 39.65 | 53.54 |
GPTQ | 40.73 | 26.85 | 59.24 | 71.32 | 33.64 | 46.36 | |
QeRL | 44.91 | 29.84 | 65.29 | 77.04 | 37.94 | 51.00 | |
SteerDistill | 46.84 | 31.79 | 68.41 | 79.75 | 39.12 | 53.18 | |
Qwen3.5-4B | BF16 | 50.40 | 62.80 | 69.80 | 78.60 | 46.80 | 61.68 |
QeRL | 48.53 | 60.31 | 66.73 | 75.63 | 45.01 | 59.24 | |
SteerDistill | 49.82 | 61.91 | 69.08 | 77.82 | 46.11 | 60.95 | |
Gemma 4 12B-it | BF16 | 64.18 | 61.46 | 72.41 | 84.63 | 42.96 | 65.13 |
QeRL | 62.41 | 59.02 | 69.33 | 81.35 | 41.07 | 62.64 | |
SteerDistill | 63.54 | 60.72 | 71.38 | 83.62 | 42.31 | 64.31 |
最も強い量子化ベースラインは3モデルいずれも QeRL でしたが、SteerDistill はそれを平均1.67〜2.18ポイント上回りました。BF16 との差は Qwen3-8B で0.36ポイント、Qwen3.5-4B で0.73ポイント、Gemma 4 12B-it で0.82ポイントと、すべて1ポイント以内に収まっています。Qwen3-8B では EfficientQAT(47.87)、BitDistiller(48.49)、On-Policy QAD(50.38)も比較対象になっており、既存の量子化対応蒸留より差が明確です。
学習コストの面では、Qwen3-8B の τ²-Bench で SteerDistill が32 GPU時間の時点で成功率31.68%に達しました。96 GPU時間を費やした QeRL の29.84%を1.84ポイント上回る水準で、GPU時間は67%少ない計算になります。学習を最後まで回した場合のスコアは上の表の31.79%で、QeRL との差は1.95ポイントに広がります。つまり1.84ポイントは同一到達点を早期チェックポイントで比べた値、1.95ポイントは学習完了後の最終値です。
推論時の効率にも違いが出ています。成功したタスクの平均出力トークン数は SteerDistill が4.0K で、量子化ベースラインの4.1K〜5.2K より短く、BF16 の3.9K に近い値です。無駄な試行錯誤が減っていることを示す結果と言えます。アブレーションでは局所検証を外すと BFCL V4 が46.84から42.18へ落ち、介入点をランダムに選ぶと43.52、教師にターンごと代行させると45.06でした。どこで介入し、その結果を環境遷移で確かめることが効いていると読めます。
限界と今後の展望
論文は適用条件の制約を明示しています。手法が成立するには、教師側に成功軌跡が存在し、エラー直前の履歴と環境状態を復元できて、局所検証が信頼できる必要があります。
- 成功した教師軌跡がない失敗ロールアウトは、蒸留データとしては残るが修正は得られない
- 状態復元ができない環境や検証が信頼できない環境での有効性は未検証
- 局所検証はその場の行動の効果を確認するだけで、最終的なタスク成功や推論過程全体の正しさは保証しない
この3点目は運用時の見積もりに関わります。検証を通った修正でも、最終成功まで要求する条件に変えると BFCL V4 は46.30へわずかに下がったと報告されており、局所的な正しさと最終成功は必ずしも一致しません。
量子化は推論時の数値表現を削る操作であり、モデルの振る舞いにどう波及するかは単純な精度指標だけでは見えにくい領域です。BF16のビット編集でLLMの推論ループを修復する研究のように、ビット表現と出力挙動の関係を扱う研究が増えてきました。SteerDistill は、その関係をエージェントの環境遷移という観測可能な単位で捉え直し、劣化した箇所だけを狙って直すという方向を示しています。状態復元や検証が難しい実環境へどこまで広げられるかが、次の焦点になりそうです。
論文情報: "SteerDistill: Quantizing LLM Agents via Closed-Loop Teacher Steering"(Genming Cui et al., 2026) arXiv:2611.13410, CC BY 4.0
本記事の図(図2)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


