 AI-Papers
- Amazonが、Mixture-of-Experts(MoE)モデルの専門家を削除する二次手法「HOPE」を公開しました
- 専門家を個別に採点する従来手法と異なり、専門家ペアの協調関係を行列として扱い二次計画で削除対象を選びます
- Qwen3.5-35B-A3Bの50%枝刈りでSWE-Bench Pro 42.3と、無枝刈りの41.8をわずかに上回りました
95%がMLPという現実
Amazonが2026年11月9日、MoEモデルから専門家(expert)を削除する手法「HOPE(Higher-Order Pruning of Experts)」をHugging Faceのブログで公開しました。コードはGitHubのawslabs/HOPEで配布され、論文はarXivに掲載されています。
MoEは入力トークンごとに一部の専門家だけを動かす仕組みですが、動かさない専門家もメモリ上に常駐させる必要があります。Qwen3.5-122Bは48層のMoE層それぞれに256個の専門家を持ち、1層あたり同時に動くのは8個だけです。それでも専門家のMLPが約250GBのモデル容量の95%を占めます。
枝刈り(pruning)は専門家を恒久的に削除する方法で、追加学習が不要なうえ、専門家を動的にロードする方式で生じる遅延も避けられます。量子化との併用も可能です。空いたメモリは、長い文脈や深い推論、ツール呼び出しの増加に回せます。
相互作用行列と二次計画
HOPEの中心は、専門家の重要度を単独で測らないことにあります。まずキャリブレーションデータに対して1回の順伝播を行い、専門家の選択履歴、ゲート重み、出力ノルム、そしてペアごとの同時活性化統計を記録します。
次に、枝刈りによる誤差の主要項を上から押さえる代理目的Zを定義します。その二乗和を展開すると専門家ペアの交差項が現れますが、従来の一次手法はこの項を捨てていました。HOPEはこれを E×E の行列 F として残し、削除する専門家数を固定した制約の下で pTF p を最小化する二値の最適化問題を解きます。
行列Fの対角成分は個々の専門家の重要度を表し、非対角成分は専門家どうしの協調の強さを表します。連続緩和して解き、二値に丸めるまでの計算は1層あたり1〜2秒で、キャリブレーションの負荷に比べれば無視できる水準です。
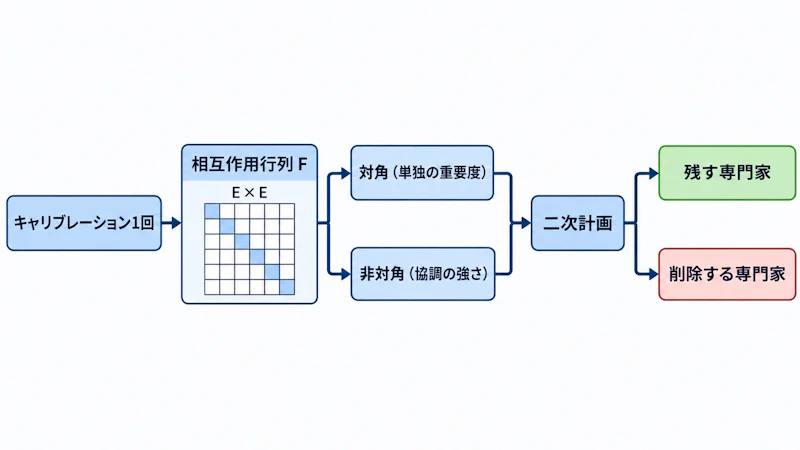
図1のように、既存手法REAPの評価軸は行列Fの対角成分に相当します。実際、対角のみで並べた順位はREAPの順位とほぼ一致しました(Spearmanの順位相関 0.988)。つまりHOPEがREAPを上回る分は、すべて非対角の相互作用項から来ていることになります。MoEの専門家が何に特化しているかという分析ではSAE Interprets MoEのような研究もありますが、HOPEは特化そのものより専門家の組み合わせを重視した設計です。
50%削減時の評価結果
評価にはQwen3.5-122B、Qwen3.5-35B、GLM-4.5-Air(128専門家、総パラメータ106B)を使い、キャリブレーションにはEvol-CodeAlpacaとSWE-Bench Verifiedの軌跡を用いました。比較対象はREAP、MAN、EAN、Frequencyの4手法で、枝刈り率は10%から50%までを試しています。
全条件での平均順位は5手法中2.07で、39%の条件で1位、67%の条件で2位以内に入りました。差が最も開くのは枝刈り率50%の領域で、HOPEの平均順位1.58に対し次点のREAPは2.42でした。エージェント型のコーディングタスクでは、次点手法に対して最大6.1%の差が付いています。
Qwen3.5-35B-A3Bを50%枝刈りし、SWE-Bench Proで測った結果が下の表です。
条件 | SWE-Bench Pro |
|---|---|
枝刈りなし | 41.8 |
HOPE(50%削減) | 42.3 |
REAP(50%削減) | 36.2 |
専門家を半分削っても無枝刈りをわずかに上回る一方、REAPでは13%の性能低下が生じています。残された専門家を調べると、HOPEだけが残した専門家はREAPだけが残した専門家より協調スコアが高く、単独では高得点の専門家をあえて捨てて協調クラスタを守る挙動が確認されました。コード中心のキャリブレーションを使ってもTulu3スイートの成績は大きく崩れず、キャリブレーションデータの選択に対しても安定していたと報告されています。
使い方と残された課題
hopeパッケージはhope calibrate、hope solve(--prune-fracで削除率を指定)、hope pruneの3段階で動きます。Qwen3、Qwen3-Next、Qwen3.5、GLM-4.5で検証済みで、出力は通常のHugging Faceチェックポイントのため、vLLMやSGLangをそのまま利用できます。Python APIも用意されています。
制約もあります。枝刈り率が10〜20%と低い領域ではREAPやMANが競合する場合があり、優位性は縮まります。また各層を独立に枝刈りする設計で、層をまたぐ版は予備的な記述にとどまります。モデル化しているのはペアまでの相互作用で、3つ以上の組み合わせは扱っていません。ブログではメモリ使用量やスループットの実測値も示されていないため、運用効果の確認は利用側の検証に委ねられます。


