 AI-Papers
- FLUX.1-devとQwen-Imageを追加学習なしで最大10倍高速化し、GenEvalスコアの品質劣化を1%以内に抑制
- 低解像度生成→GAN超解像→ノイズ注入→高解像度精細化の4段階パイプラインで、潜在空間アップサンプリングのアーティファクトを根本的に回避
- 既存の蒸留手法(Pi-Flow)と組み合わせると最大25.1倍の高速化を達成し、FLUXの実運用コストを大幅に削減可能
研究の背景と課題
Flow Matching(フローマッチング)とは、ノイズから画像へのパスを連続的な確率フローとして学習する生成モデルの手法で、FLUX.1-devやQwen-Imageといった最先端の画像生成モデルに採用されています。高品質な1024×1024ピクセルの画像を生成するには多数の推論ステップが必要で、GPUコストが実運用上の障壁になっていました。
既存の高速化アプローチとして、低解像度で画像の大まかな構造を生成してから潜在空間(VAEの内部表現)でアップサンプリングする手法が提案されています。しかし、潜在空間での直接的な拡大処理は規則的なグリッド状のアーティファクト(格子模様のノイズ)を生じさせ、画質を大きく損なうという根本的な問題がありました。
MrFlowはこの課題に対して、追加学習を一切必要とせず、既存モデルをそのまま利用できる段階的パイプラインで取り組みます。
MrFlowの4段階パイプライン
MrFlow(Multi-Resolution Flow Matching)の設計の核心は、超解像をピクセル空間で行うことと、低強度ノイズ注入で高周波情報を補完する点にあります。
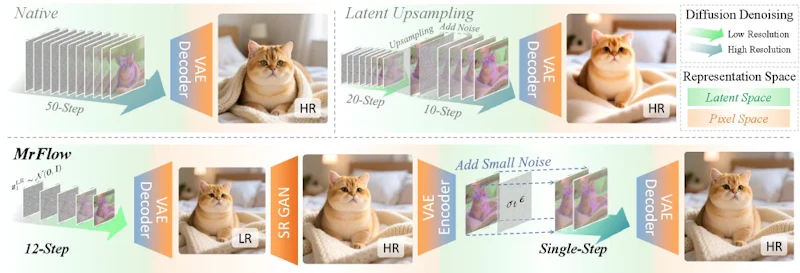
パイプラインは次の4段階で構成されます。
- 第1段階(低解像度生成): 512×512ピクセル相当の低解像度潜在空間でFLUXのODEサンプリングを12ステップ実行し、構図・色調・オブジェクト配置といった大域的な構造を高速生成する
- 第2段階(GAN超解像): 低解像度の潜在表現をVAEでピクセル空間に復元し、Real-ESRGANという軽量な超解像モデルで2倍に拡大する
- 第3段階(ノイズ注入): 超解像後の画像を再び潜在空間に変換し、強度σが0.1〜0.15という低レベルのノイズを付加する
- 第4段階(高解像度精細化): 1ステップの高解像度デノイジングで最終調整を行う
第1段階では解像度が4分の1になるため、1ステップあたりの計算量も大幅に削減されます。第2段階で潜在空間ではなくピクセル空間を拡大の場に選んだことが、既存手法のグリッドアーティファクトを根本から回避する鍵になっています。
第3段階のノイズ注入は、高周波成分(テクスチャ・エッジ・細部の情報)の再サンプリングを促しながら、第1段階で形成された低周波の大域構造を保持する狙いがあります。論文内の周波数帯域分析では、高周波ノイズは後工程で修正できるが低周波ノイズは修正不可能(距離0.498)という知見が示されており、これが低強度ノイズを選ぶ根拠となりました。第4段階がわずか1ステップで済むのも、直前のノイズ注入によって高周波情報の補完条件が整っているためです。
実験結果と他手法との比較
FLUX.1-devとQwen-Imageを対象に、複数の追加学習不要な加速手法との比較実験が行われています。
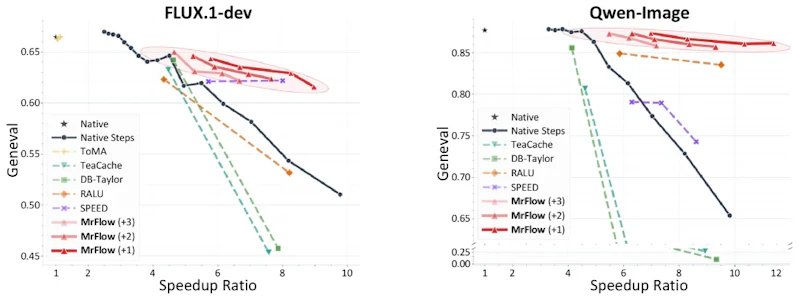
追加学習不要な設定の12+1ステップ構成(低解像度12ステップ+高解像度1ステップ)と、蒸留ベースの加速手法Pi-Flowを組み合わせた設定の結果は次の表のとおりです。
設定 | モデル | 高速化倍率 | GenEval |
|---|---|---|---|
追加学習不要(12+1ステップ) | FLUX.1-dev | 8.25倍 | 0.63 |
追加学習不要(12+1ステップ) | Qwen-Image | 10.3倍 | 0.86 |
Pi-Flow併用 | Qwen-Image | 最大25.1倍 | 0.85 |
Qwen-Imageの追加学習不要な設定では、OneIG-Enでも0.52を記録しました。潜在空間でアップサンプリングを行う競合手法(LSSGen、RALU、SPEED)と比べると、品質と高速化倍率の両面で優位性が確認されています。
Pi-Flowと組み合わせた場合、元モデルのスコア(0.86)との差は1.2%程度にとどまり、実用上ほぼ無視できる劣化と言えます。
まとめと今後の展望
MrFlowは、FLUXなどFlow Matchingベースのモデルをファインチューニングなしで大幅に高速化できる、即日適用可能なフレームワークです。ピクセル空間での超解像と低強度ノイズ注入という2つのシンプルな操作で、潜在空間アップサンプリングという既存手法の根本的な弱点を回避した点に本質的な貢献があります。
生成AIモデルの推論コスト削減は実運用上の重要課題であり、動画生成の提供コストを37%削減したTurboServeのようなシステム側のアプローチと並んで、MrFlowはモデルアルゴリズム側から同じ課題に取り組みます。
コードはGitHubで公開済みで、FLUX.1-devを実運用しているサービスや研究グループは追加学習なしで即座に試せます。今後は動画生成モデルへの適用や、超解像モジュールをDiffusionベースの手法に置き換えた際の品質向上も期待されます。
論文情報: "Multi-Resolution Flow Matching: Training-Free Diffusion Acceleration via Staged Sampling"(Xingyu Zheng et al., 2026) arXiv:2607.01642
本記事の図(図1〜図2)は解説のため上記論文より引用しています。


