 AI-Papers
- 1枚の画像からの新視点合成で、従来の3DGSが依存するピクセル整列表現を表面整列表現へ転換し、大きな視点変化でも構造の破綻を抑えます
- 深度から表面レイアウトを推定する幾何ガイド付きサンプリングと、クエリ条件付きの暗黙デコーダで、固定ピクセルグリッドからガウス予測を切り離します
- 合成室内データのみで学習しながら4つの実世界データセットでSOTAを達成し、撮影画像へのゼロショット汎化も示しました
研究の背景
1枚の写真から、別の角度から見た様子を作り出す技術を新視点合成と呼びます。近年は3D Gaussian Splatting(3DGS、点群状のガウス分布で3Dシーンを表す表現手法)が高速かつ高品質な描画で注目を集めてきました。
ただし単一画像からガウスを予測する従来のフィードフォワード手法には、共通した弱点がありました。入力画像の各ピクセルにガウスを1つずつ割り当てる「ピクセル整列表現」に頼っている点です。ピクセルという2次元の格子にガウスが縛られるため、視点を大きく動かすと、本来つながっているはずの面が裂けたり、ひび割れのような穴が生じたりします。
InfiniSplatは、この制約を根本から見直した手法です。中国の浙江大学などの研究チームが提案し、SIGGRAPH Asia 2026(ジャーナルトラック)に採択されました。3D生成の統合基盤モデルであるHunyuan3D-Buffaloのような生成寄りの研究とは異なり、既存の1枚の画像を忠実に再構成し、そこから広い視点移動を可能にする点に主眼を置いています。
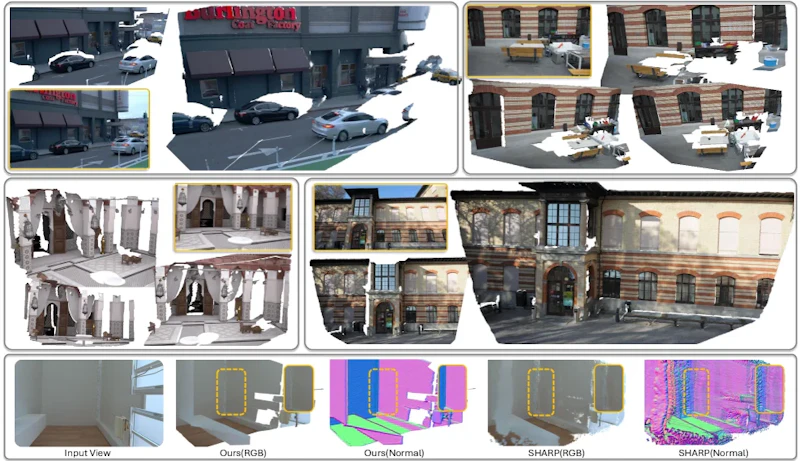
ピクセルから表面へ
InfiniSplatの中心となる考え方は、ガウスを配置する基準をピクセルグリッドから「シーンの表面」へ移すことです。研究チームはこれを表面整列表現(surface-aligned representation)と呼びます。固定された格子ではなく、物体の面の形に沿ってガウスを並べるため、格子の離散化によって散らばる無駄な点が減り、視点を動かしても面のつながりが保たれます。
この表現を実現する仕組みは、大きく3つの要素で構成されます。1つ目は幾何ガイド付きサンプリングです。まず単眼深度推定モデルのDepthProで入力画像から深度を推定し、そこから局所的な表面の向きや広がりを求めます。深度から得た小さな三角形パッチの面積に応じて、面が広い場所には多く、狭い場所には少なくサンプル点を配置します。これによりピクセル格子を超えた位置にもガウスの土台(サポート)を置けます。
2つ目は画像特徴の二系統エンコーダです。DINOv3のViT-L/16が意味的な文脈を、128チャンネルのCNNが低レベルな見た目や境界の細部をそれぞれ抽出します。3つ目がクエリ条件付きの暗黙デコーダで、各サポート位置で両系統の特徴を参照し、ゲート付き融合で文脈と細部のバランスを取りながら、ガウスの属性を予測します。
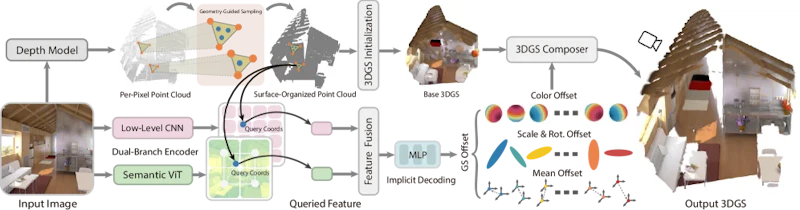
基礎となるガウスは、深度を逆投影した位置と、入力画像から直接サンプリングした色で初期化します。デコーダはこの初期値に対して、位置や色、スケール、回転、不透明度への「範囲を制限した更新量」を予測します。更新量に上限を設けることで、学習が暴走せず安定した表現が得られます。さらにスケールを対数で-8から-3の範囲に収める制約と、隣り合うサポート間で属性が急変しないようにする滑らかさの正則化を加え、透けたり不安定になったりする劣化を防いでいます。
実験結果
学習には室内の合成データセットHypersimのみを使い、1枚あたり150万個のガウスサポートで訓練します。評価は学習に使っていない4つの実世界データセット(ETH3D、ScanNet++、Tanks-and-Temples、DL3DV)で行い、それぞれカメラの移動量が0から無限大まで幅広く含まれる512組の入力ペアを用います。
RGB入力のInfiniSplatは、4データセット平均でPSNR 20.394、SSIM 0.806、LPIPS 0.277を記録しました。比較対象の代表手法SHARPに対して、PSNRで1.919、SSIMで0.048の改善を示し、LPIPSを0.022低減しています。大きな視点変化の下でも、平面の広い領域や物体の境界でひび割れが減り、より一貫した構造を保っている点が特徴です。
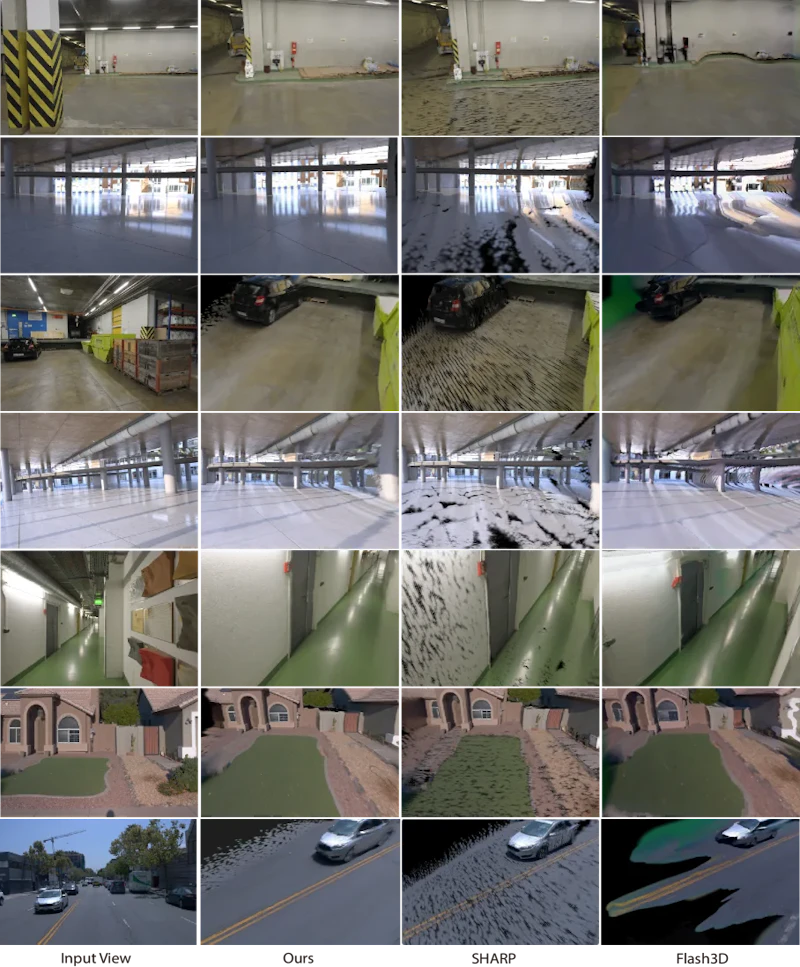
疎なLiDAR点群を追加入力として使うInfiniSplat-LiDARでは、平均PSNR 22.548、SSIM 0.851、LPIPS 0.225とさらに向上します。自動運転向けの手法ADGaussianと比べると、PSNRで10.299、SSIMで0.212もの大差をつけ、LPIPSを0.193改善しました。以下に主要な数値をまとめます。
手法 | PSNR | SSIM | LPIPS |
|---|---|---|---|
InfiniSplat-RGB | 20.394 | 0.806 | 0.277 |
SHARP(RGB比較) | 18.475 | 0.758 | 0.299 |
InfiniSplat-LiDAR | 22.548 | 0.851 | 0.225 |
アブレーション(構成要素を1つずつ外す検証)では、各部品の役割が明確に現れました。学習による更新を外すと粗い構造は残るものの、ぼやけて局所的な質感が失われます。CNN系統を外すと境界の細部が弱まり、DINO系統を外すと意味的な骨格を失って大きな穴が生じるなど、致命的に破綻しました。幾何ガイド付きサンプリングをピクセル整列のサポートに置き換えると、視点変化の下でひび割れが再発します。
汎化性能と限界
室内の合成データだけで学習したにもかかわらず、InfiniSplatは屋外や複雑な照明を含む撮影画像に対してもゼロショットで高い再構成品質を示しました。学習データの分布から離れた実世界のシーンへ、追加学習なしで適用できる点は実用面で重要です。
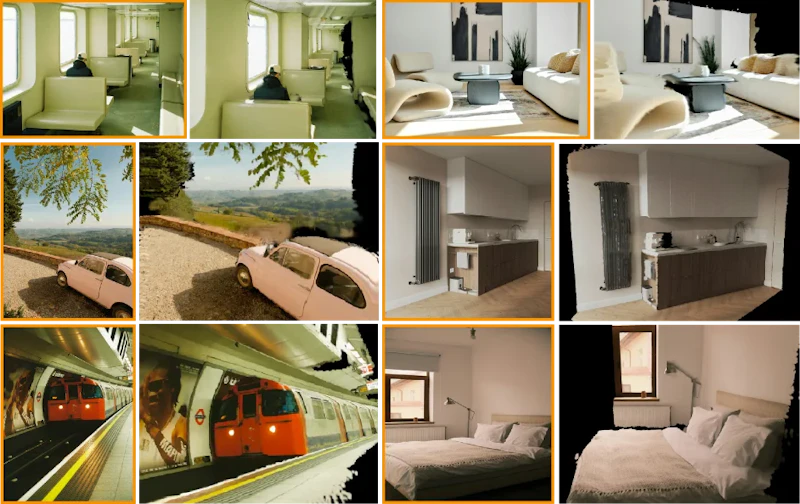
一方で課題も残ります。大きな遮蔽の解消(元の視点では隠れていた領域が新しい視点で見える場合)、深度推定の誤りが混入した場合、そして極端な外挿では、幾何が欠けたり構造が歪んだりします。反射面や透明な物体、深度が急に途切れるシーンも苦手です。これらは深度事前情報や見えていない部分の補完という、単一画像からの再構成に共通する根本的な難しさを反映しています。
まとめと今後の展望
InfiniSplatは、単一画像からの新視点合成で長く前提とされてきたピクセル整列表現を、深度から導く表面整列表現へと転換した手法です。幾何ガイド付きサンプリングとクエリ条件付き暗黙デコーダにより、ガウス予測を固定格子から切り離し、大きな視点変化に耐える描画を実現しました。
合成データのみの学習で実世界へゼロショット汎化し、フィードフォワード手法としてSOTAを達成した点は、少ない入力から3Dシーンを扱う研究の方向性を広げます。コードはGitHubで公開されており、再現や応用が進めやすい環境が整っています。遮蔽の補完や深度誤りへの頑健性が今後の焦点になると考えられます。
論文情報: "InfiniSplat: Implicit Gaussian Decoding for Large-Baseline Monocular View Synthesis"(Jiawei Wang et al., 2026) arXiv:2608.02437
本記事の図(図1、図2、図3、図6)は解説のため上記論文より引用しています。


